LLM 评估的四大主流方法:从基准到自评
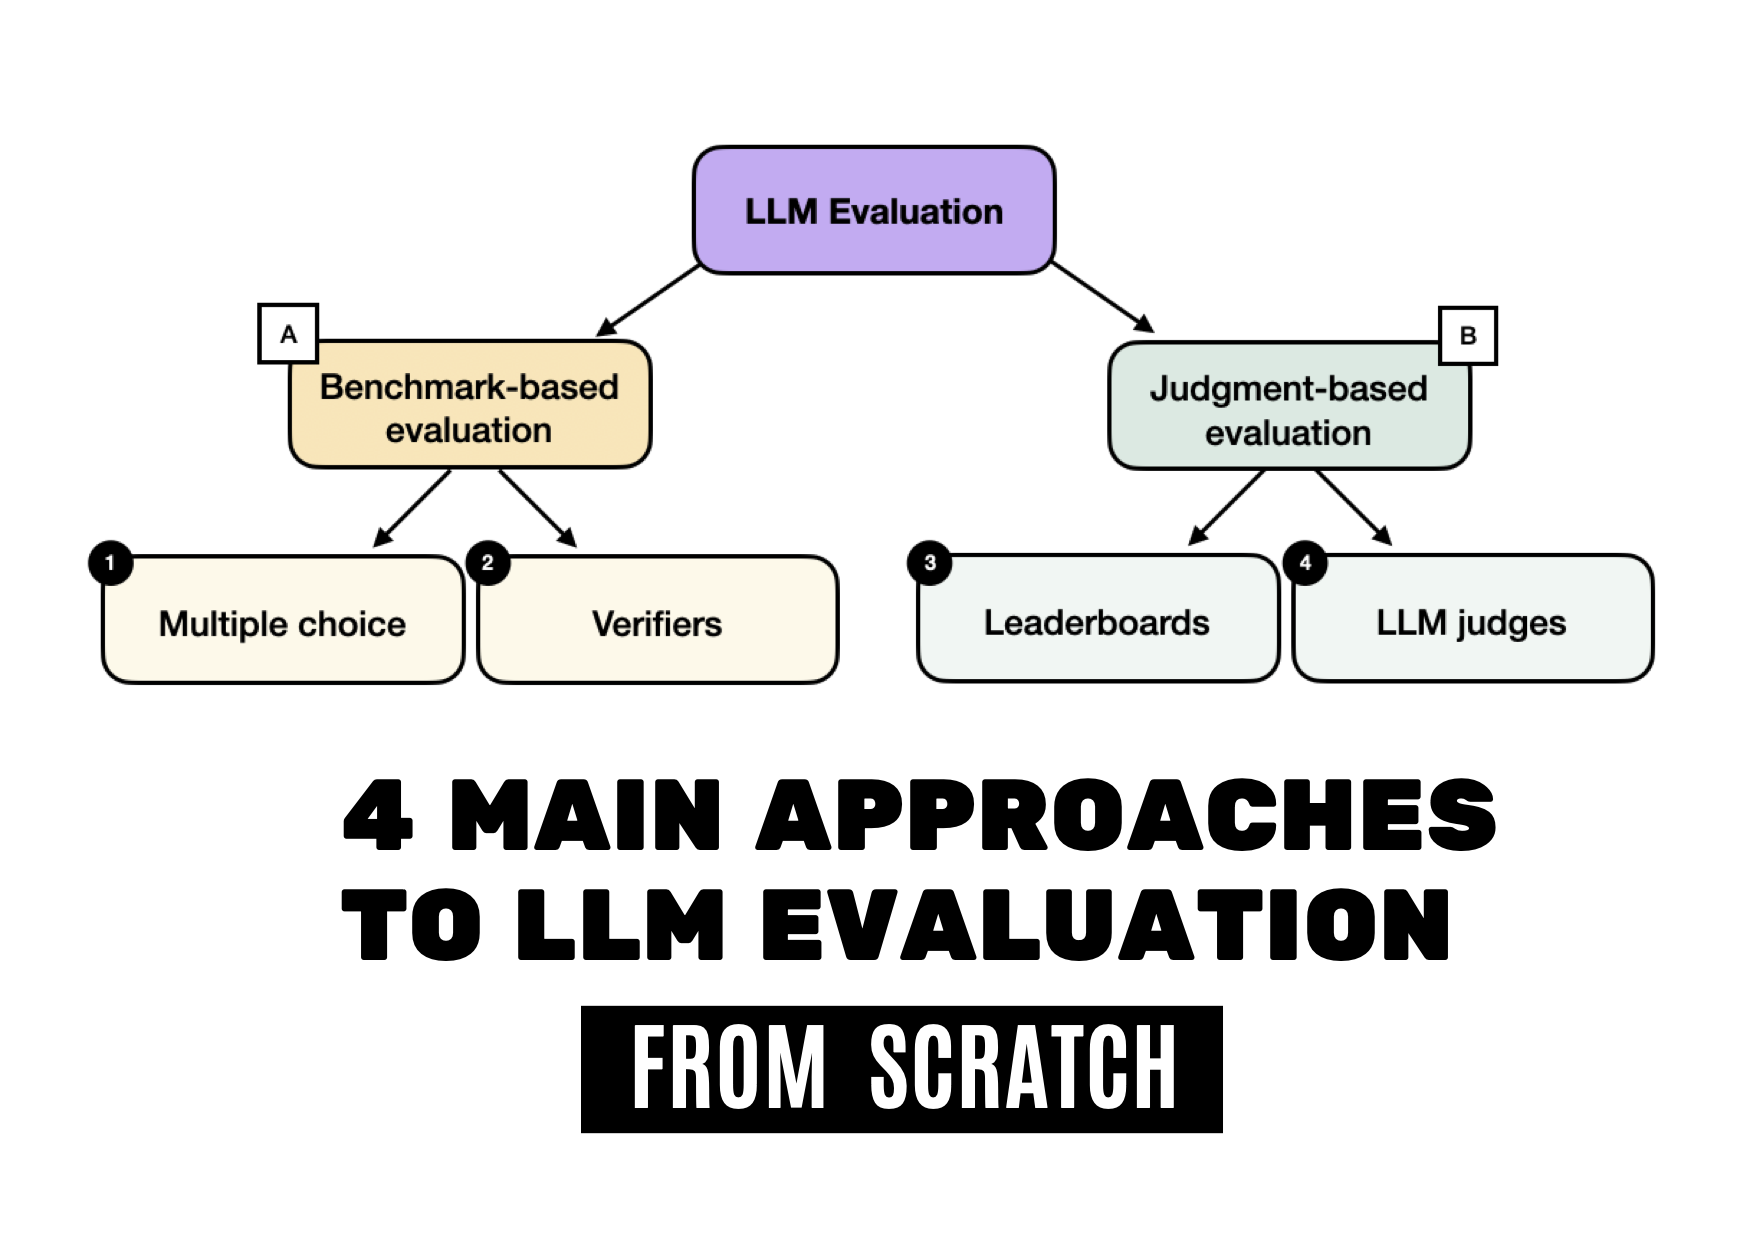
本文解析 Sebastian Raschka 提出的 LLM 评估四大途径,包括多选题、验证器、排行榜和 LLM 评判员,帮助开发者建立评估心智模型。
LLM 评估的四大主流方法:从基准到自评
在开发或使用大语言模型时,如何量化其性能?这是一个看似简单却极其复杂的问题。作为资深开发者,我们常面临两个核心困惑:如何在不同模型间做出选择?以及如何解读公开的评估结果?
为了解决这些问题,Sebastian Raschka 博士提出了一套系统的评估方法论。掌握这些方法的分类与逻辑,能帮助我们建立清晰的“评估心智模型”,从而更准确地解读基准测试、排行榜和技术报告。
四类评估方法的分类
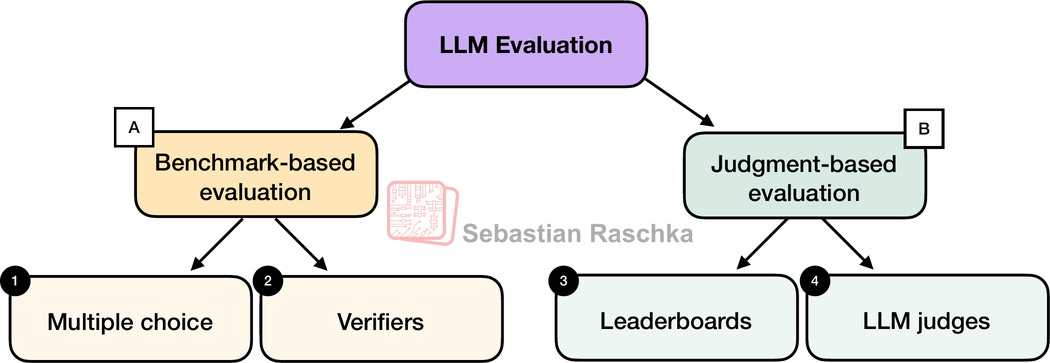
在实际应用中,评估 LLM 主要分为两大阵营:基准测试 和 评判机制。
- 基准测试:通过标准化的测试集(如 MMLU)来衡量模型的准确率。
- 评判机制:使用人工或 AI 来对模型的输出质量进行主观或客观的评价。
Raschka 博士总结了以下四种具体的评估方式,它们往往在研究论文和模型卡片中交织出现。
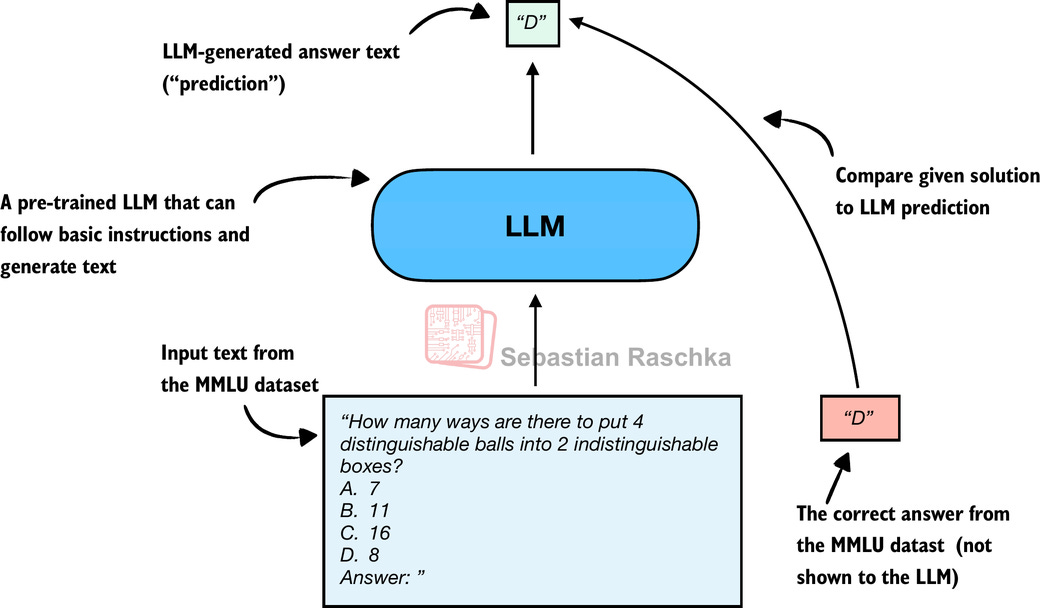
1. 多选题基准测试
这是最传统且最广泛使用的评估方法。
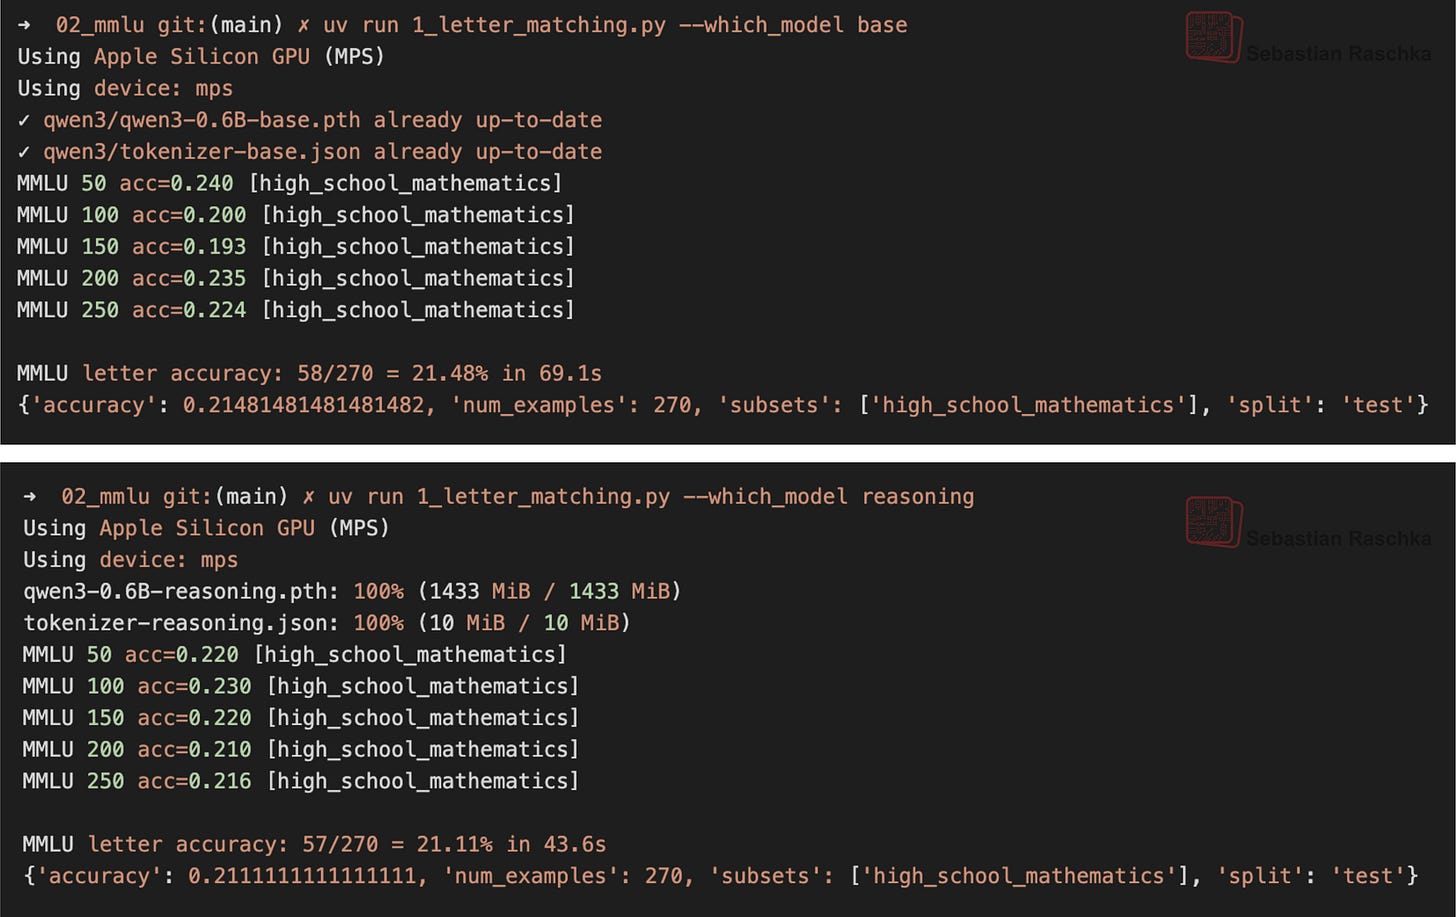
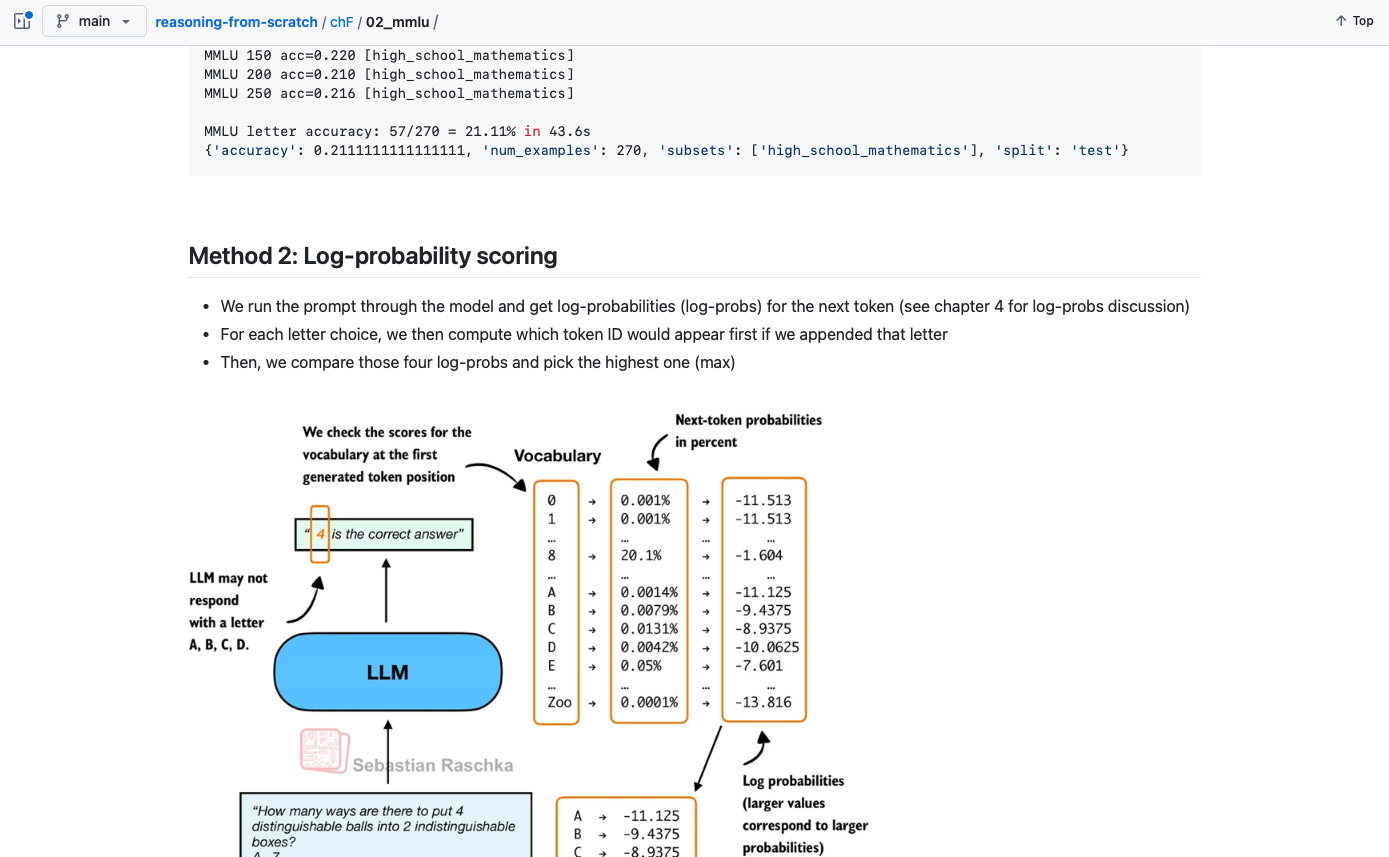
原理与场景:模型被要求从 A、B、C、D 四个选项中选出正确答案。例如,经典的 MMLU(海量多任务语言理解)数据集就采用了这种形式。
实用解读:
- 优点:客观性强,易于自动化,结果易于比较。
- 缺点:可能过于死板,无法捕捉模型在开放式任务中的细微差别。
- 适用人群:适合用于快速筛选模型,或检查模型在特定知识领域的掌握程度。
2. 验证器
这种方法在推理模型(Reasoning Model)的开发中尤为重要。
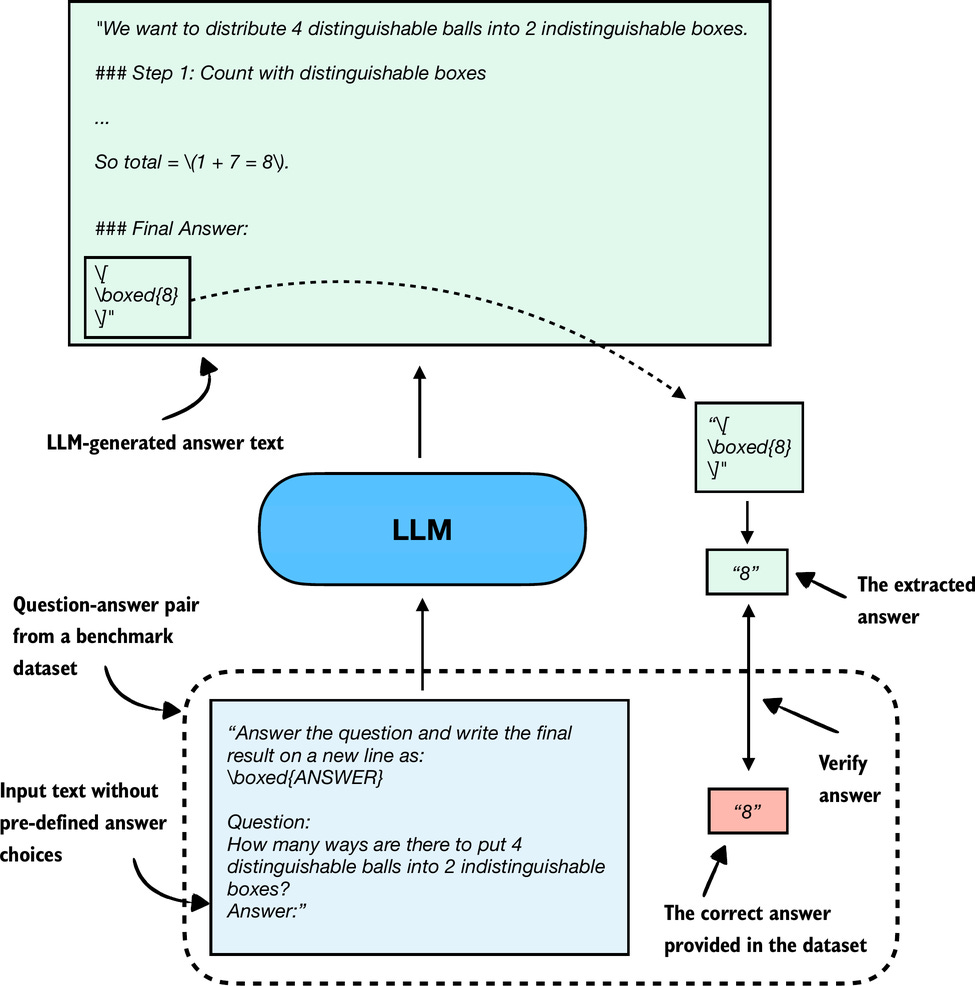
原理与场景:验证器不仅仅是检查答案是否匹配,而是验证模型的推理过程是否正确。例如,在数学题或逻辑推理题中,验证器会检查中间步骤是否符合逻辑。
实用解读:
- 优势:能发现模型虽然答案对了但逻辑错误的情况,评估粒度更细。
- 价值:对于需要高准确率的工业级应用(如代码生成、复杂决策)非常有价值。
3. 排行榜
排行榜是上述两种方法的综合展示。
原理与场景:将大量模型在多个基准测试(如 MMLU)上的得分汇总,并按总分或特定指标进行排名。
实用解读:
- 作用:帮助开发者快速定位当前 SOTA(State of the Art)模型的位置。
- 注意:排名靠前不代表模型在所有场景下都好用,需结合具体任务查看子项得分。
4. LLM 评判员
这是近年来兴起的一种评估范式。
原理与场景:使用一个强大的、经过微调的 LLM(如 GPT-4)作为裁判,去评判另一个模型的回答质量。裁判可以根据指令对回答进行打分、分类或给出反馈。
实用解读:
- 灵活性:非常适合评估主观性较强的任务,如创意写作、对话流畅度、情感分析等。
- 成本与延迟:虽然准确率较高,但运行成本和推理延迟通常高于简单的基准测试。
总结
评估 LLM 没有唯一的标准答案。理解这四种方法的分类(基准 vs 评判)及其优缺点,能帮助开发者根据项目需求选择最合适的工具。对于追求高精度的任务,验证器是首选;而对于快速筛选和通用知识测试,多选题基准测试依然不可或缺。
通过建立这样的评估框架,我们不仅能更科学地比较模型,还能在模型微调或开发过程中,清晰地追踪进度。
本文目录(6 节)
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:Understanding the 4 Main Approaches to LLM Evaluation (From Scratch)
阅读原文