决策模型 vs 生成式 LLM:让 Agent 不再逐 token 出答案
对比七种开源决策模型与 Qwen3-0.6B 基线,决策模型在路由选择任务上准确率更高、延迟更低、零生成 token,为有界选择场景提供了新范式。
从"逐 token 生成"到"直接打分"
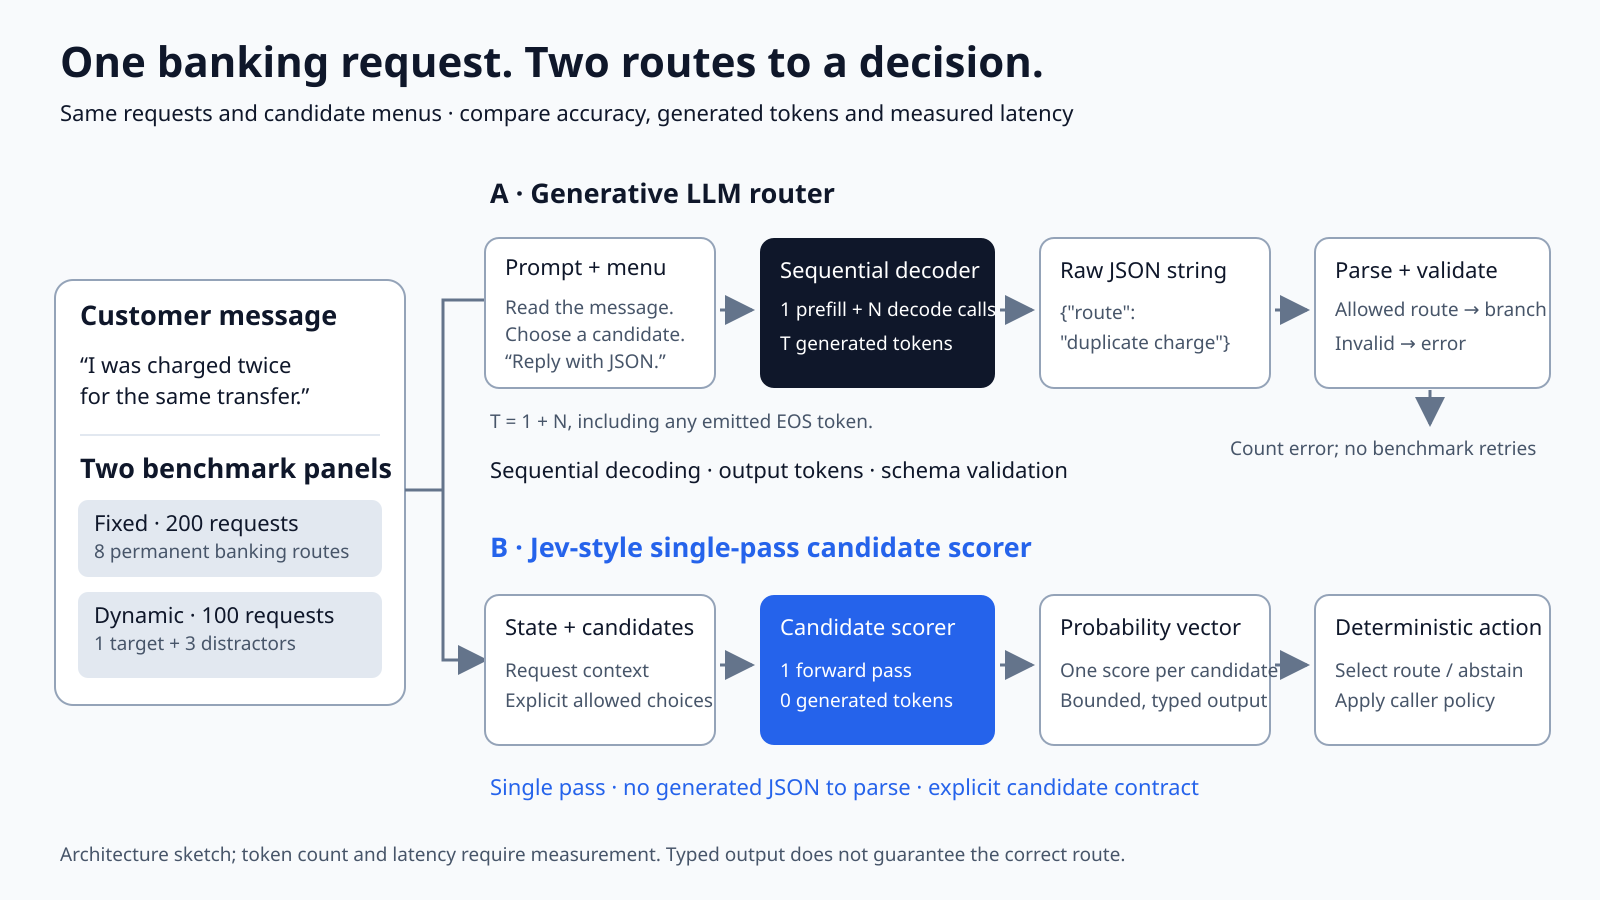
当我们让一个银行客服系统处理"同一笔转账被扣了两次款"这类工单时,下一步其实只需要在几个固定路由中选一个——比如"重复扣费"、"转账延迟"、"关闭账户"。但传统做法是让语言模型把 {"route": "duplicate charge"} 一段一段生成出来,再解析 JSON。
问题是:软件真正需要的只是一个选择,不是文本。决策模型(Jev-style)的思路就是让 Agent 跳过生成环节,直接对候选项打分,返回一个类型化的结果。作者把七种开源实现和一个 Qwen JSON 生成基线放在同一批银行工单上做了对比。
候选集为什么让问题变灵活
传统分类器要为每个路由预留固定的输出槽位,新增路由就得改模型。而基于候选集的接口允许工作流在每次请求时动态提供当前可用的路由或工具,模型只负责给这份"菜单"打分。这样调用方可以在不修改模型的情况下调整候选项——这对工具选择、动作选择这类候选会随工作流变化的场景非常关键。
一个契约,三种问题
同一张工单往往同时需要回答多个有界问题。作者给出了一个统一的决策契约示例:
{
  "state": "I was charged twice for the same transfer.",
  "questions": {
    "route": {"type": "choice", "candidates": ["duplicate charge", "transfer delay", "close account", "cash withdrawal"]},
    "escalate": {"type": "yes/no", "question": "Does this need urgent human attention?"},
    "urgency": {"type": "score", "levels": ["low", "medium", "high"]}
  }
}
思路很直接:提供状态、定义允许的候选答案、拿回类型化结果,然后由确定性的业务代码决定下一步——路由、阈值判断或转人工。七个项目各自的 wire format 不同,但共享这套抽象。
实测结果:准确率与延迟
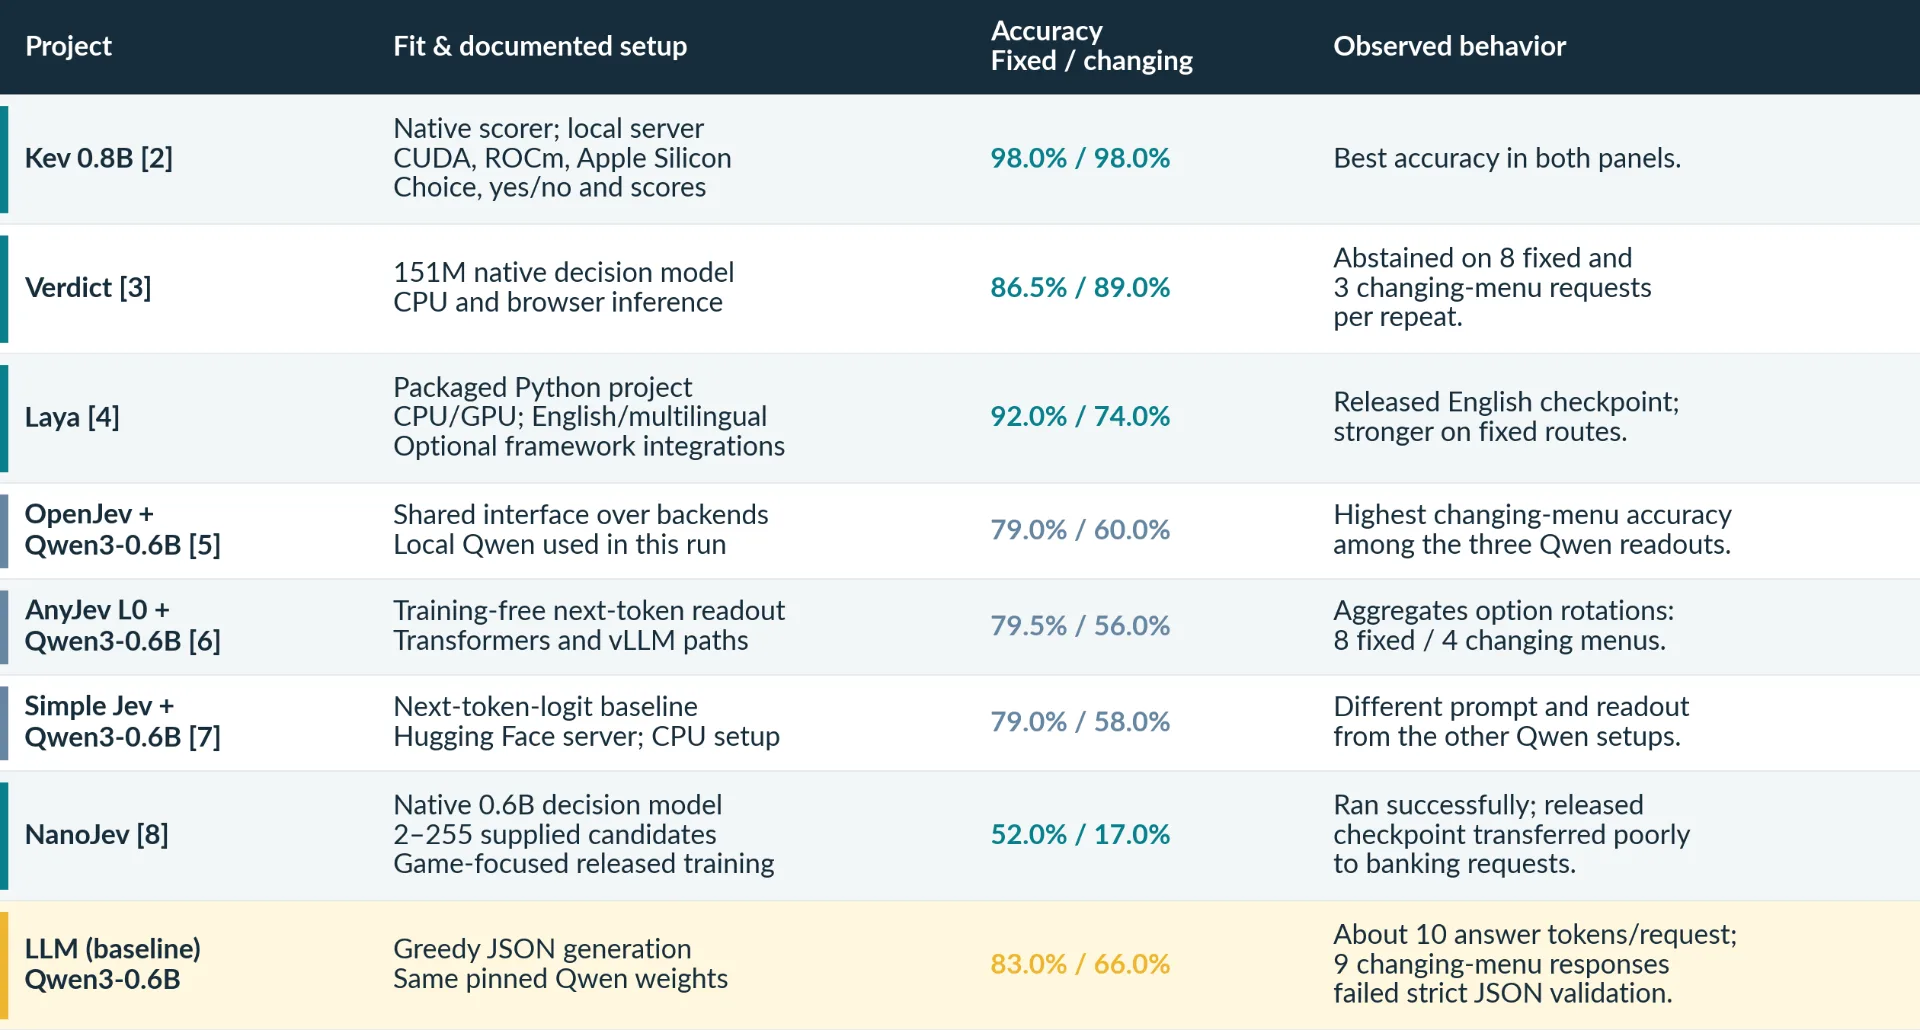
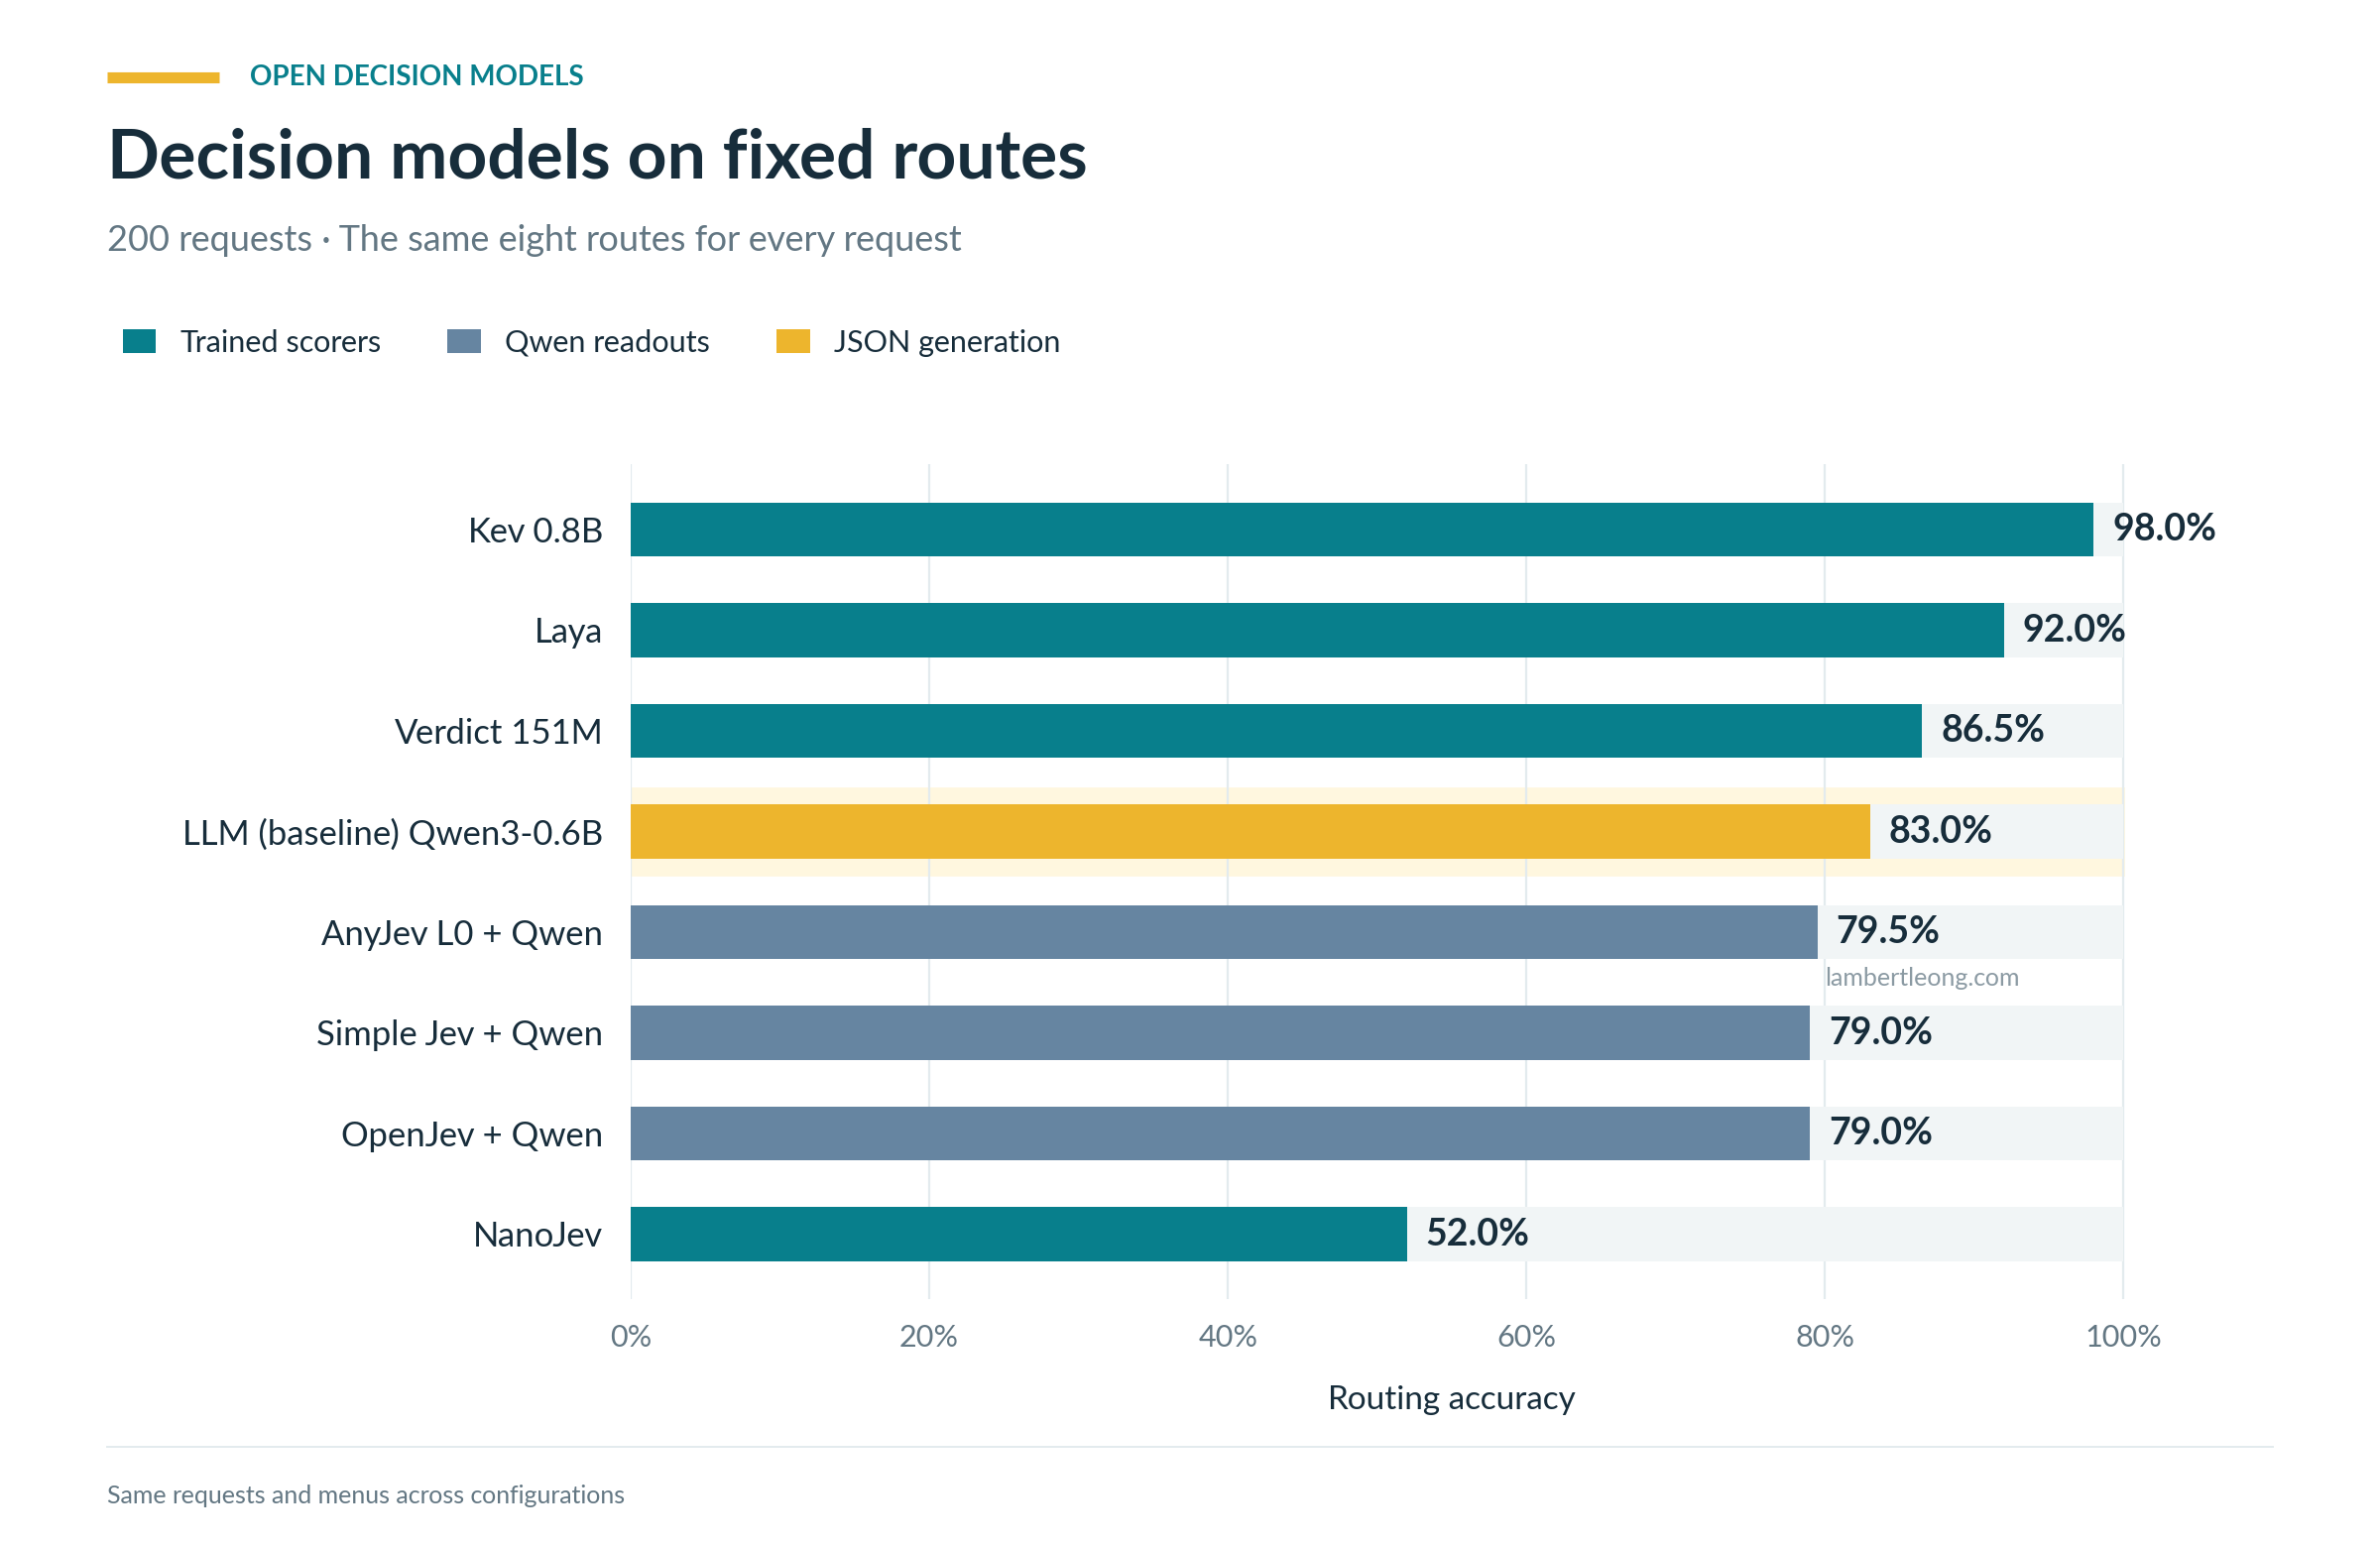
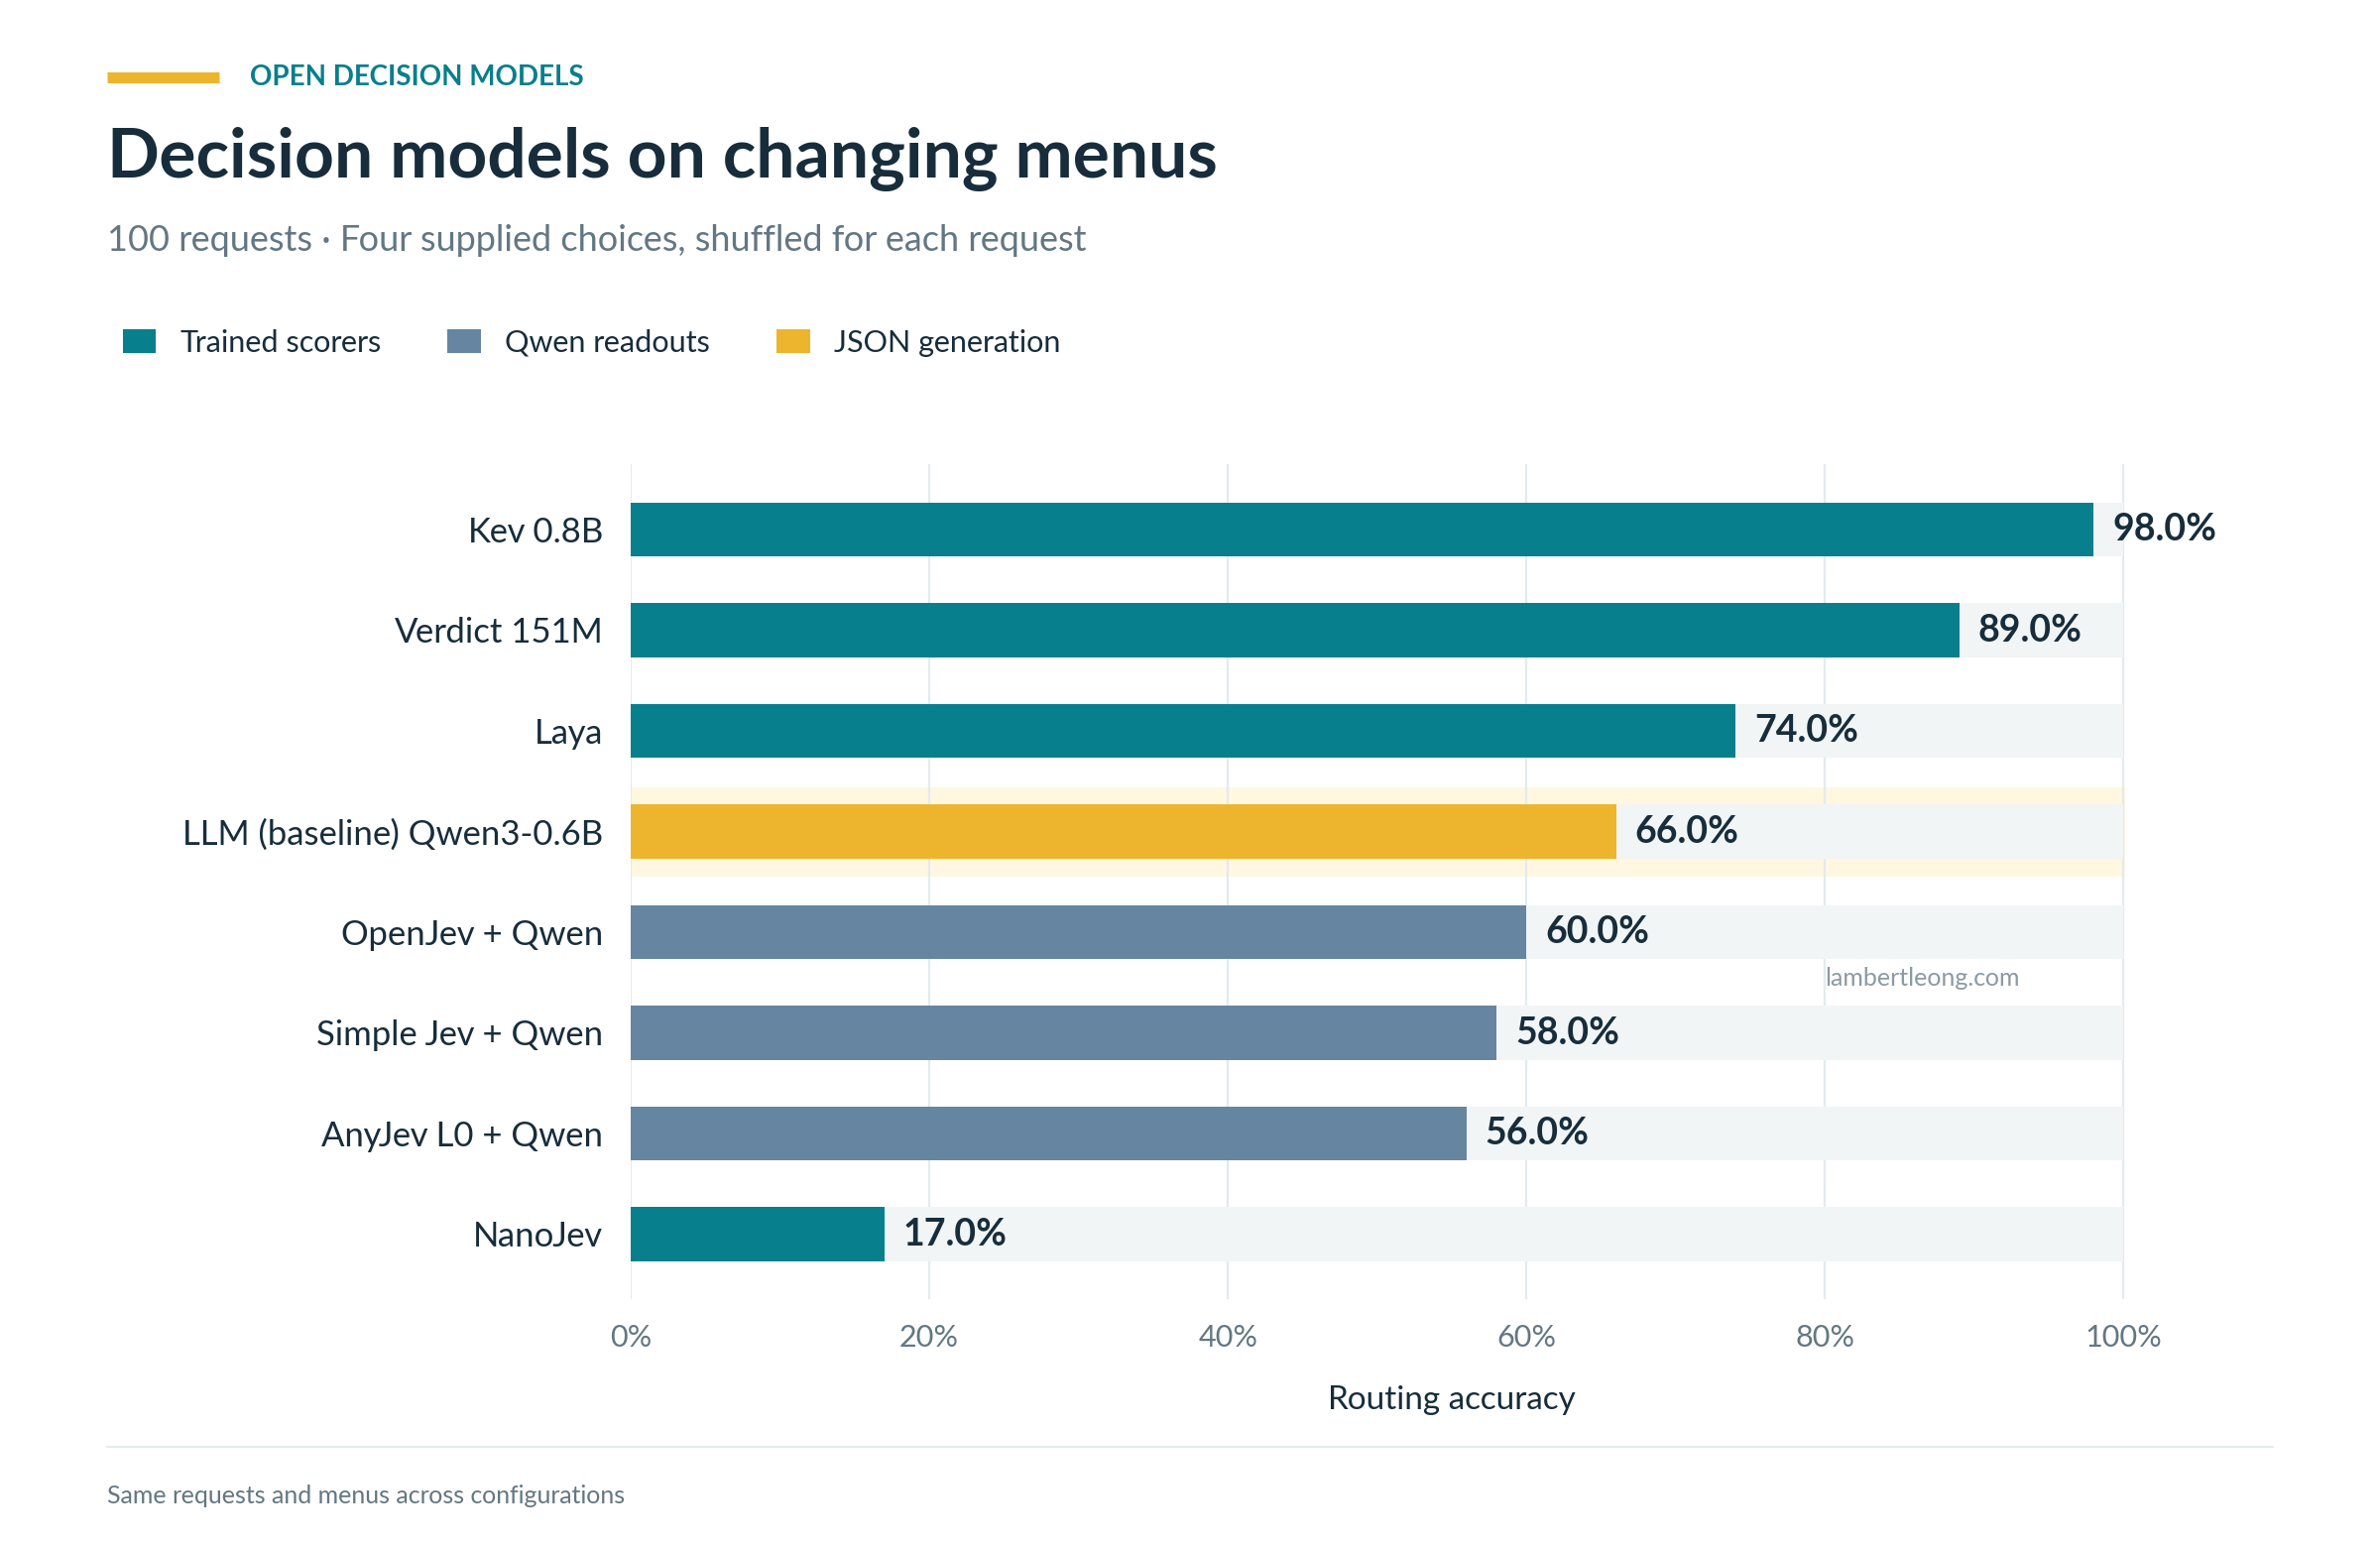
- Kev:固定路由和动态候选两种情况下都达到 98% 准确率,中位延迟 125–130 ms
- Verdict:动态候选 89%,中位延迟仅 17–18 ms
- Qwen3-0.6B(JSON 生成基线):固定路由 83%,动态候选仅 66%,中位延迟 331–357 ms
- 一个值得注意的结论:JSON 生成仍然优于三种 Qwen readout 配置,说明并非所有"读回"方案都能替代生成
决策模型全程 零生成 token,而 Qwen JSON 生成每请求约 10 个 token——这既是延迟优势的来源,也是"不生成文本、只做决策"这一范式的本质。
什么时候该用决策模型?
- 候选集有限且可枚举(路由、工具、动作选择)
- 需要低延迟,延迟预算在 100 ms 级别
- 候选会随工作流变化,不想为每个选项改模型
- 结果需要被确定性代码消费,而不是被下游 LLM 再读一遍
反过来,如果输出是自由文本、需要解释、或候选集合无法事先列出,生成式 LLM 仍是更合适的选择。作者提供的 starter kit 可以直接跑通基准测试,对比 JSON 生成与直接 readout 的差异。
本文目录(5 节)
本文基于 Towards Data Science 的公开内容,由 AI 辅助整理改写后发布。
原标题:Jev Your Engines: Seven Open Decision Models vs. a Generative LLM
阅读原文