超越标准Transformer的LLM架构探索
当前主流LLM仍基于Transformer,但线性注意力混合、文本扩散、代码世界模型等替代架构正在涌现,本文梳理各方向特点与开发者选型建议。
从主流到前沿:LLM 架构的多元探索
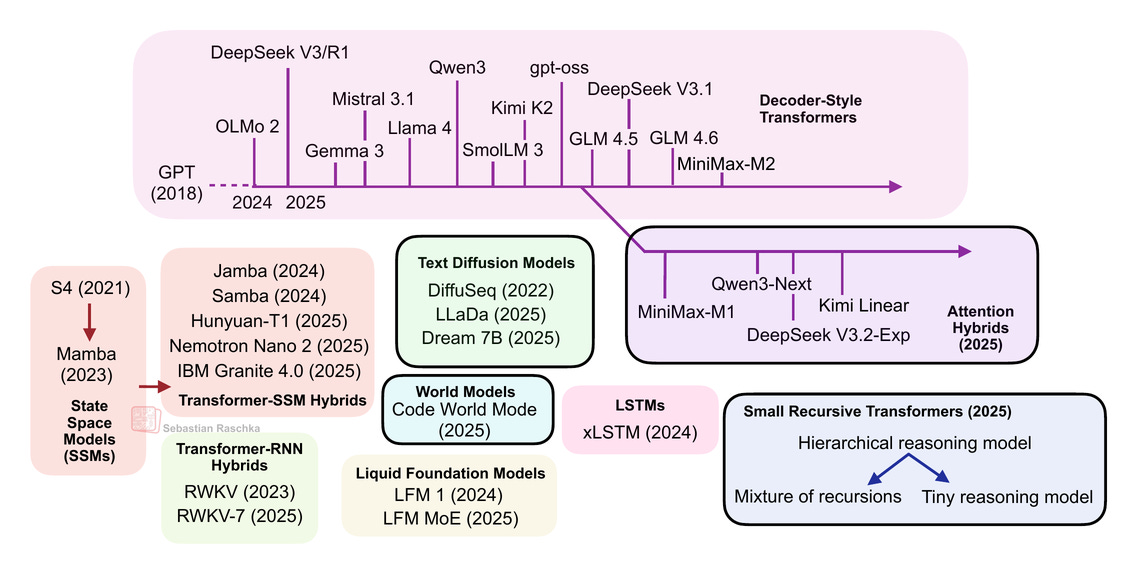
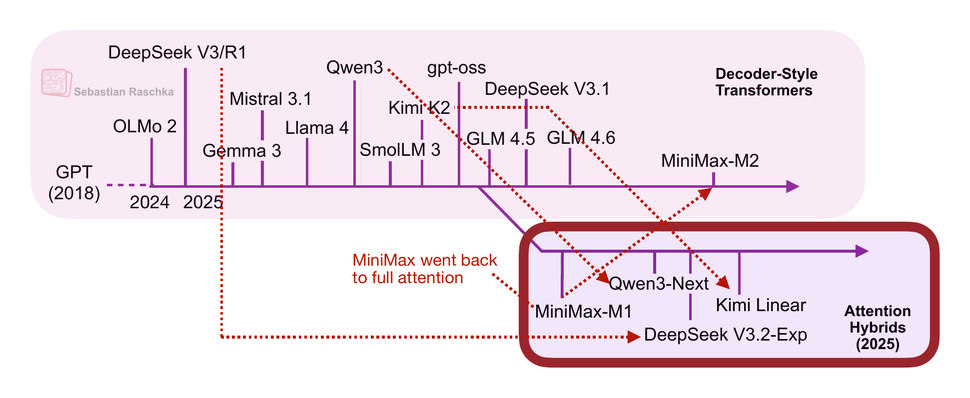
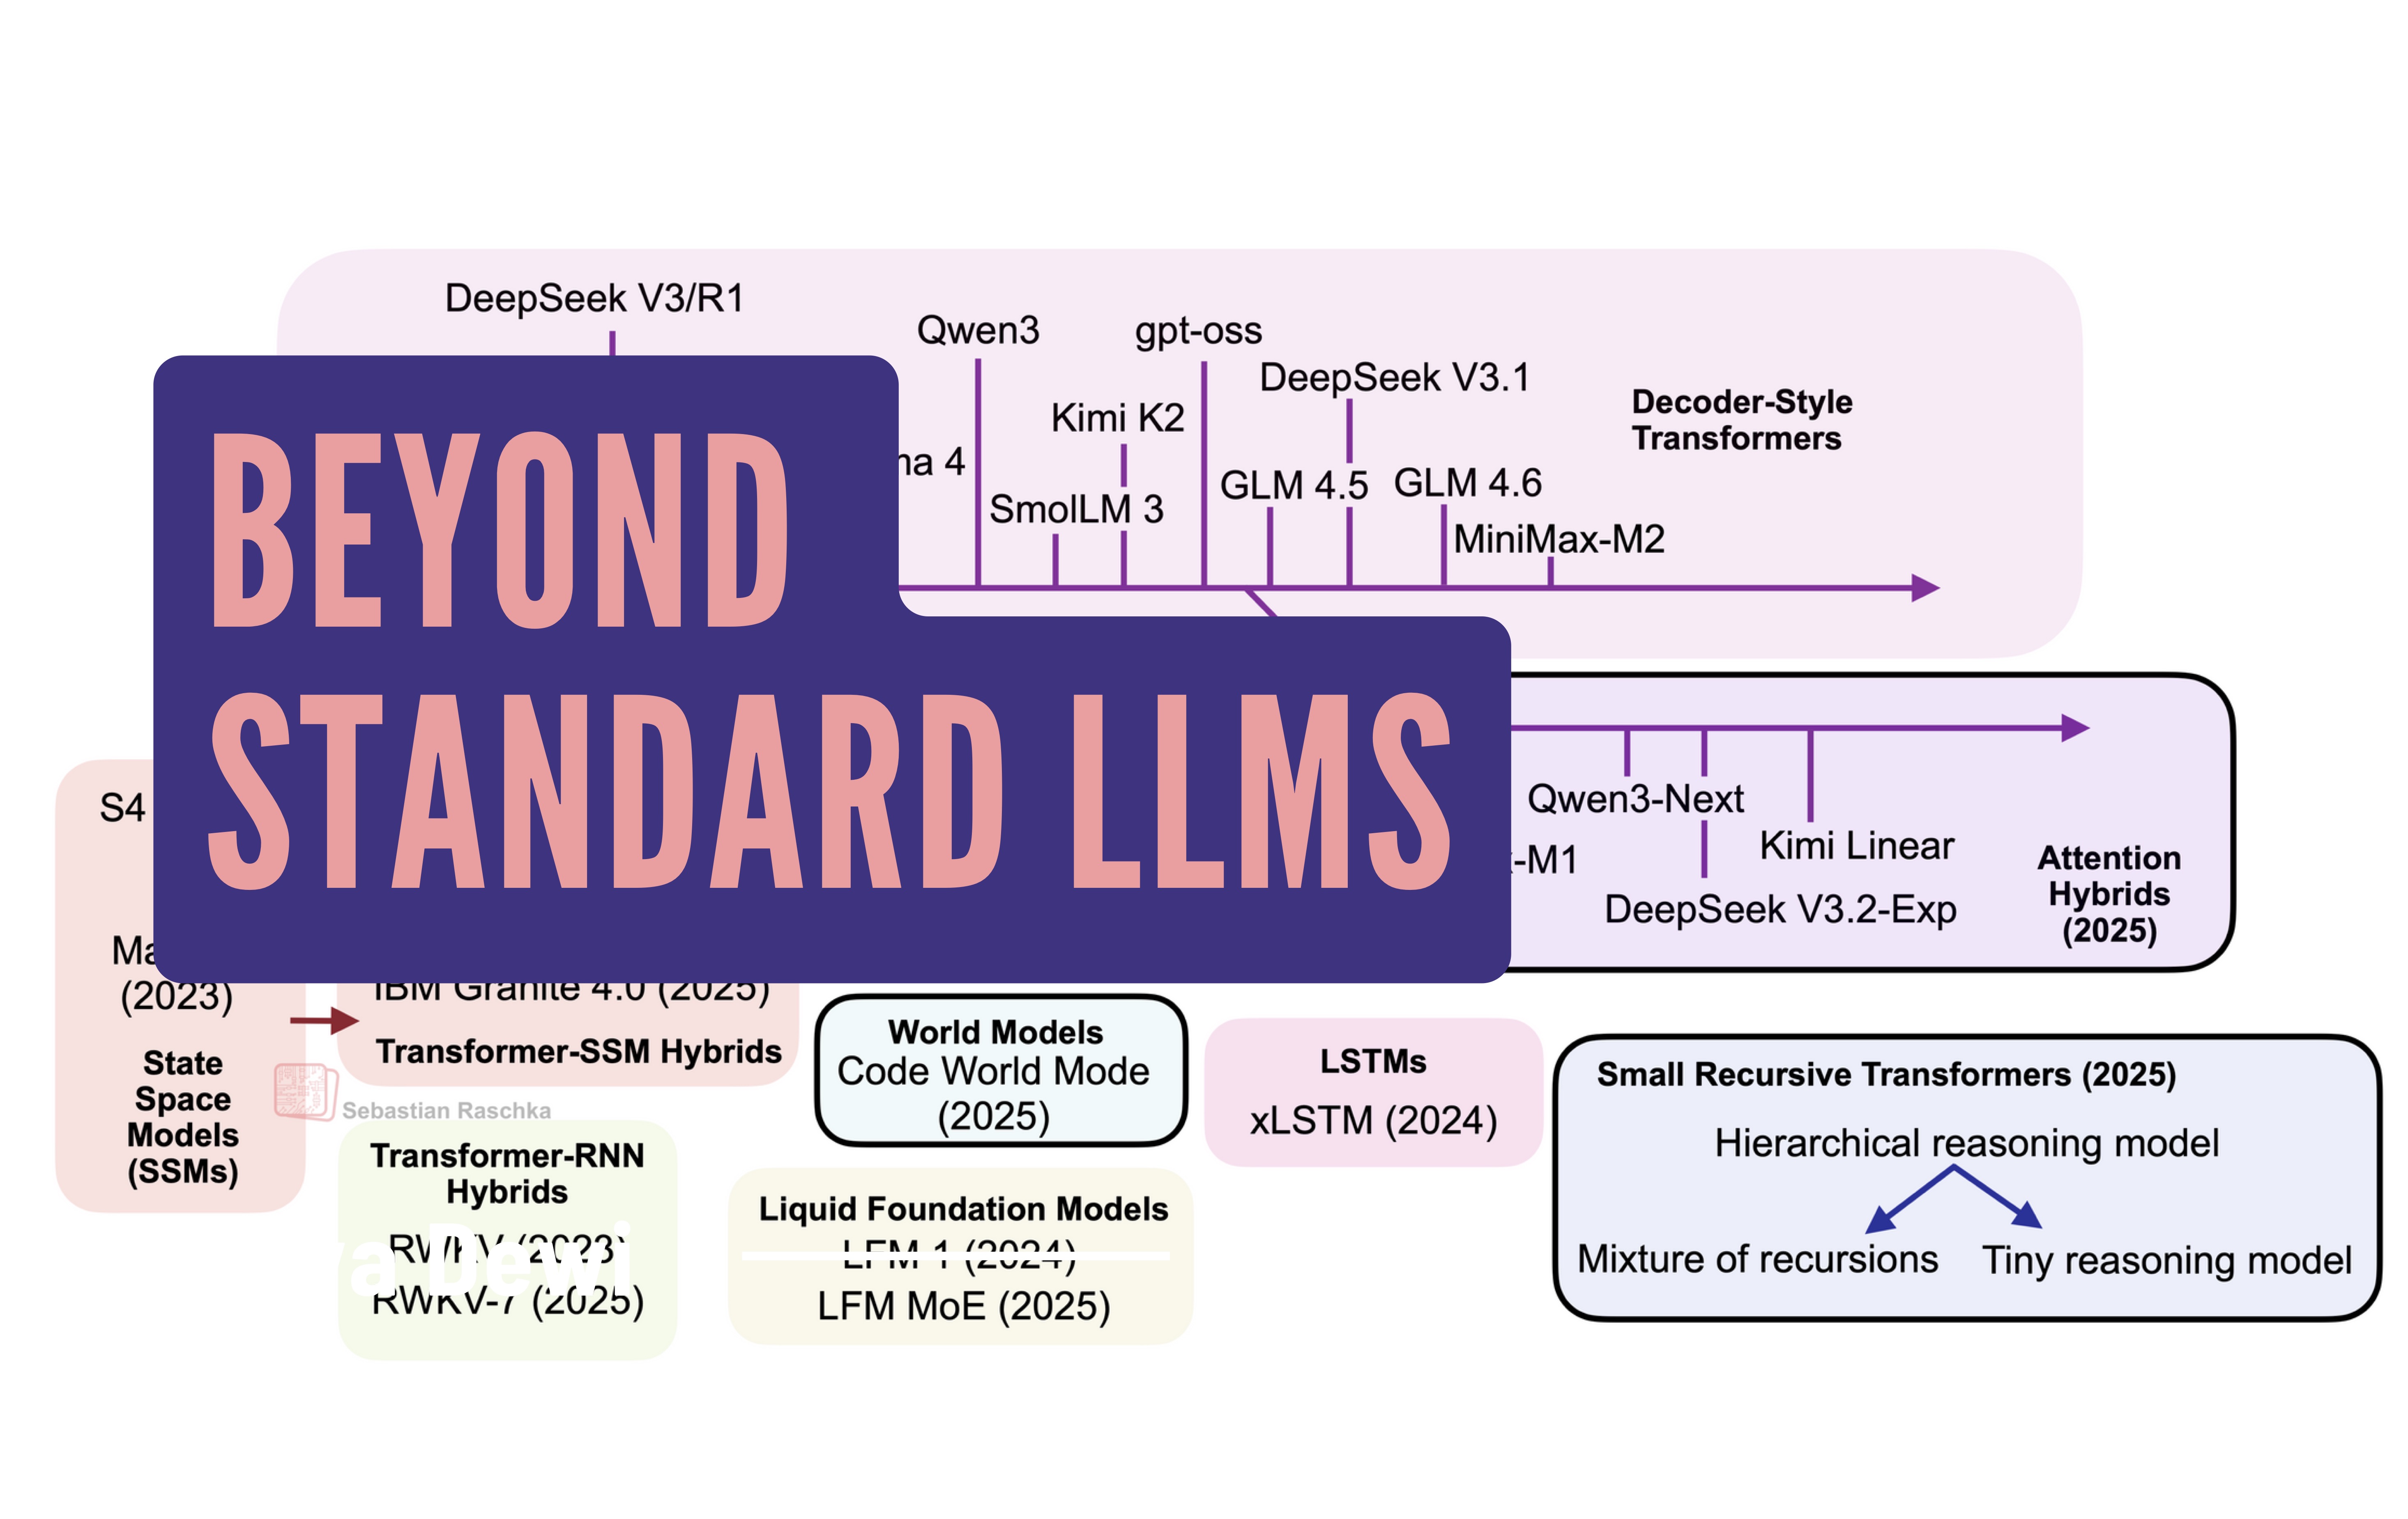
当前最强大的开源大语言模型——从 DeepSeek R1 到 MiniMax-M2——本质上仍基于自回归解码器式 Transformer 架构,核心仍是多头注意力机制的变体。但近年来,一系列替代方案正在浮现:线性注意力混合架构、文本扩散模型、代码世界模型、小型递归 Transformer 等。有些追求效率提升,有些则着眼于建模能力的突破。
主流 Transformer 架构:依然是首选
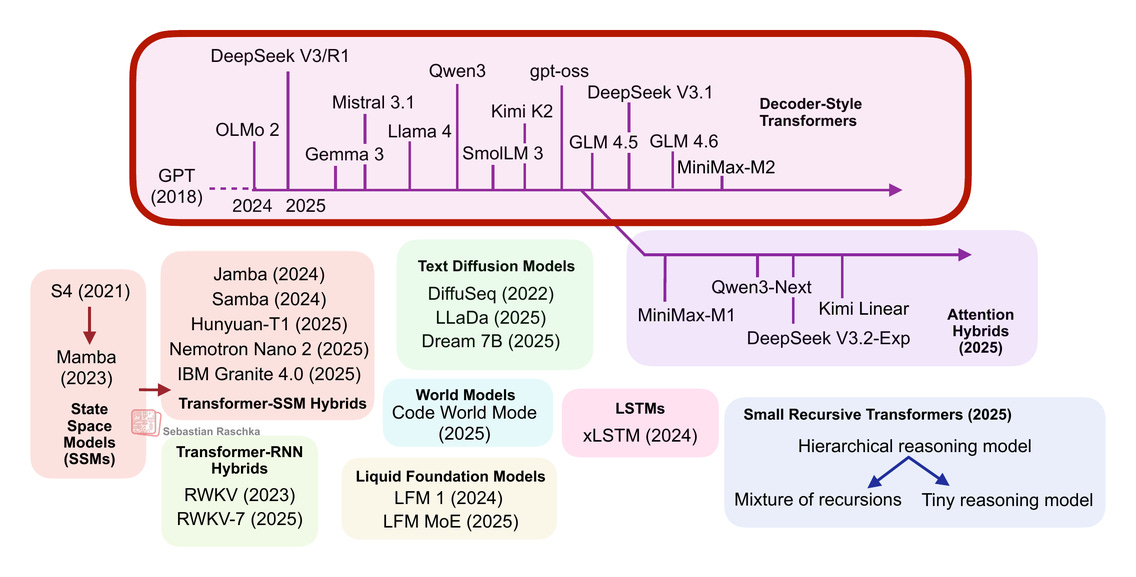
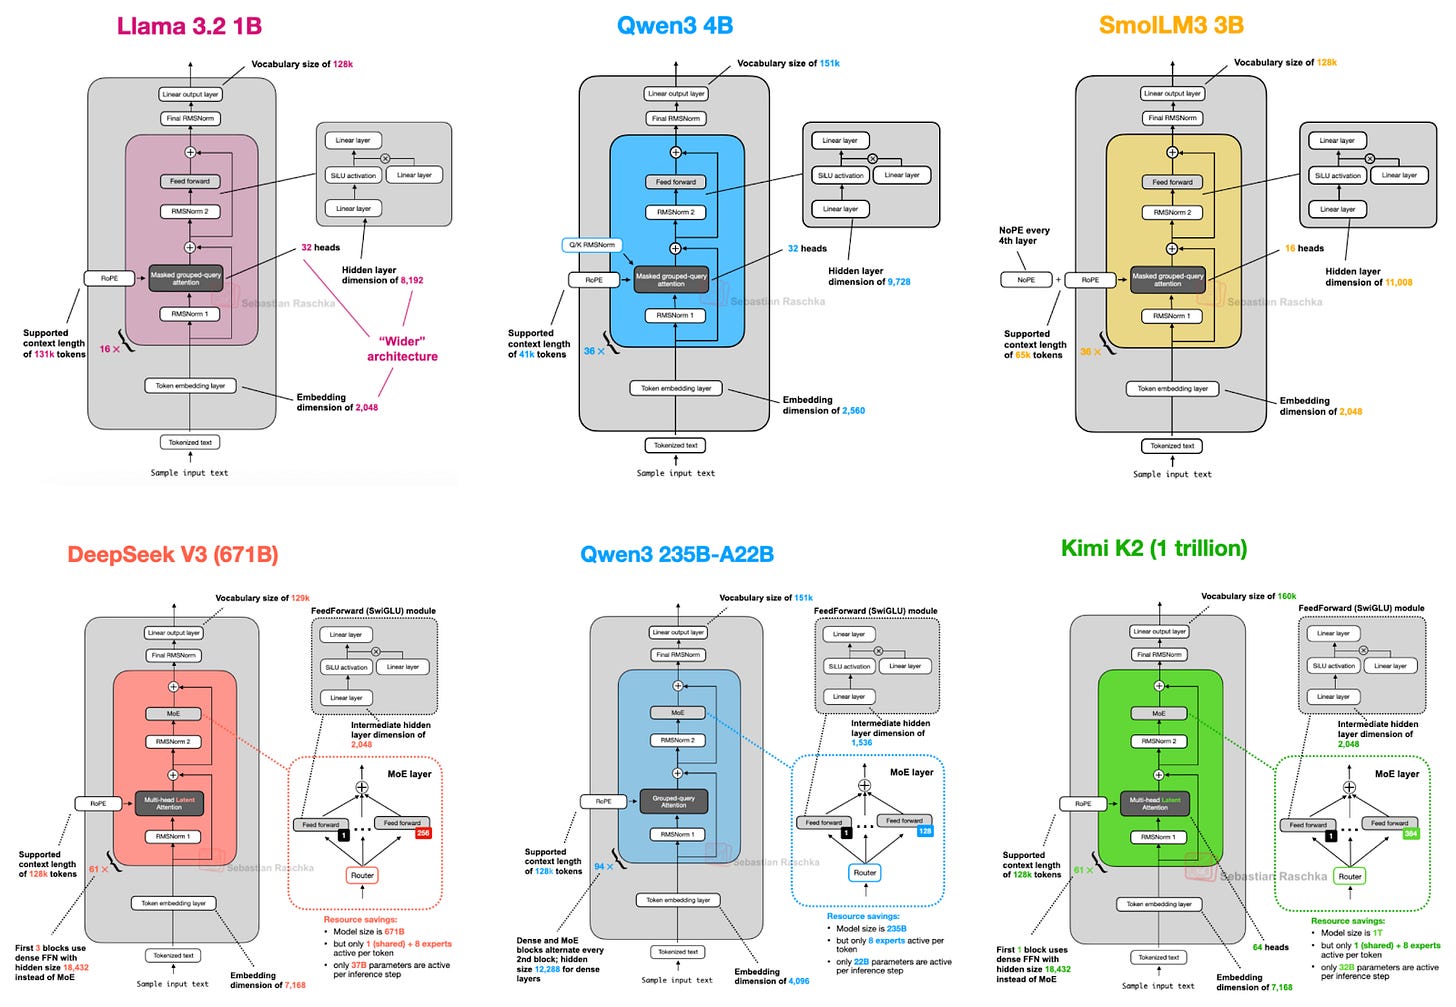
从 2024 年底至今,基于经典 Transformer 架构的模型持续刷新性能上限。值得关注的开源模型包括:
- DeepSeek V3/R1
- Gemma 3
- Mistral Small 3.1
- Llama 4
- Qwen3
- Kimi K2
- GLM-4.5 / GLM-4.6
- MiniMax-M2
此外还有 GPT-5、Grok 4、Gemini 2.5 等闭源模型同属这一类别。
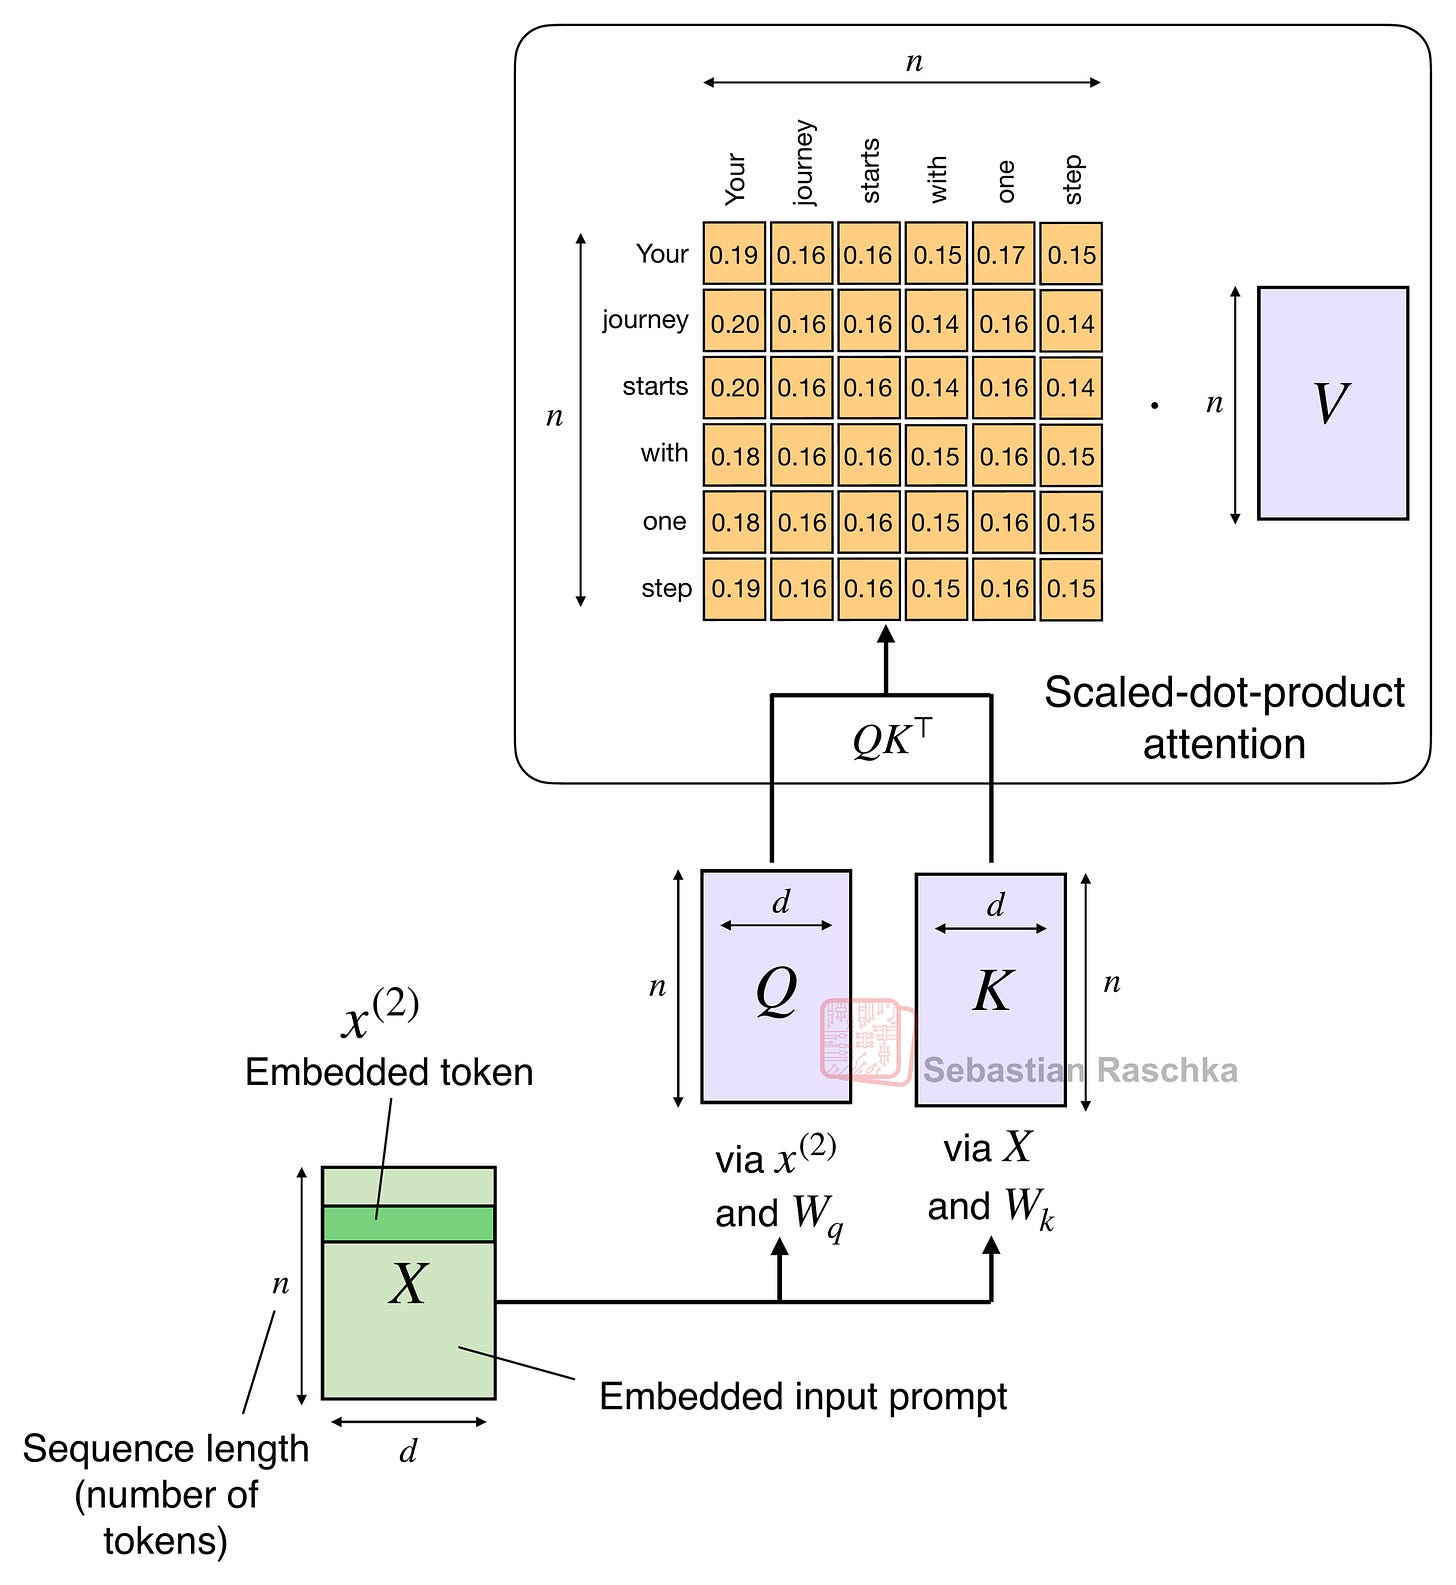
对开发者的实用建议: 如果你正在构建应用、微调模型或尝试新算法,这些成熟模型是首选。它们经过充分验证,性能稳定。同时,Transformer 内部也有大量效率优化手段值得了解,包括分组查询注意力(GQA)、滑动窗口注意力(SWA)、多头潜在注意力(MLA) 等。
替代架构:为什么值得关注?
虽然 Transformer 目前仍是性能标杆,但研究者并未停止探索。Sebastian Raschka 在 PyTorch Conference 2025 的演讲中系统梳理了这些替代方向,并指出每类架构都值得深入讨论。
线性注意力混合架构
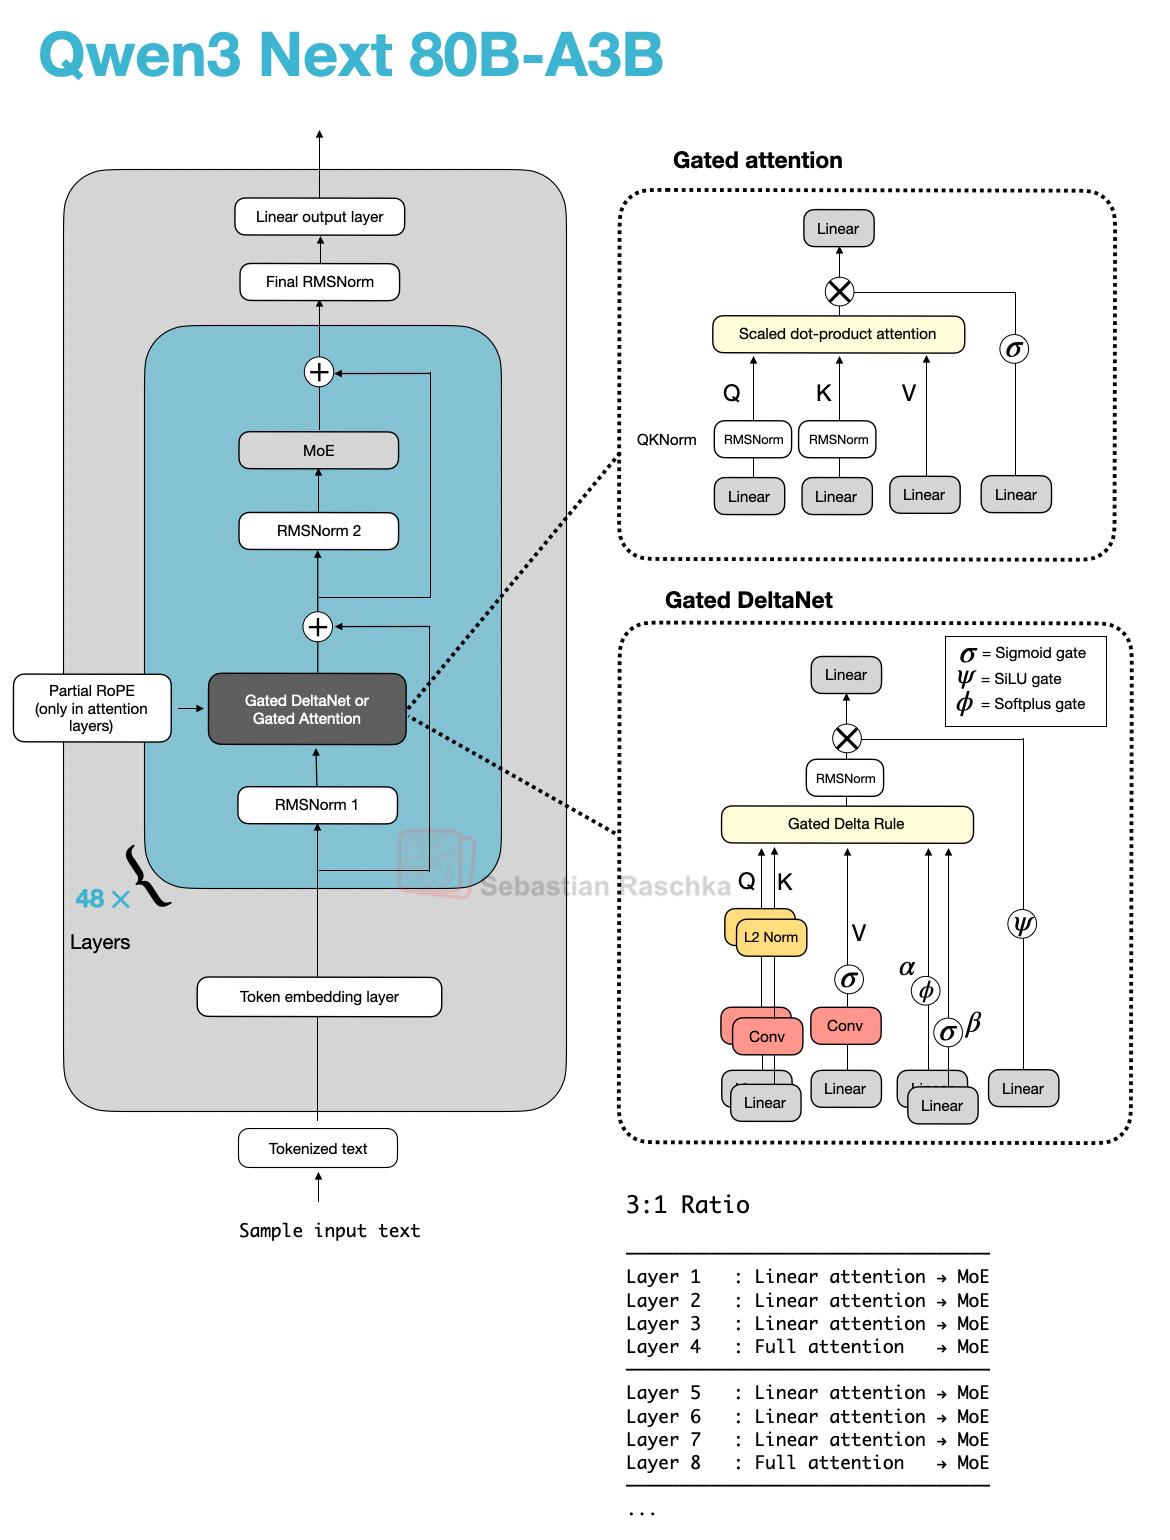
这类架构尝试用线性注意力替代标准缩放点积注意力,以降低计算复杂度。Qwen3-Next 和 Kimi Linear 是典型代表——它们将 SSM(状态空间模型)组件引入 Transformer 框架,试图在保持模型能力的同时提升推理效率。
与 IBM Granite 4.0、NVIDIA Nemotron Nano 2 等"以 SSM 为主、Transformer 为辅"的混合架构不同,前者更倾向于"以 Transformer 为主、SSM 为辅"的设计思路。
文本扩散模型
扩散模型在图像生成领域已取得巨大成功,研究者正尝试将其迁移到文本生成任务。这一方向的核心思路是:不像自回归模型那样逐 token 生成,而是通过去噪过程一次性生成整段文本。
对开发者的价值: 如果扩散式文本生成取得突破,可能带来全新的生成范式——无需处理自回归推理的延迟问题,在特定场景下可能实现更快的生成速度。
代码世界模型
这一方向的目标不是直接生成代码,而是让模型学习代码执行的"世界模型"——即理解代码在运行时如何影响程序状态。这种建模方式可能带来更强大的代码理解和调试能力。
小型递归 Transformer
递归 Transformer 通过让模型反复处理输入来增加计算深度,类似于循环神经网络的思想。其优势在于可以用较小的模型获得更强的推理能力,适合资源受限的场景。
给开发者的建议
- 应用开发优先选主流模型:Transformer 架构模型生态成熟、工具链完善,是生产环境的稳妥选择。
- 关注效率优化方向:线性注意力混合架构可能在推理成本上带来显著改善,值得跟踪。
- 理解架构差异有助于选型:不同架构有不同的适用场景,了解其原理能帮助你在特定任务中做出更优选择。
- 保持对前沿方向的关注:文本扩散和代码世界模型虽然尚未成熟,但可能在未来改变 LLM 的生成范式。