在 Surface Laptop Ultra 上跑本地 AI 模型:实用经验

介绍如何在 Surface Laptop Ultra 上部署本地大模型,涵盖硬件适配、软件栈选择、性能预期与实用技巧,帮助开发者在不依赖云端的前提下实现隐私优先的 AI 推理。
为什么要在笔记本上跑本地 AI?
随着大语言模型(LLM)的普及,越来越多的开发者希望在本地设备上运行 AI 推理,而非完全依赖云端 API。这样做的好处显而易见:数据不出设备、零推理成本、离线可用。微软推出的 Surface Laptop Ultra 搭载 NPU(神经网络处理单元),被定位为本地 AI 推理的标杆设备。本文将分享在 Surface Laptop Ultra 上部署本地大模型的实操思路与注意事项。
硬件层面的关键考量
本地跑模型,硬件是绕不开的前提。Surface Laptop Ultra 的核心优势在于其 NPU 算力,专为 AI 推理设计,能在低功耗下加速矩阵运算。但在实际操作中,还需关注以下几点:
- 内存(RAM):模型加载需要充足的内存。7B 参数的模型通常需要约 4–8GB 显存/内存,13B 及以上则建议 16GB 起步。
- 存储速度与容量:模型文件动辄数 GB,建议使用 NVMe SSD 并预留足够空间。
- NPU 利用率:并非所有推理框架都能充分利用 NPU,需确认软件栈对 NPU 的支持程度。
软件栈选择
在 Surface Laptop Ultra 上运行本地模型,主流方案包括:
- Ollama:支持一键部署 Llama、Mistral、Qwen 等开源模型,命令简洁,适合快速上手。
- llama.cpp / llama-cpp-python:轻量级推理引擎,支持量化模型(如 Q4、Q5),对内存友好。
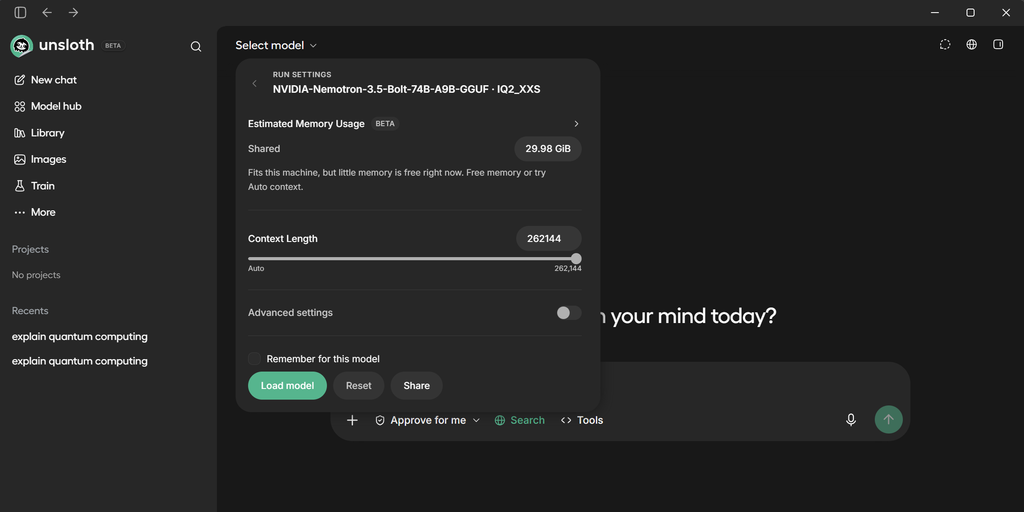
- LM Studio:图形界面工具,适合不想折腾命令行的用户,支持模型浏览与参数调节。
- Windows Copilot + AI 框架:微软生态内的 NPU 加速路径,但模型选择相对有限。
实用建议:如果追求灵活性,推荐 Ollama + llama.cpp 组合;如果偏好可视化操作,LM Studio 是更友好的选择。
模型选择与量化策略
本地推理的模型选择直接影响体验。以下是通用建议:
- 7B 参数模型(如 Llama 3 8B、Mistral 7B、Qwen 2 7B):在消费级笔记本上可流畅运行,响应速度可接受。
- 13B–14B 参数模型:需要更多内存,但输出质量显著提升,适合对质量有要求的场景。
- 量化版本:使用 Q4_K_M 或 Q5_K_M 量化可将模型体积压缩 60%–75%,是本地部署的首选方案。
性能预期与现实
需要坦诚的是,即使 Surface Laptop Ultra 配备 NPU,本地推理的速度仍无法与云端 GPU 集群相比。7B 模型的生成速度通常在每秒 10–25 个 token 左右(具体取决于模型、量化方式和系统负载)。对于日常写作辅助、代码补全、知识问答等场景,这个速度完全够用;但如果需要处理长文本或高并发请求,云端服务仍是更优解。
适合谁?
本地 AI 推理最适合以下人群:
- 隐私敏感场景:处理企业内部数据或个人敏感信息,不希望数据上传云端。
- 离线工作环境:差旅、野外作业等网络不可靠的场景。
- 成本敏感用户:高频调用 API 费用较高,本地推理可显著降低长期成本。
- 技术探索者:希望深入理解模型推理流程,进行自定义实验。
总结
Surface Laptop Ultra 为本地 AI 推理提供了一个开箱即用的硬件平台,配合 Ollama、llama.cpp 等成熟工具,开发者可以在数分钟内完成模型部署。虽然性能不及云端,但对于大多数日常 AI 应用,本地方案在隐私、成本和可控性方面具有不可替代的优势。建议从 7B 量化模型起步,逐步探索更复杂的部署方案。

本文目录(7 节)
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Running local AI models on Microsoft’s Surface Laptop Ultra: What we found
阅读原文