量化验收为什么只看精度会漏掉关键问题
量化部署的验收标准普遍只检查精度指标,却忽略了阈值相关的失败模式。本文通过人脸验证案例说明,仅靠 top-1/top-5 精度无法发现量化后阈值偏移问题,建议开发者在验收流程中加入误接受率和误拒绝率。
量化验收的盲区
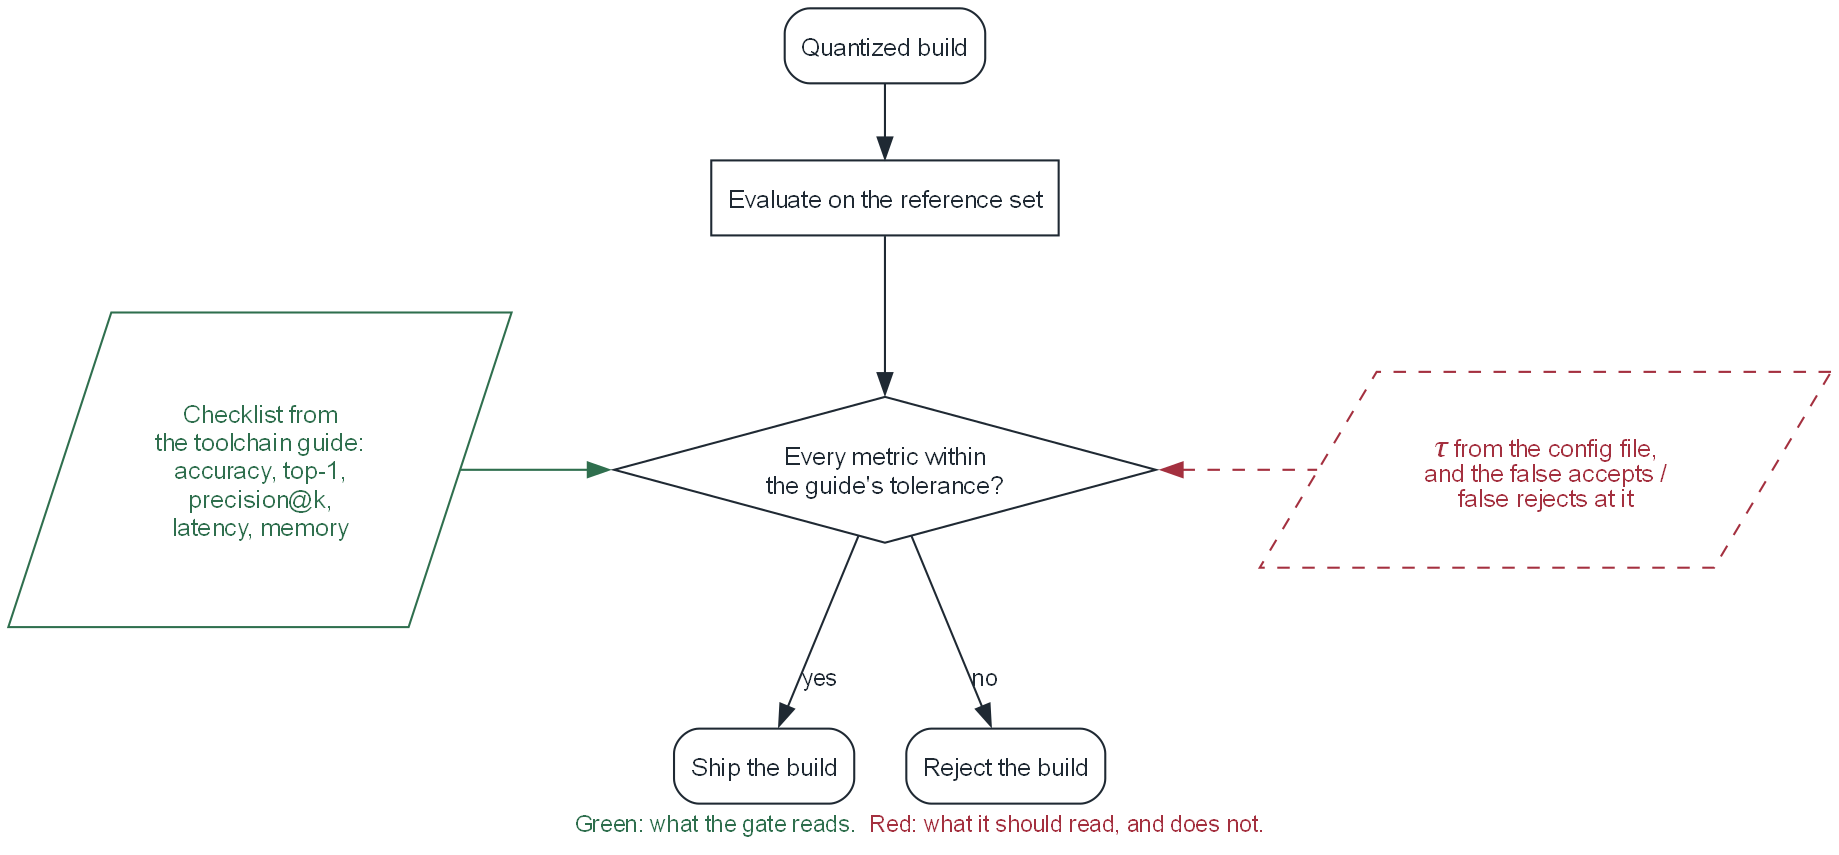
大多数量化部署流程中,决定 int8 版本是否上线的验收标准都遵循同一个模式:INT8 精度 ≥ FP32 精度 − 1%。无论是 EdgeGate 的门槛表、oneuptime 的检查清单,还是各种 PTQ 实践指南,核心逻辑都是拿 top-1 和 top-5 精度与 FP32 基线做对比。
作者调研了十份文档后发现:这些验收标准中,没有任何一个指标的值取决于决策阈值的设定位置。精度、top-1、top-5、输出方差、延迟、显存占用——这些指标评估的是模型本身的性能,但真正决定"接受"还是"拒绝"的那个常量(相似度阈值、置信度截断、拒绝门)并没有被纳入考量。
量化不是无损导出。它会改变分数生成的方式,而一个完全由"无阈值"数字构成的验收门,无论叠加多少层精度指标,都无法检测那个常量是否仍然落在正确位置。
人脸验证中的实际案例
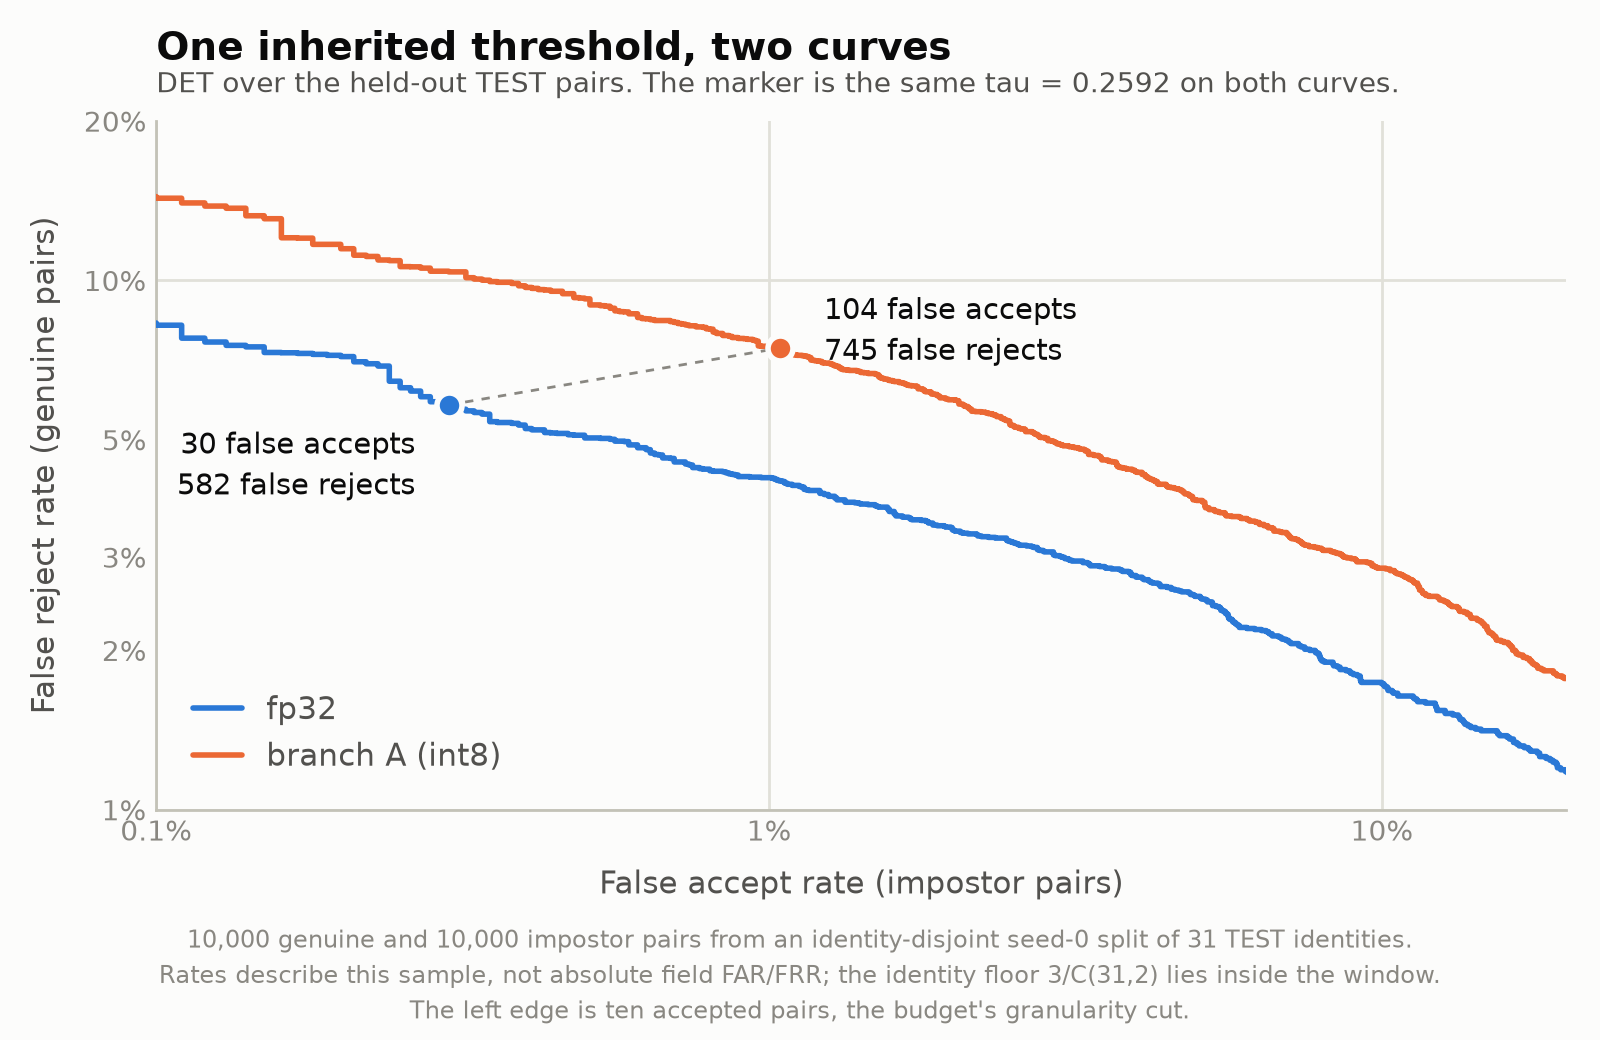
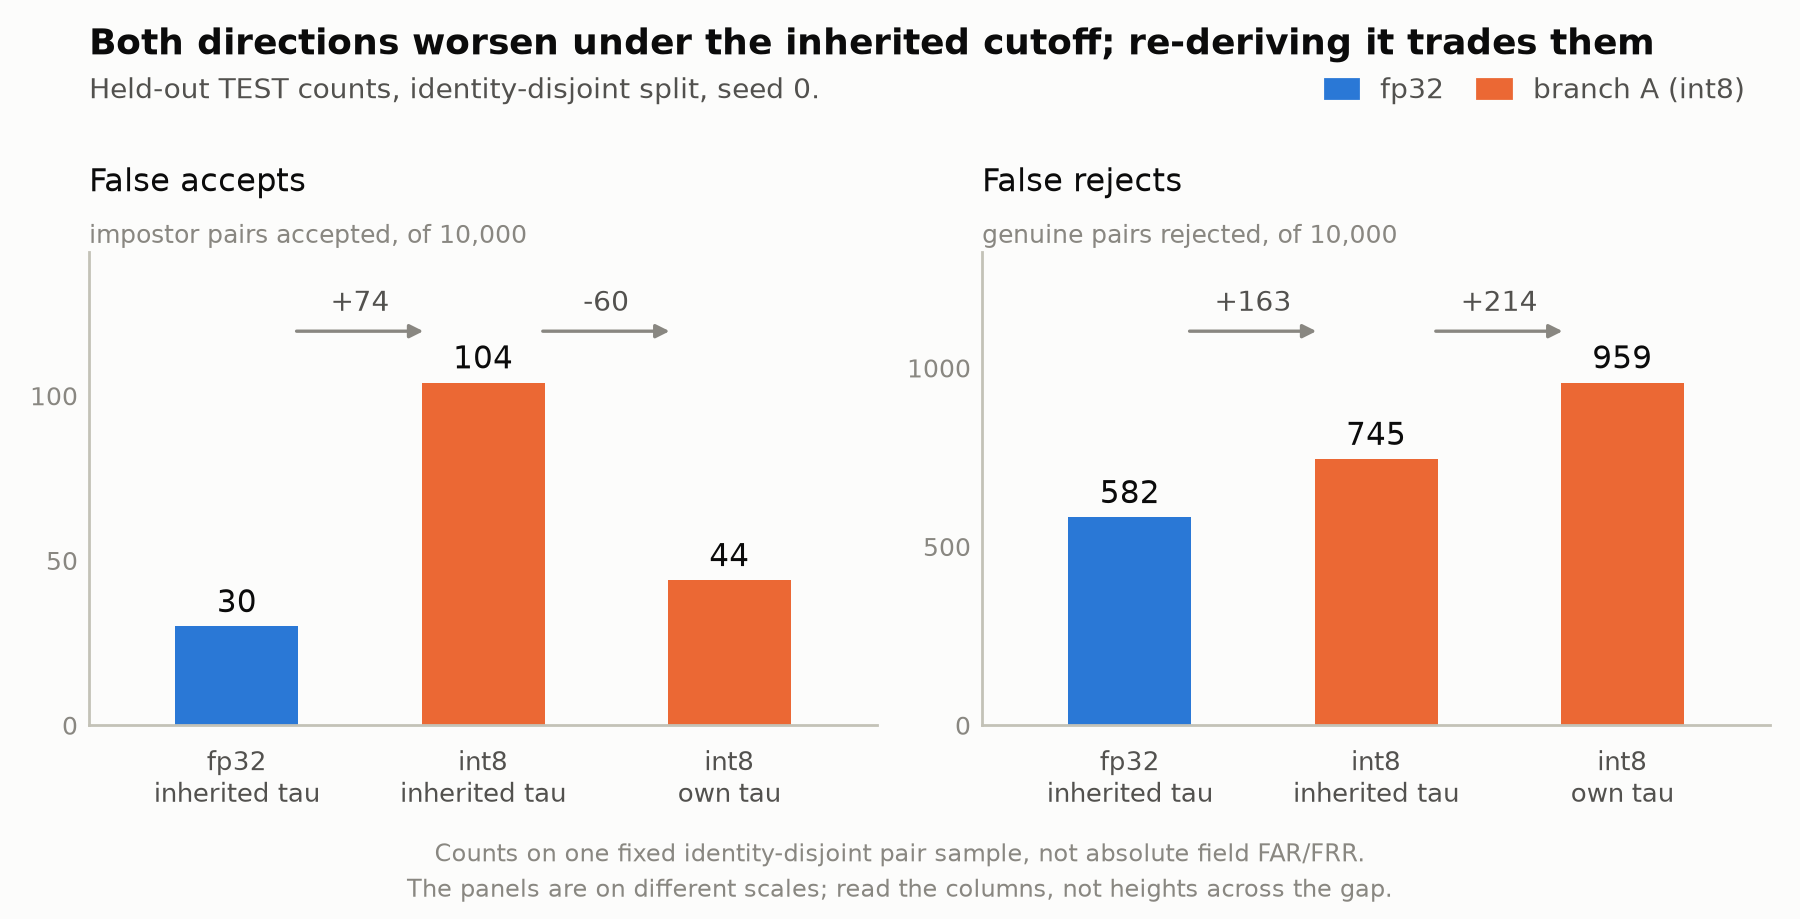
作者在人脸验证场景中实测了这一盲区:使用预训练的 ArcFace 编码器,通过 Hailo 工具链做 int8 量化。量化后,精度指标看起来没有明显下降,但阈值偏移导致误接受率(false-accept)和误拒绝率(false-reject)发生了显著变化——而这在纯精度对比中完全不可见。
这个失败模式并非孤例。在闭集分类、目标检测、向量检索等场景中,只要存在一个由 FP32 模型拟合的阈值,量化后就可能产生类似的偏差。
为什么这个问题一直没被发现
这并非因为底层知识不成熟。在 RAG 和向量检索中,团队早已习惯将阈值绑定到特定模型版本,并在 CI 中重新校准。在生物特征识别领域,误匹配率和非误匹配率本身就是围绕阈值定义的。问题在于:这些知识在量化部署流程中没有交汇。编译器文档、厂商的精度调试页面、边缘部署检查清单里,"阈值"只作为 NMS 参数或编译选项出现,从未被当作需要重新验证的验收项。
修复方案:加两个数字
修复成本不高,但也不是免费的。作者建议在现有验收标准中增加两个指标:
- 误接受率(False-Accept Rate):在量化后模型的实际阈值下,错误样本被错误接受的比例
- 误拒绝率(False-Reject Rate):在量化后模型的实际阈值下,正确样本被错误拒绝的比例
这两个指标必须在你的配置文件实际使用的阈值上测量,而不是在 FP32 模型的原始阈值上。一个下午的测量工作,就能补上量化验收中最关键的盲区。
对开发者的实用建议
- 不要只信精度数字:top-1 精度下降 0.5% 可能意味着阈值偏移了 10%,对下游决策的影响远超精度本身的波动
- 把阈值当作模型的一部分:阈值是拟合出来的常量,模型变了,阈值就失效了,量化后的模型同样需要重新校准阈值
- 在 CI 中加入阈值验证:每次量化构建后,自动运行阈值相关的评估,而不是只跑精度对比
- 区分模型评估和决策评估:精度指标评估模型,阈值指标评估决策系统,两者缺一不可
本文目录(5 节)
本文基于 Towards Data Science 的公开内容,由 AI 辅助整理改写后发布。
原标题:The Number Your Quantization Gate Doesn't Have
阅读原文