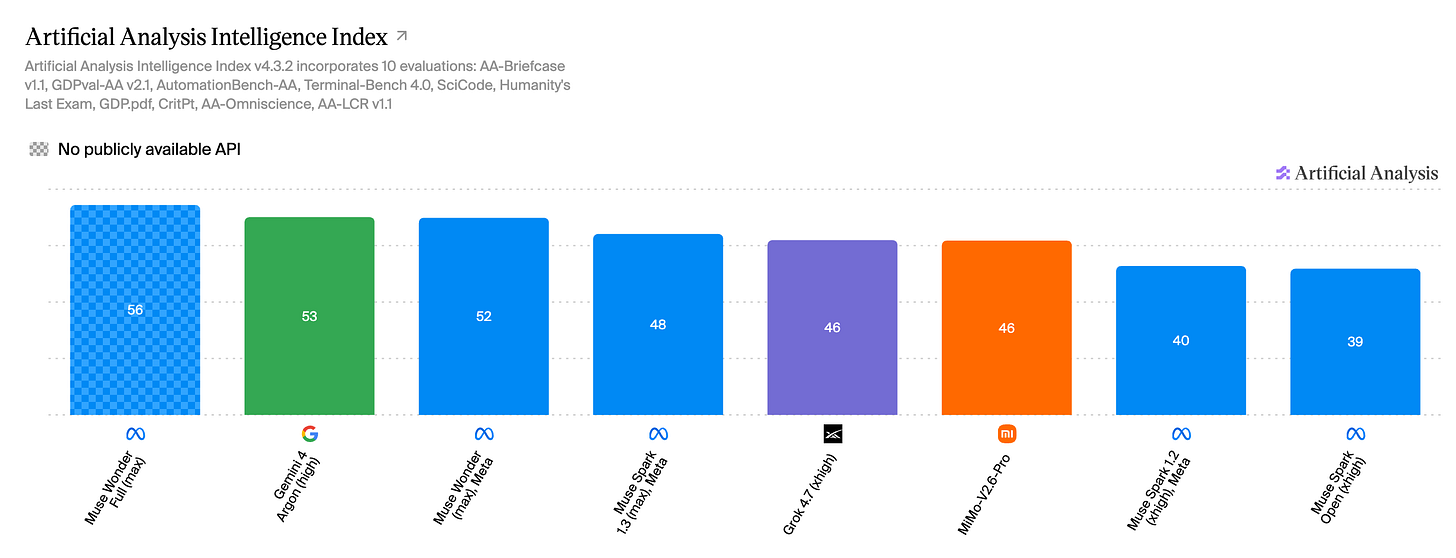
Meta开源Muse Spark Open:美国开放模型重回前沿

Meta发布816B参数开源模型Muse Spark Open,性能接近DeepSeek V4.1 Flash,标志着美国开放权重模型重新回到前沿竞争行列,缩小了与国产模型的差距。
开放权重的天平,终于往回摆了一点
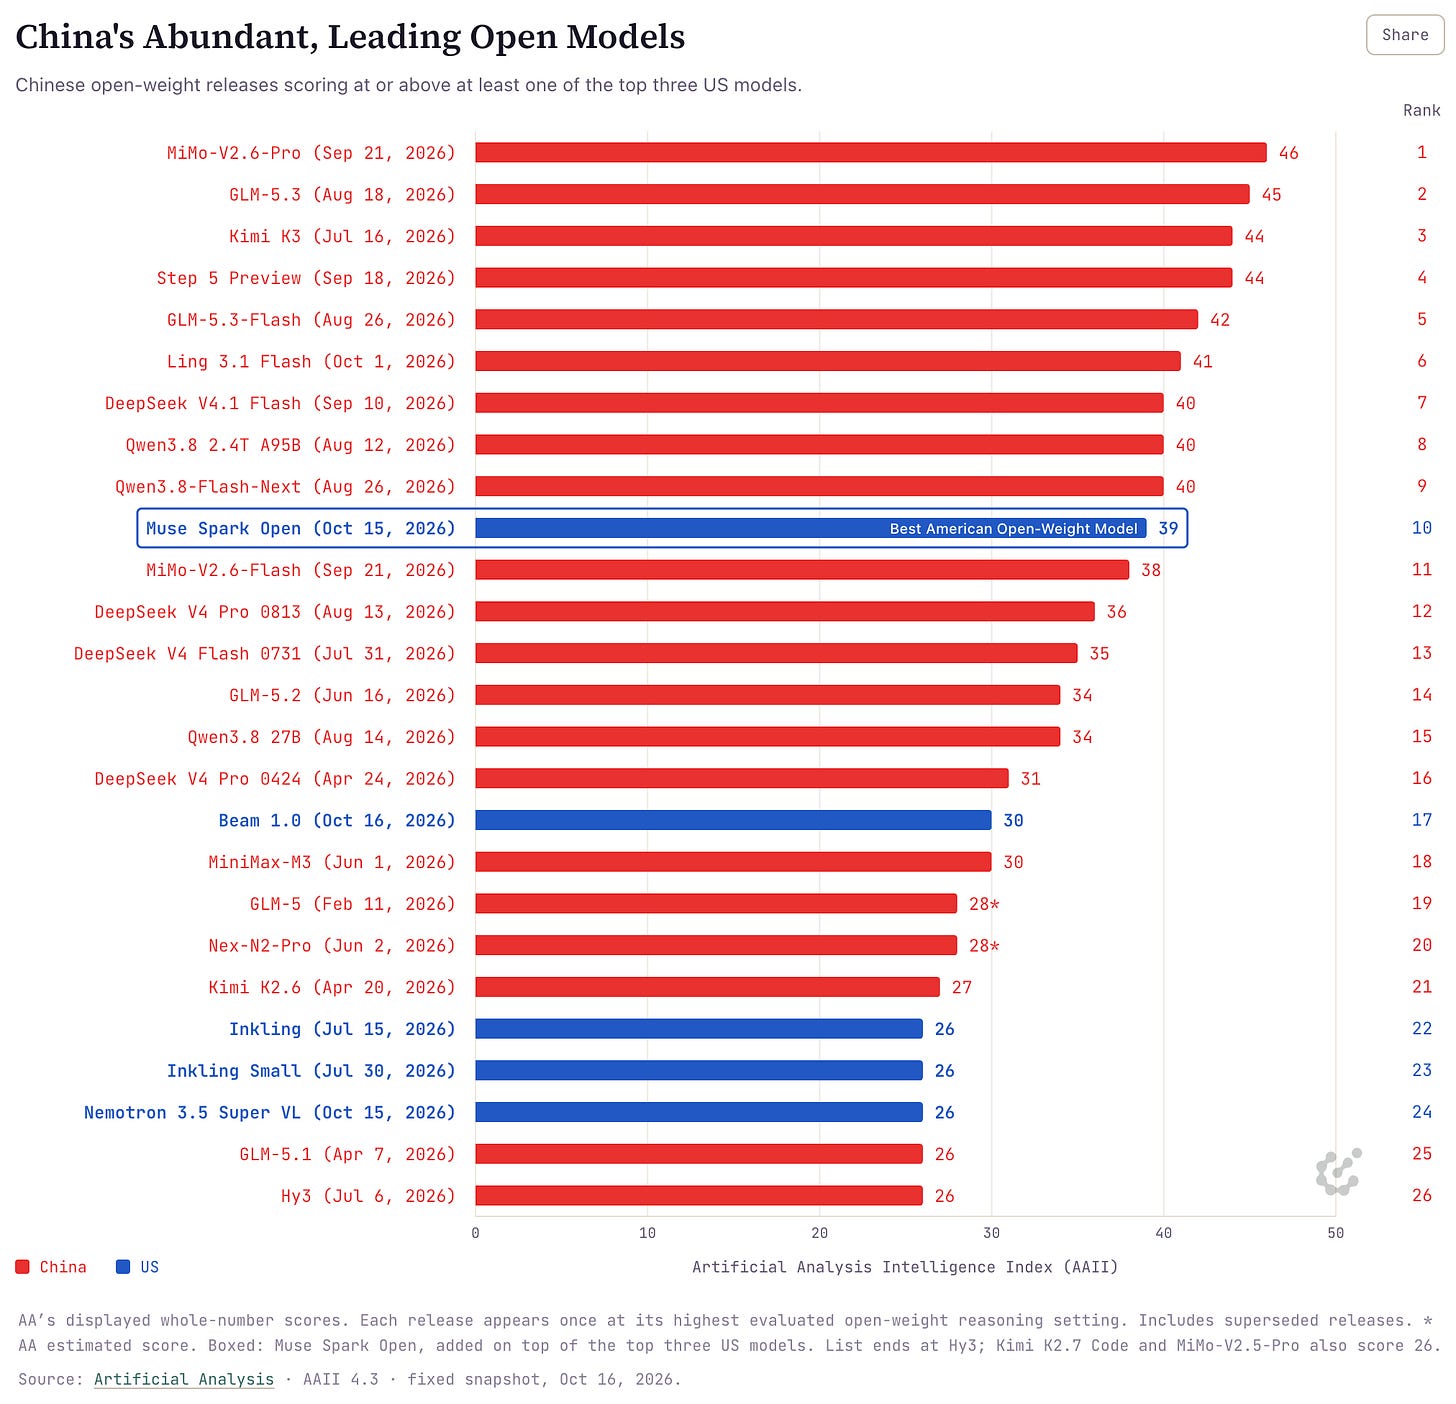
2026年10月中旬,美国开放权重模型经历了一次明显的回摆。Meta 发布的 Muse Spark Open 以相当大的优势成为当前最强的美国开源模型,而 Reflection 的首款模型 Beam 也同期加入战局。如果没有这两者,当时会有 20 多个中国公司开源的模型在性能上超过最好的西方开源模型。
与此同时,Mistral 也宣布了一个评分为 38 的 Mistral Large 4,但权重尚未公开。更多美国开源模型也在传闻之中。
Muse Spark Open 的核心规格
根据 Hugging Face 上的模型卡信息:
- 总参数 816B,激活参数 42B(MoE 架构)
- 上下文窗口 1M tokens
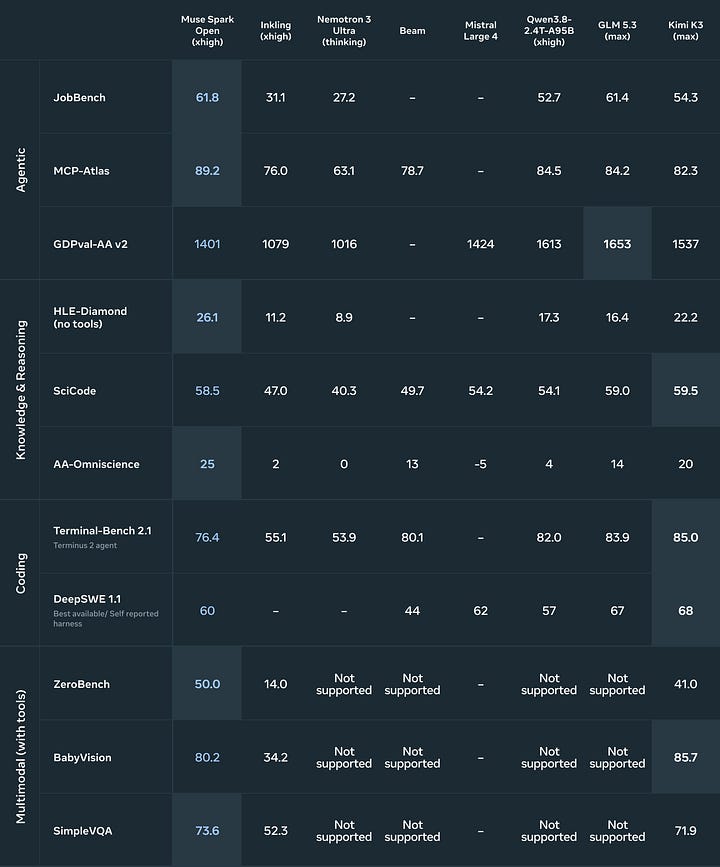
- 原生多模态,面向 编码与 Agent 工作流
- 开源版本额外做了安全后训练,降低无系统护栏时的滥用风险
- 官方建议将其作为更大 AI 系统的一部分部署,配合特定场景的护栏
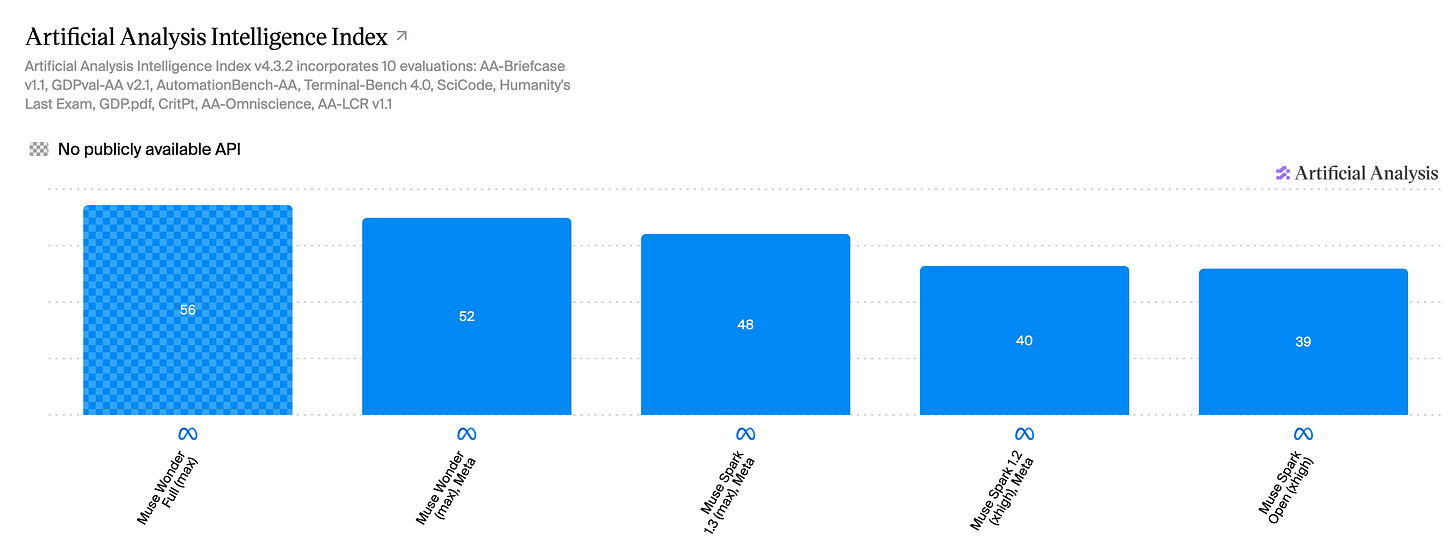
关于这个版本的来源,社区曾猜测它是 Muse Spark 1.3 在安全训练中"损坏"的结果。但更合理的解释是:它其实是 Muse Spark 1.2 的安全调优版,在 Artificial Analysis 智能指数上仅下降约 1 分,以换取更安全的行为。
性能定位:够用了,但还差一步
在 Artificial Analysis 智能指数上,Muse Spark Open 的性能大致位于:
- 高于 GLM 5.2
- 接近 DeepSeek V4.1 Flash
- 低于 GLM 5.3 和 Kimi K3
GLM 5.3 和 Kimi K3 分别于 8 月 18 日和 7 月 16 日就已发布。换句话说,中国模型领先了几个月,但 美国与中国的最佳开源模型之间的差距,大约缩小了一半——从"对消费者基本无关"变成了"落后但相关"。
为什么 Muse Spark Open 可能起飞
Interconnects 的长期观察显示一个反复出现的现象:性能相近的西方开源模型,获得的采用率远高于中国模型,即使中国模型通常先发布。Muse Spark Open 恰好落入了一个需求正在加速释放的环境:
- 开放域 LLM Agent 终于真正可用(约 GLM 5.2 水平)
- 推理服务商在快速扩容
- 开放后训练经济正在形成
- 大量企业希望"拥有自己的智能"
对开发者来说,这意味着:如果你正在搭建编码助手、Agent 工作流或多模态应用,Muse Spark Open 已经是一个 性能达标、生态友好 的选择,尤其是对于需要本地部署或数据不出域的团队。
对谁有价值
| 角色 | 价值点 |
|---|---|
| 独立开发者 | 1M 上下文 + 原生多模态,适合长文档处理和复杂 Agent 编排 |
| 企业 AI 团队 | 开源权重可私有部署,避免数据外泄,配合护栏可控风险 |
| 模型研究者 | MoE 架构(816B/42B 激活)提供了前沿效率参考 |
| 推理服务商 | 又一个高性能开放模型,可丰富推理平台的产品线 |
竞争格局的微妙之处
这一周展现的是前沿模型业务的残酷竞争本质:Reflection 和 Mistral 公布分数后,Meta 赶在它们放出权重之前,率先开源了一个更聪明的模型。所有西方模型都在追赶几个月前就已发布的中国模型——整个行业都在问:Kimi 和智谱在 GLM-5.3 和 Kimi K3 之后,接下来会做什么?
这个问题很微妙,值得单独展开。但今天的核心信息是:Meta 的转向已经发生,开放权重生态的格局正在被重新洗牌。