Gemini 4 Argon:百万 token 输出窗口的实战解读
Google Gemini 4 Argon 将输出上限提升至 100 万 token,统一窗口设计告别手动分块,但终端任务表现和单次调用成本需要开发者重点关注。
Gemini 4 Argon:百万 token 输出窗口的实战解读
为什么这篇测评值得关注
大多数新模型的发布评测都是"全线碾压",但 Argon 的基准测试图表有一个值得注意的矛盾:它在仓库级软件工程任务上排名第一,却在终端操作类任务上明显落后。同时,一次不经意的 API 调用就可能产生 10 到 20 美元的费用。这种不均衡恰恰比完美的成绩单更有参考价值——因为模型最终要解决的是你每周实际面对的那些具体工作,而不是四十个基准测试的平均分。
发布节奏与接入方式
Google 于 2026 年 9 月 30 日宣布 Argon,前两周仅向经审核的安全防御者开放,通过 Fairwind 项目提供,Wiz 等早期测试方参与验证。10 月 13 日,Argon 正式面向开发者,通过 Gemini API 付费层和 AI Studio 接入,Antigravity 则面向 Google AI Ultra 订阅用户。
模型 ID 为 gemini-4-argon,另有 gemini-4-argon-cyber-permissive 面向授权防御者,普通开发者可以忽略后者。
Argon 采用稀疏混合专家 Transformer 架构,知识截止于 2026 年 3 月。输入支持文本、代码、图片、音频、视频和 PDF,但输出仅限文本和代码——它无法生成图表,这一点在讨论长文本生成时挺有意思。
核心变化:百万 token 统一窗口
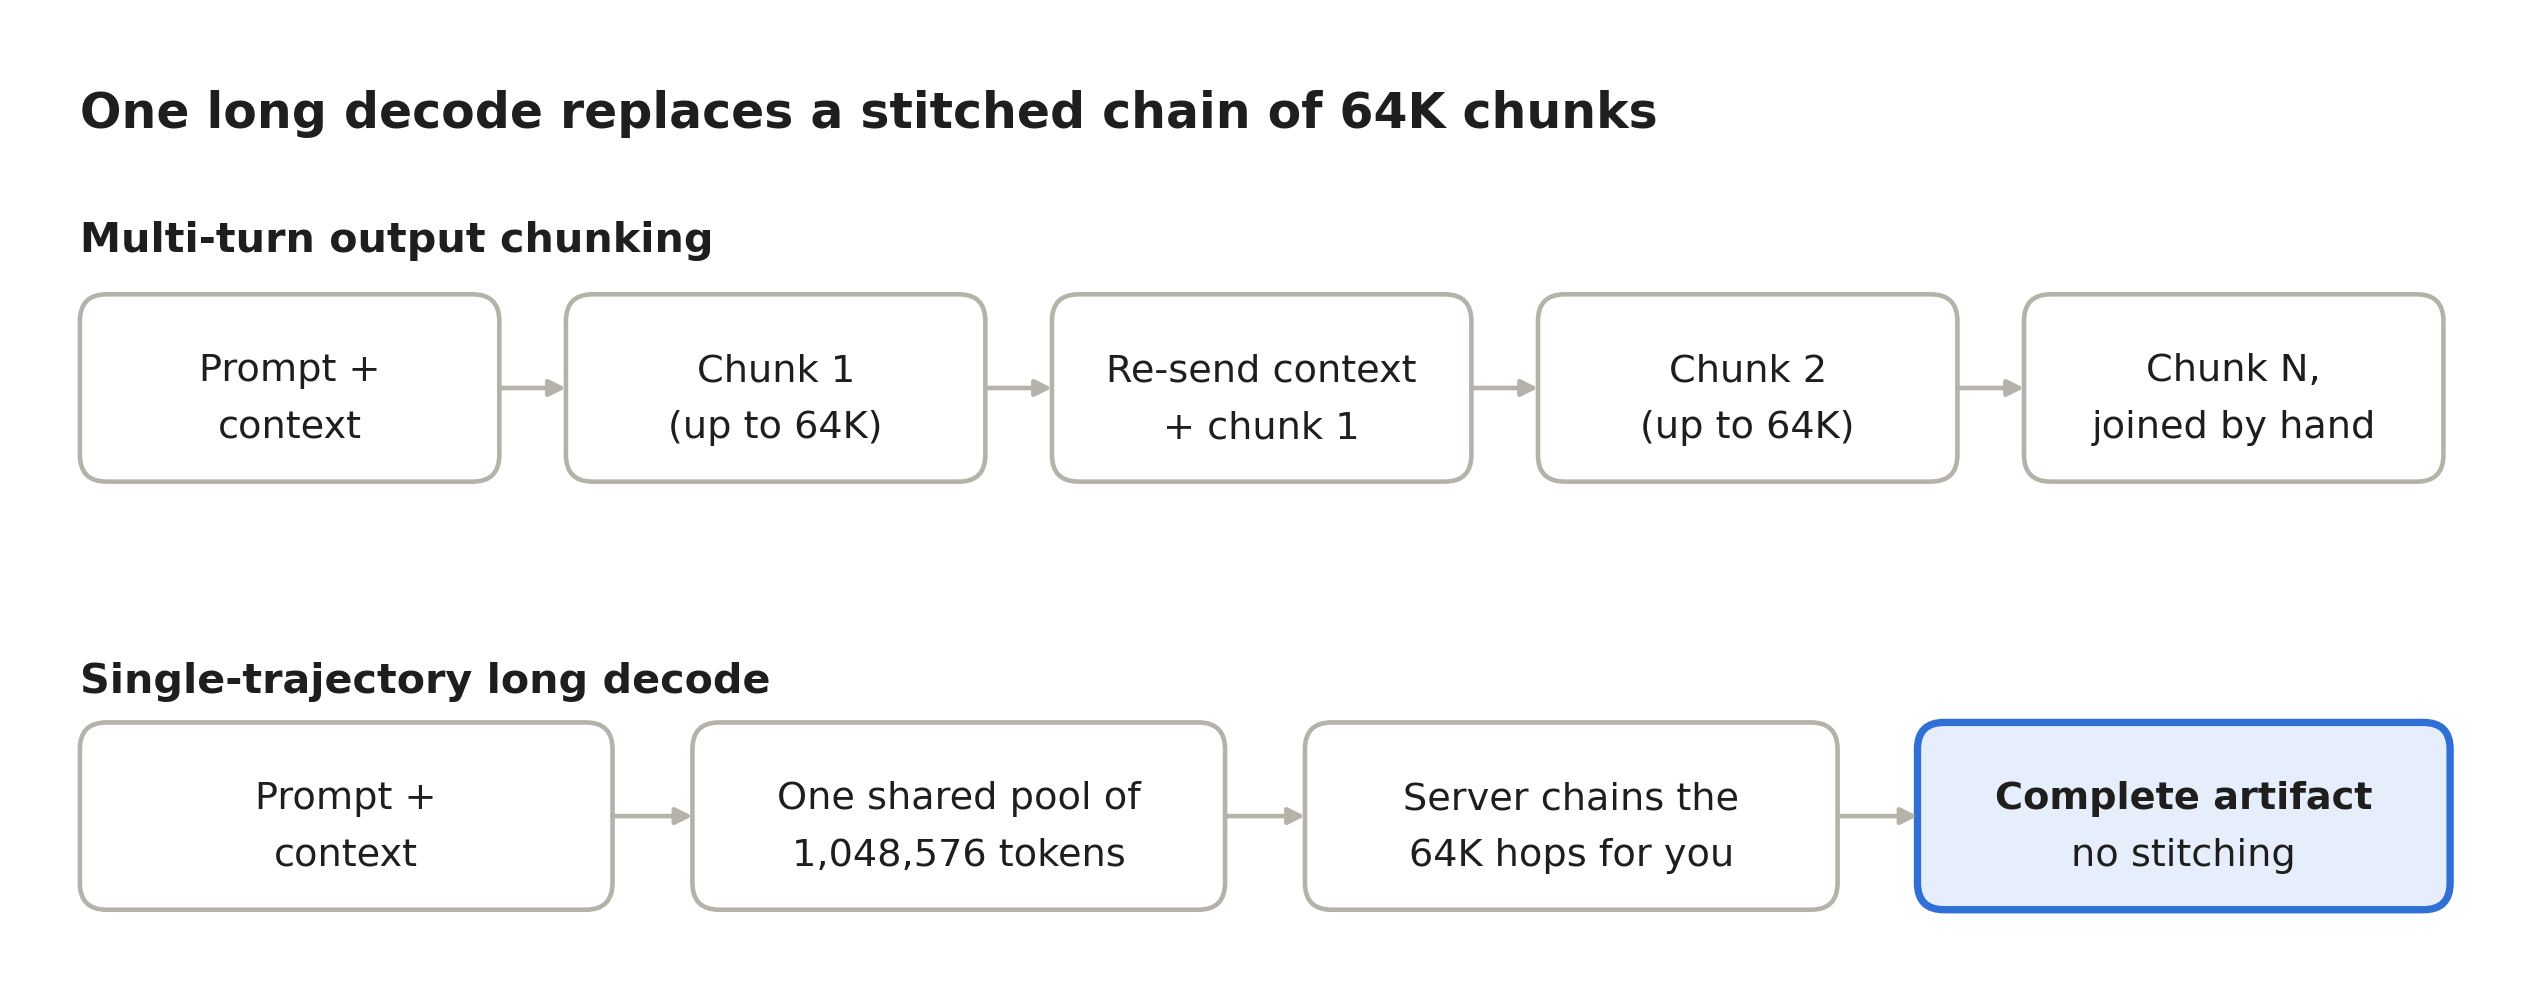
这是 Argon 最值得关注的改进。此前的 Gemini 模型输入约 100 万 token,输出上限仅 64K。Argon 将输出上限提升至 1,048,576 token,采用统一窗口设计——输入、思考过程和输出共享同一个池子。这意味着一个 10 万 token 的提示词,仍留有约 95 万 token 的生成空间。
默认输出上限仍为 65,536 token,这是为了防止意外的账单。要突破这个限制,需要:
- 提高
max_output_tokens参数(上限为 1,048,576 减去输入量) - 启用 long decode 模式
两种 API 的调用方式不同:
- Interactions API:设置
background=True,Google 服务器会自动将 64K 的跳步链接成一个交互 - GenerateContent API:需要开发者自行处理续写逻辑
请求超出池子容量会返回 HTTP 400 错误。
为什么这很重要
过去处理大型生成任务,必须手动分块、逐块回传上下文、祈祷模型还记得第一块承诺了什么。Long decode 模式让服务器在统一池内完成链路,彻底告别手动分块的工作流。但需注意:long decode 可能运行数分钟,适合后台任务而非实时交互。
思考等级与破坏性变更
thinking_level 参数支持三个值:
| 等级 | 适用场景 |
|---|---|
| LOW | 分类、摘要、元数据提取 |
| MEDIUM(默认) | 日常编码、工具调用、文档问答、视频分析 |
| HIGH | 多文件工程、数学证明、架构设计、漏洞挖掘 |
迁移时必须注意的破坏性变更
- 旧版整型参数
thinking_budget已废弃,调用返回 HTTP 400 MINIMAL设置同样已移除- 缓存策略变化:Argon 仅支持隐式缓存,折扣率为 95%
如果你在迁移现有代码,第一步就是用 grep 搜索 thinking_budget 和 MINIMAL,这两处不修改会直接报错。
对开发者的实用建议
- 先跑终端任务基准测试:Argon 在终端操作上表现不佳,如果你的工作流重度依赖命令行自动化,务必实测后再决定是否采用
- 设置成本护栏:单次调用可能达到 10-20 美元,在脚本中加入
max_output_tokens硬上限和调用频率限制 - 后台任务用 Interactions API:长生成场景优先使用
background=True,避免手动处理续写 - 迁移前 grep 检查:搜索并替换所有
thinking_budget和MINIMAL引用 - 注意输出格式限制:Argon 不输出图像,需要图表的场景需搭配其他工具
Argon 的百万 token 输出窗口是 Gemini 系列的重要里程碑,但它的表现并不均匀。对于以仓库级工程为主、终端操作为辅的开发者,它可能是一个值得尝试的选择——前提是你在脚本里加好了成本保护。