从零实现 Qwen3:深度解析架构与代码
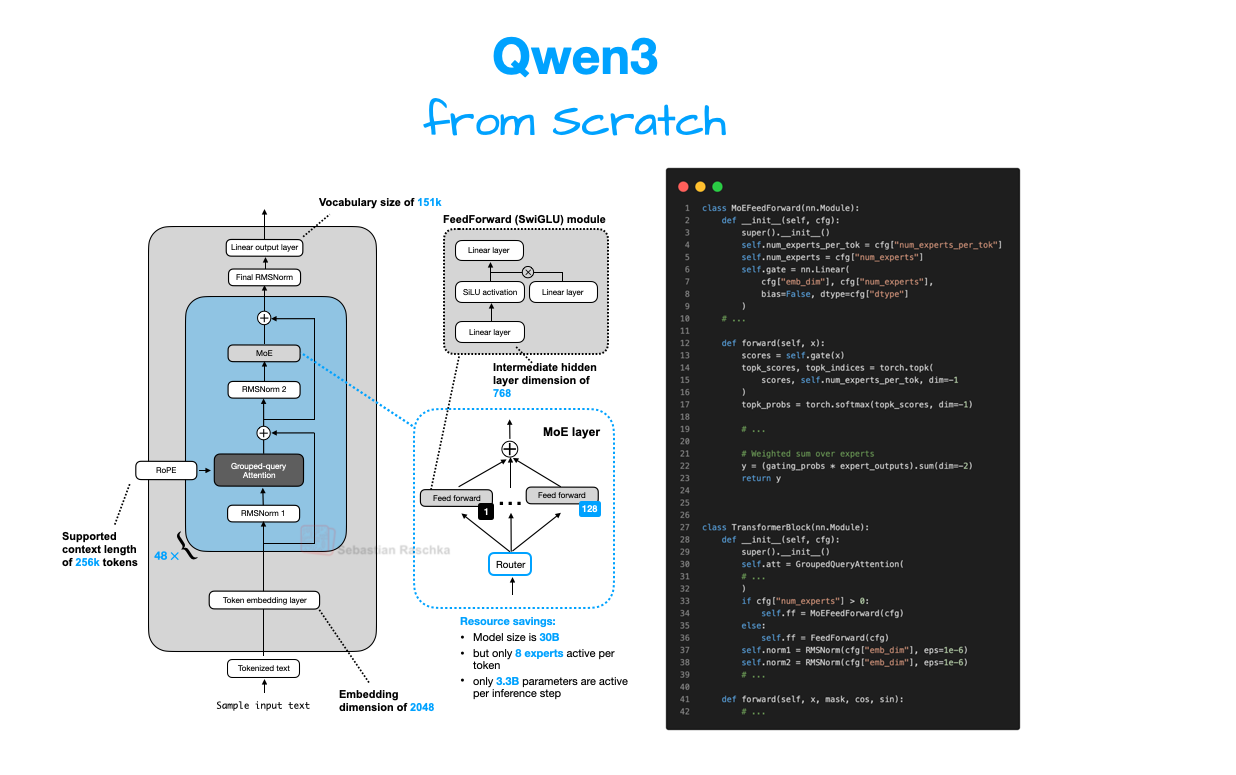
本文深入剖析 Qwen3 架构,通过纯 PyTorch 从零构建模型,解析其开源优势、性能表现及设计细节。
2025-09-06 0来源:Ahead of AI
从零实现 Qwen3:深度解析架构与代码
对于开发者而言,仅仅调用大语言模型(LLM)的 API 往往是不够的。理解模型“黑盒”背后的运作机制,掌握核心组件的实现逻辑,才是进行深度定制和创新的关键。资深研究员 Sebastian Raschka 在本文中,将带领我们从零开始,通过纯 PyTorch 代码复现 Qwen3 的核心架构。
为什么选择 Qwen3?
Qwen3 是目前开源社区中备受青睐的模型家族之一。作者认为它具备以下显著优势,使其成为从零实现的最佳选择:
- 无限制的开源协议:采用 Apache License v2.0,相比许多仅提供“开放权重”的模型,Qwen3 不附加额外的使用限制,对商业开发者和个人研究者都极为友好。
- 顶级的性能表现:截至 2025 年 9 月,其开源的 235B-Instruct 变体在 LMArena 排行榜上排名第 8,性能直逼闭源界的 Claude Opus 4。在同等规模的模型中,仅有 DeepSeek 3.1 和 Kimi K2 等更大参数量的模型能超越它。
- 极高的灵活性:模型家族覆盖了从 0.6B 的轻量级密集模型到 480B 的混合专家(MoE)模型,开发者可以根据自身的算力预算和应用场景,选择最合适的模型规格。
- 行业标杆的延续:2025 年 9 月 5 日,Qwen3 发布了 1T 参数的“Max”版本,在各项基准测试中击败了 Kimi K2、DeepSeek 3.1 和 Claude Opus 4,尽管该版本目前为闭源,但展现了该系列强大的技术实力。
架构核心:从 Dense 到 MoE
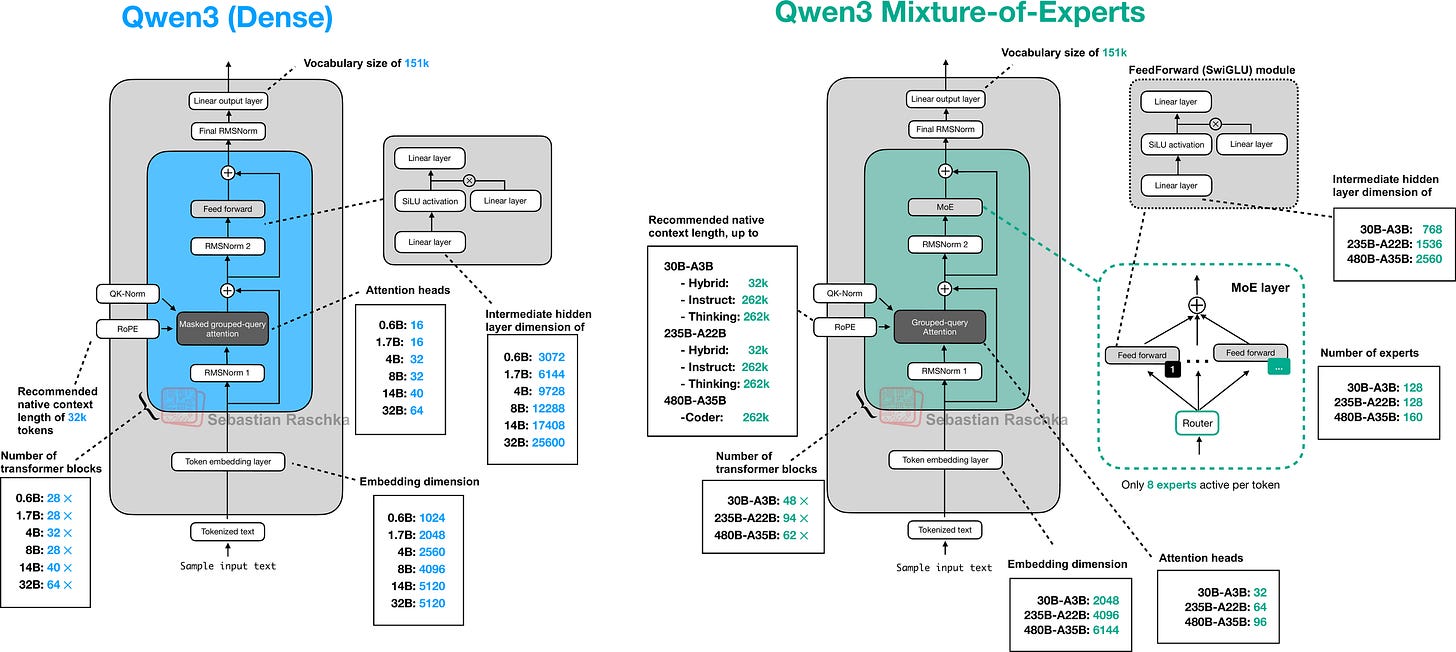
本文的核心代码将涵盖 Qwen3 的两种主要架构形态:
- Dense 架构:传统的全连接层设计,适合参数量相对较小、显存占用可控的场景。
- Mixture-of-Experts (MoE) 架构:一种稀疏激活的架构,通过路由机制选择部分专家网络进行处理。虽然本文重点在于理解 Dense 架构,但 MoE 的设计思想对于构建超大规模模型至关重要。
实战价值与收获
对于读者来说,这篇长文不仅仅是代码的堆砌,更是一次深度的技术洗礼:
- 底层逻辑可视化:通过阅读纯 PyTorch 代码,你将直观地看到 Transformer 组件是如何具体实现的,比单纯阅读概念图更易于理解。
- 构建模块化能力:文章提供的代码块是高度模块化的。开发者可以将其中的组件提取出来,适配到自己的实验项目中,快速搭建原型。
- 优化与调试基础:了解底层实现有助于在模型微调或推理优化时,精准定位性能瓶颈,做出更有针对性的改进。
总的来说,这是一份献给希望深入理解现代 LLM 架构的极客的实战指南。