从 GPT-2 到 gpt-oss:OpenAI 架构演进与本地运行实战
OpenAI 发布首个开源权重模型 gpt-oss-20b/120b,本文深度解析其架构细节,重点介绍 MXFP4 量化技术如何实现单卡本地运行,并与 Qwen3 等模型进行对比。
从 GPT-2 到 gpt-oss:OpenAI 架构演进与本地运行实战
OpenAI 终于打破了自 2019 年 GPT-2 以来对大模型权重的封闭,发布了 gpt-oss-20b 和 gpt-oss-120b。这两款模型不仅填补了开源领域的空白,更通过巧妙的工程优化,让开发者能够在本地硬件上运行这些庞然大物。
开源里程碑与架构概览
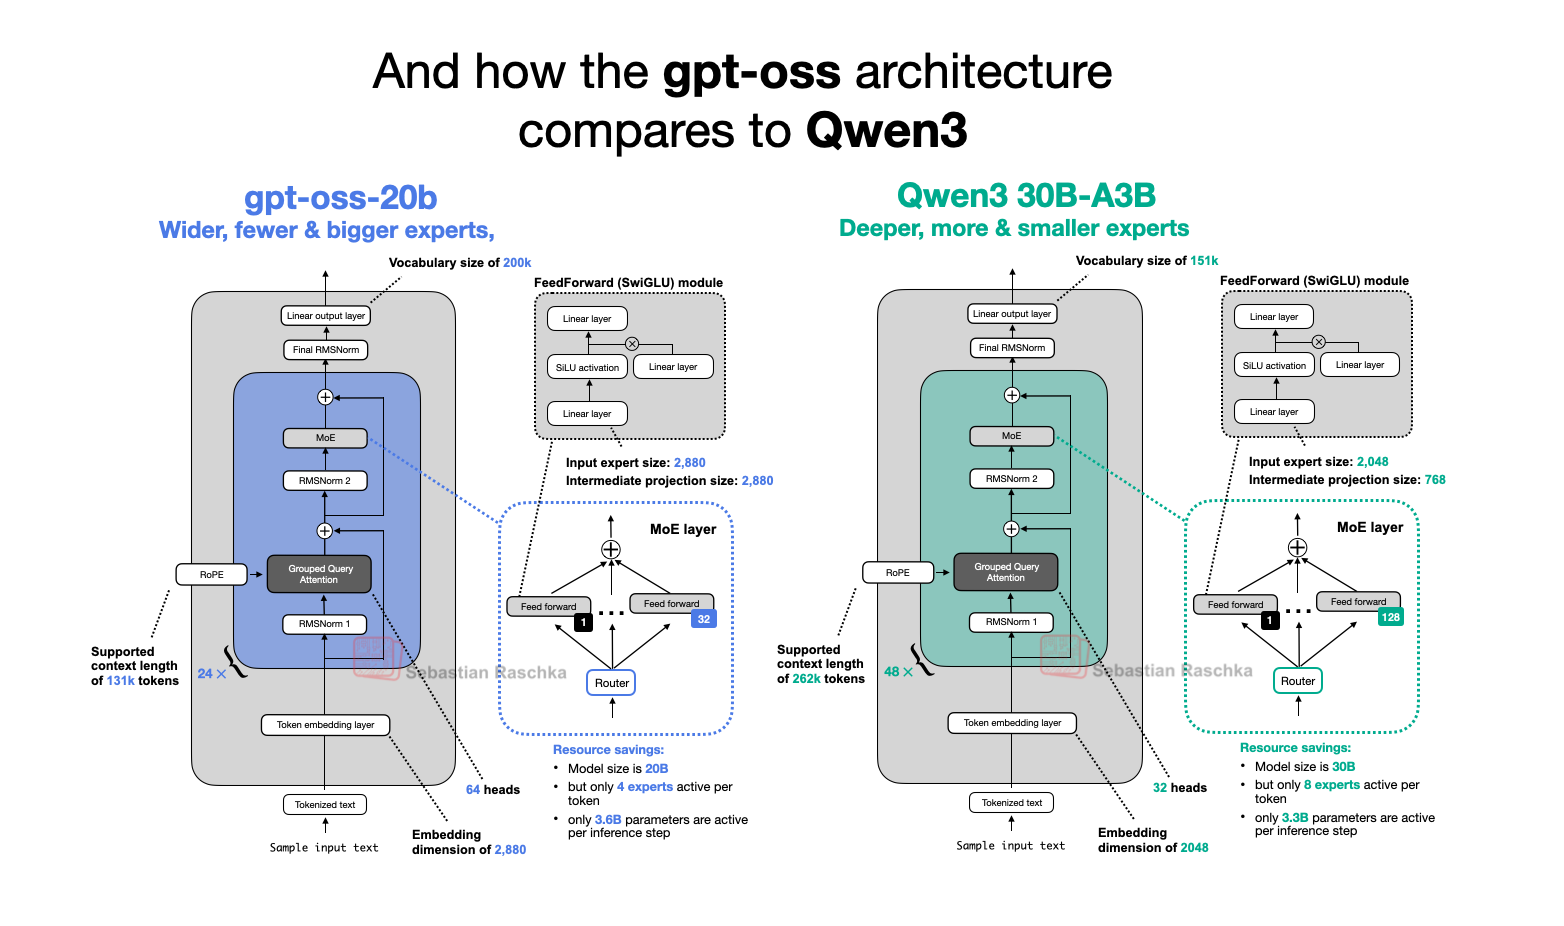
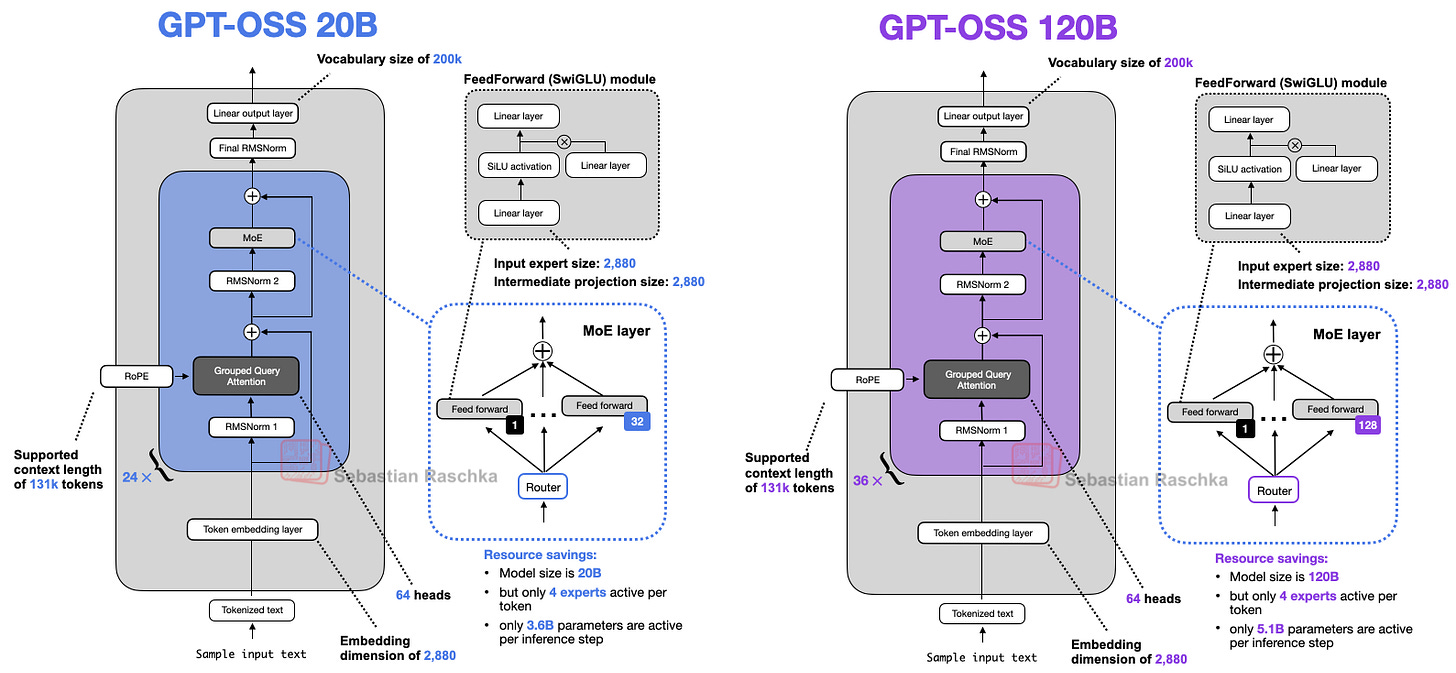
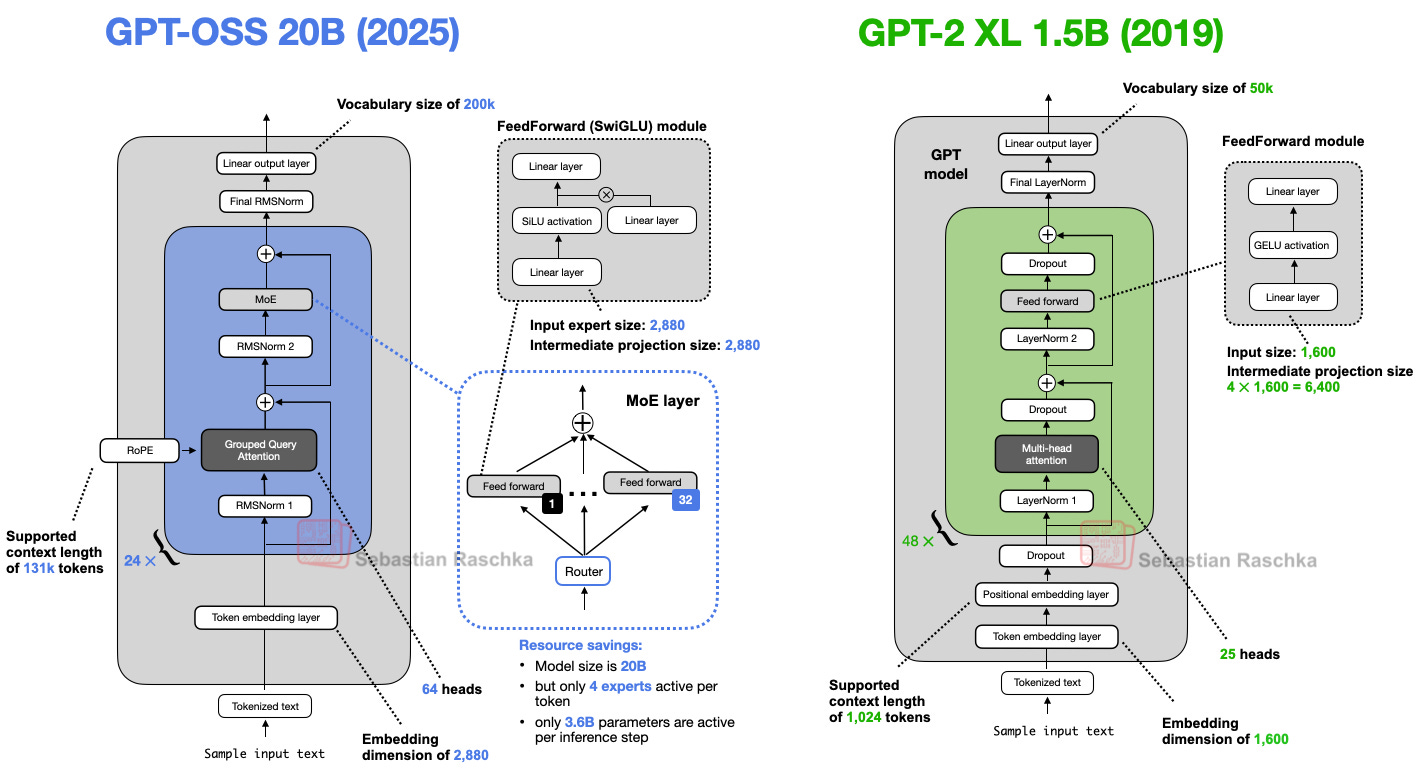
对于开发者而言,能够直接访问模型权重意味着可以进行深度定制和私有化部署。从架构上看,gpt-oss 并没有带来颠覆性的创新,本质上依然沿用了成熟的 Transformer 架构。这并不意外,目前业界主流模型在设计上高度趋同,核心性能的提升更多依赖于数据规模、算法微调而非架构的根本性变革。
尽管架构“平淡”,但细节设计依然值得关注。作者 Sebastian Raschka 通过代码分析发现,模型在宽度与深度的权衡、注意力机制(如注意力偏置 Attention Bias 和注意力汇 Attention Sink)等方面进行了针对性的调整,这些微调在长文本处理和多轮对话中可能起到关键作用。
MXFP4 量化技术:本地运行的关键
本文最核心的实用价值在于揭示了 MXFP4 量化格式 的应用。OpenAI 通过这一技术,大幅压缩了模型体积,使其能够适应消费级硬件。
- 20B 模型:仅需单张消费级显卡,16GB 显存即可流畅运行。
- 120B 模型:得益于 MXFP4 的高效压缩,可在单张 H100 (80GB) 显卡上运行。
这意味着,开发者无需动用昂贵的集群,就能在个人工作站或云端实例上体验 GPT-2 以来最大的开源模型。具体部署可参考 Hugging Face 上的官方仓库链接。
与 GPT-5 的距离与未来展望
在模型发布前夕,OpenAI 宣布了 GPT-5 的存在。虽然 gpt-oss 系列展示了当前架构的极致优化,但距离 GPT-5 的能力仍有差距。目前的混合架构模型(如 Hunyuan-TurboS)在排行榜上表现不俗,证明了 Transformer 结合其他模型形式的潜力。
对于 AI 使用者来说,gpt-oss 的出现降低了门槛。你可以利用本地 20B 模型进行代码生成、写作辅助或知识问答,无需担心隐私泄露,且运行成本远低于 API 调用。
总结:gpt-oss 的发布证明了 Transformer 架构的持久生命力,而 MXFP4 技术则是连接“大模型能力”与“本地硬件”的重要桥梁。
本文目录(3 节)
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:From GPT-2 to gpt-oss: Analyzing the Architectural Advances
阅读原文