AI 电脑为何死磕内存带宽
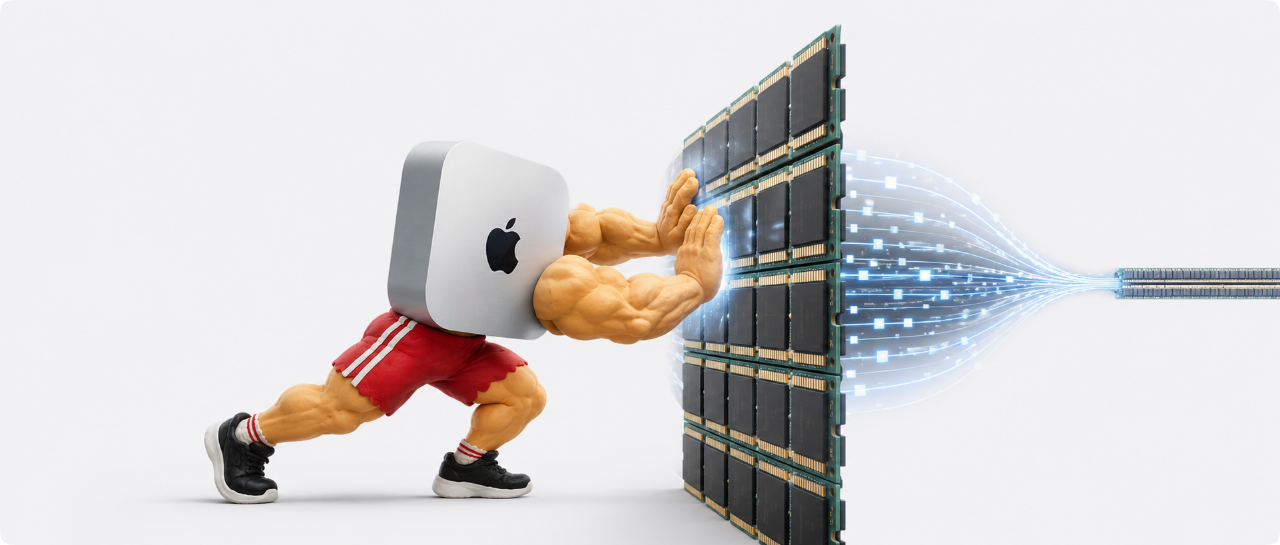
苹果、小米、英伟达新品齐拼内存带宽,背后是 AI 算力被「内存墙」卡住的物理宿命。本文拆解带宽与容量的区别,以及芯片界的四种破局思路。
当 AI 从屏幕里破壳而出
智能手机统治了过去十几年的数字生态,但它的全部逻辑都止于屏幕——为「人盯着它」而生。AI 的需求恰恰相反:它需要持续感知物理世界,随时在场,而非等你解锁屏幕才醒来。当 AI 成为基础能力,它迟早要从屏幕里破壳而出,寻找属于自己的形状。
这也是「AI 器物志」持续观察的方向:AI 如何改变硬件设计,如何重塑人机交互,以及将以怎样的形态进入日常生活。本文是该栏目第 23 篇。
一场不约而同的「带宽军备赛」
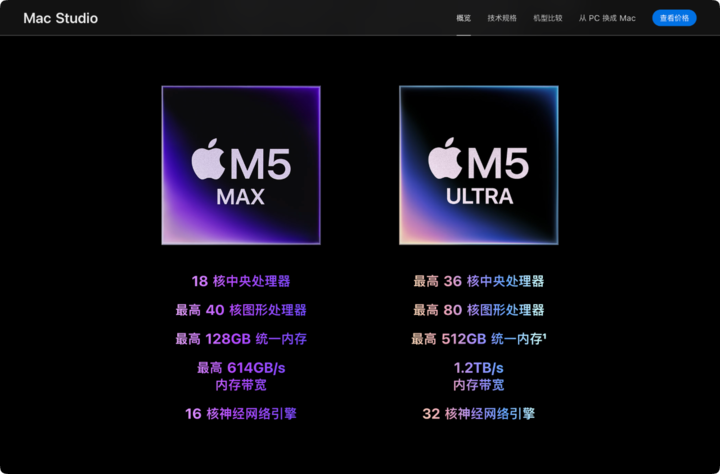
苹果新 Mac 再次刷新了「AI 电脑」的性能预期:小巧的 Mac mini 被官方定义为全天候跑 Agent 的生产力工具,专业级 Mac Studio 更是给到最高 512GB 统一内存。但真正「强」的地方,藏在一个过去不太被关心的参数里——内存带宽。
- 标准版 M6 统一内存带宽达 170GB/s
- M5 Pro 版本推到 307GB/s
- 顶配 M5 Ultra 跨过 TB 级大关,干到 1.2TB/s
无独有偶。就在新 Mac Studio 发布前一天,小米公布的端侧 AI 加速芯片玄戒 O100,同样把内存带宽做到 1.22TB/s;英伟达最新的消费级旗舰显卡 RTX 5090,凭借 32GB GDDR7 显存,带宽更是顶到接近 1.8TB/s。
桌面 SoC、端侧专用 NPU 与独立 GPU 的架构路径大相径庭,但做电脑的、做手机芯片的、做显卡的,都在干同一件事——让内存里的数据跑得更快。
算得越快,越容易「吃不饱」
芯片厂费这么大劲拼带宽,说到底是因为今天的 AI 越来越能算,也越来越容易被内存「饿着」。
很多人第一反应是:内存不就是看容量吗?其实容量和带宽是两码事。容量决定这台电脑能装下多大的模型,带宽决定这些数据每秒能以多快的速度喂给计算核心。大模型跑起来后,最消耗资源的往往不是单纯计算,而是贯穿始终的「搬数据」。
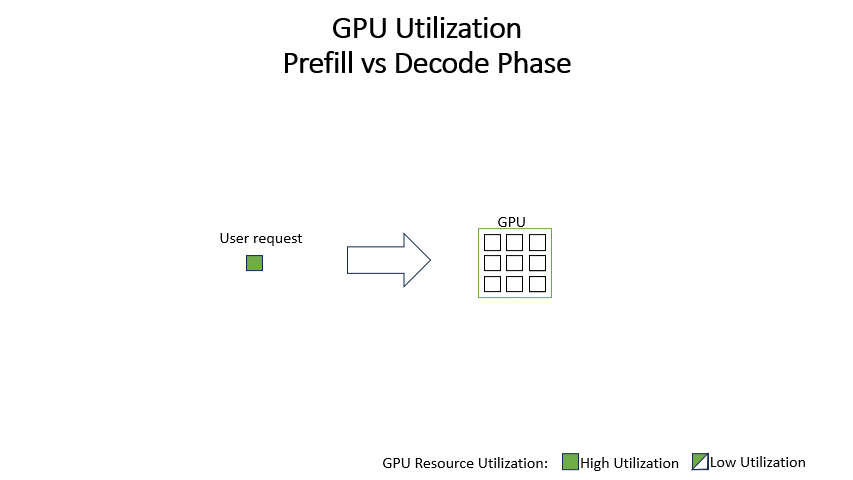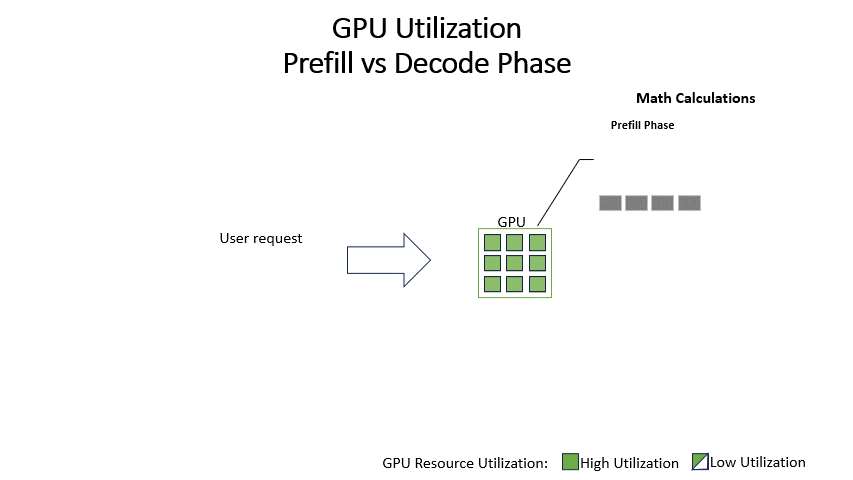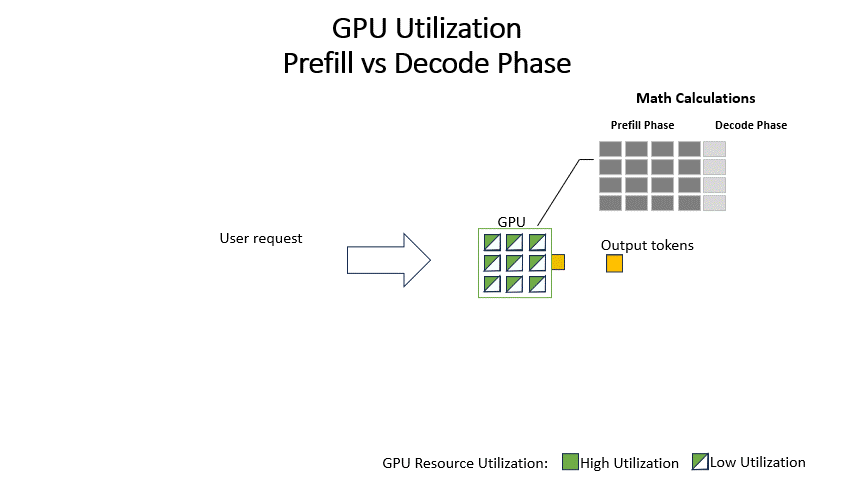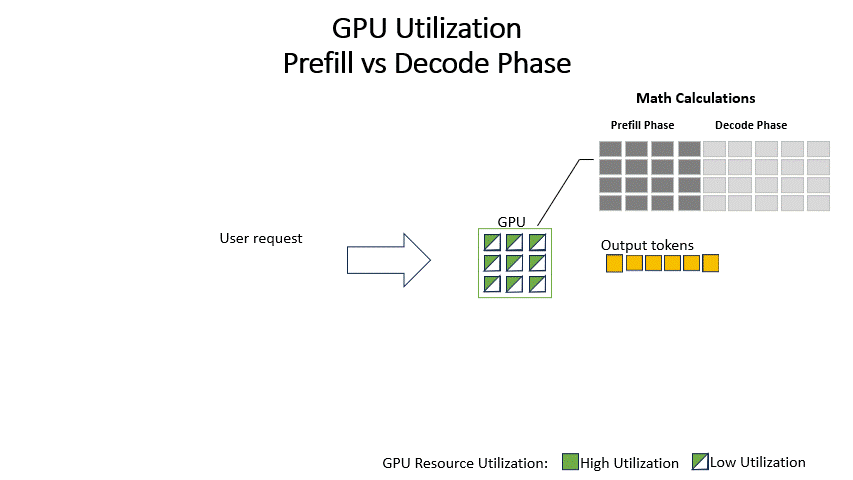
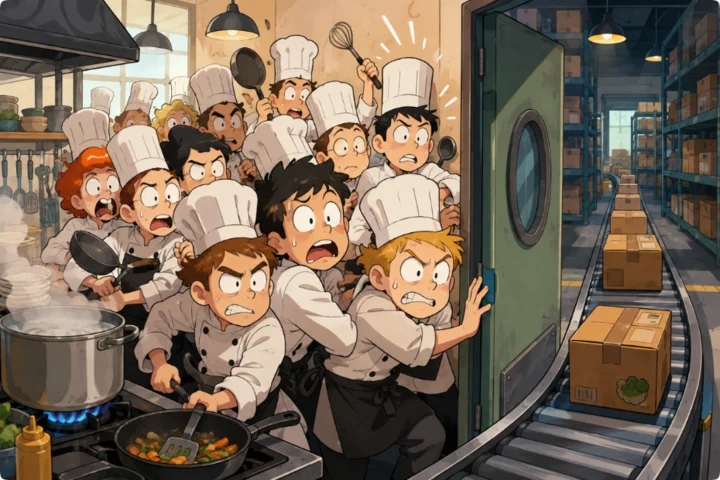
在自回归生成(Decode)阶段,计算单元每生成一个新 token,就必须把内存里几十亿、上百亿的参数权重完整读取一遍。就像后厨里手速极快的大厨,翻炒只要两分钟,但配菜师傅半天才送来一盘切好的食材——大厨炒得再快,大部分时间也只能握着锅铲干等。
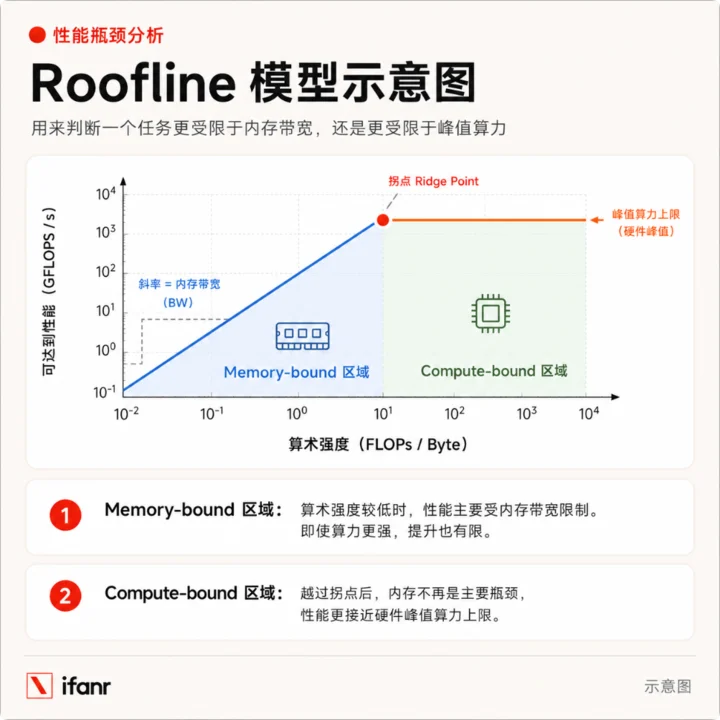
不管 CPU、GPU 还是 NPU,现在都卡在这道坎上。算力一路狂飙,内存通道的拓宽速度却跟不上。模型小还能凑合,一旦上了几十 B、几百 B 的大模型,每吐一个词都要吞吐海量数据。计算单元再能算,也只能把大把时间耗在等内存喂饭上——这在体系结构中被称为 memory-bound(内存受限)。
更快的内存,也更贵
很多人直觉上觉得「32GB 肯定比 16GB 贵」,但放进半导体供应链,真正的规律是:越大的内存越贵,越快的内存贵得呈指数级上升。
要让海量数据跑得更快,不能只靠堆颗粒,还要用更宽的位宽、更高频的接口,以及极复杂的先进封装与垂直堆叠。以 AI 服务器标配的 HBM 为例,它把多层 DRAM 芯片垂直打孔堆叠(TSV),制造难度和芯片面积远超传统内存。
这种对超高带宽的极端渴求,正在上游掀起全球性的「产能大迁徙」。TrendForce 数据显示,由于 AI 数据中心对 HBM 和高规格服务器 DDR5 需求暴增,三星、SK 海力士和美光三大存储巨头正全力把有限先进晶圆产能向企业级倾斜,直接挤压消费级 PC DRAM 的供给空间,即便传统淡季,合约价格仍持续环比上涨。
去年底,美光宣布逐步退出 Crucial(英睿达)消费级内存业务,把资源全面倒向规模更大、利润更高的战略客户;国内 SK 海力士第三方品牌授权店终止运营,也折射出上游原厂对消费级渠道的冷落。普通装机者加装一根内存条的预算,无形中正和全球 AI 数据中心抢夺同一批先进晶圆。
芯片界的四种破局思路
为了不让算力卡在数据搬运上,芯片界从不同维度给出解法:
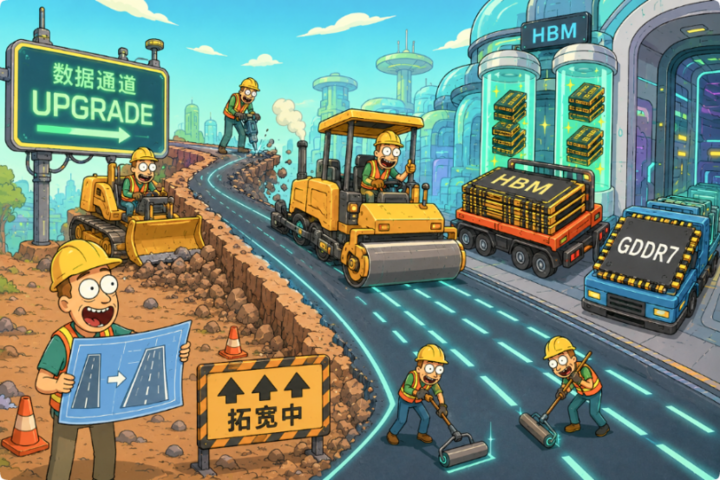
物理加宽车道:GDDR7 与 HBM。最直观的办法是「大力出奇迹」。RTX 5090 采用 512-bit 超宽位宽配合 GDDR7,硬把带宽拉到 1.8TB/s;AI 数据中心则在 GPU 身边紧挨着塞进一圈 8 层、12 层的 HBM 堆栈。简单粗暴,代价极其高昂。
把存储搬到计算隔壁:玄戒 O100 的 3D 堆叠。既然平面走线太长会有延迟和功耗,那就向立体空间要效率。玄戒 O100 采用晶圆级垂直堆叠,直接把两层 DRAM 晶圆压在 NPU 计算晶圆正上方,物理距离缩短到微米级,一口气换来 1.22TB/s 的端侧带宽。
消除冗余搬运与外部高速扩展:统一内存与雷雳 5。苹果统一内存解决的是「避免无谓倒手」——传统 PC 里 CPU 内存与 GPU 显存各占一边,数据要来回复制;统一内存体系下所有计算核心共享同一块内存池,少跑一趟就是在抢时间。当单台设备装不下超大模型时,M5 Pro 版 Mac mini 配备 3 个雷雳 5 端口,支持多台设备串成集群;Mac Studio 通过雷雳 5(最高 120Gb/s)和 RDMA 技术,4 台组建的分布式推理集群能跑出接近单机 3 倍的吐字吞吐。
把计算搬到内存旁边:PIM 与存内计算。再往前一步是更大胆的颠覆:如果数据搬运代价太大,能不能干脆把计算挪到存储旁边,让数据留在原地?PIM 会把部分计算单元直接塞进内存颗粒附近,避免数据反复回传;更进一步的存内计算(CIM),甚至尝试直接利用存储介质本身的物理特性完成矩阵乘加。尽管这类前沿架构在通用性和编译器生态上仍待成熟,但它指明了一个确定方向:未来的芯片设计,必须想方设法让数据少走几步路。
绕了一大圈,还是撞上「内存墙」
今天 AI 硬件折腾的这些问题,其实并不新鲜。
我们现在使用的大部分计算机,仍延续经典冯·诺依曼架构的基本思路:存储和计算分离。数据放在内存里,处理器负责计算,需要用时再通过总线搬运。这种设计赋予通用计算机极大灵活性,但也埋下三十年来始终无法摆脱的物理宿命:只要存算分立,数据就必须来回搬。
早在 1995 年,计算机科学家 William A. Wulf 和 Sally A. McKee 就发表过经典论文《Hitting the Memory Wall》。他们敏锐地注意到,处理器算力增速远快于内存带宽增速,剪刀差持续扩大,处理器终将把越来越多时间耗在等待数据上——这便是著名的「内存墙」。
三十年过去,这堵墙从未消失,只是大模型的爆发以前所未有的速度把整个行业推到了它面前。计算机关于「快」的度量衡也随之改变:以前衡量芯片,大家盯的是发布会 PPT 上的 TOPS、TFLOPS 和跑分;但今天,算力再高,只要数据送不过来,芯片也只能原地空转。
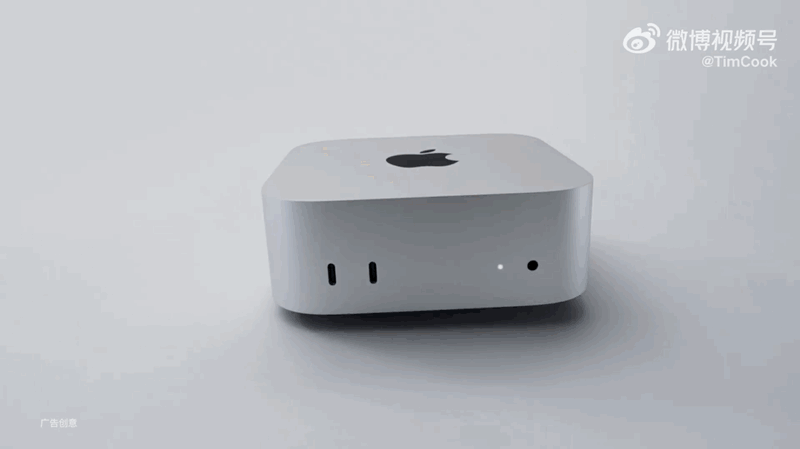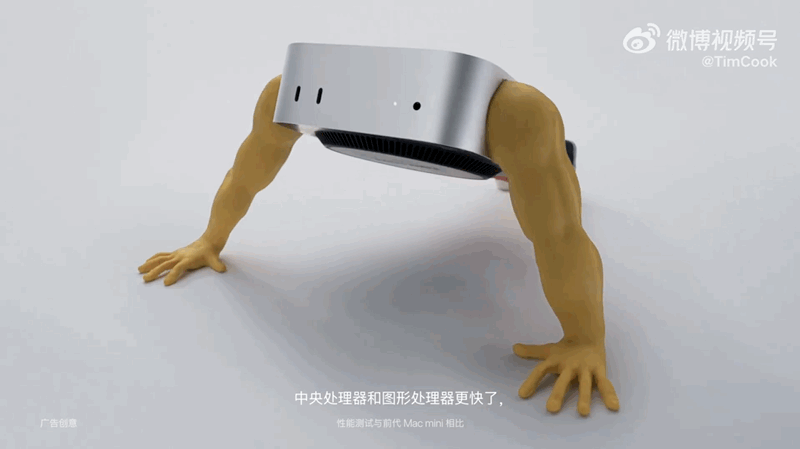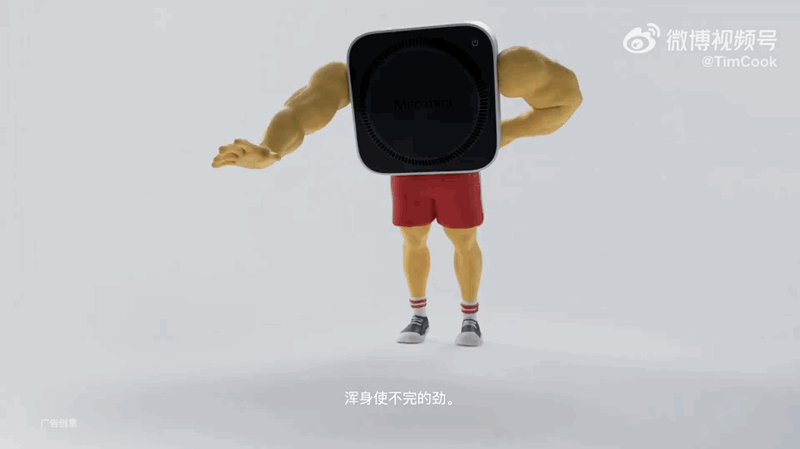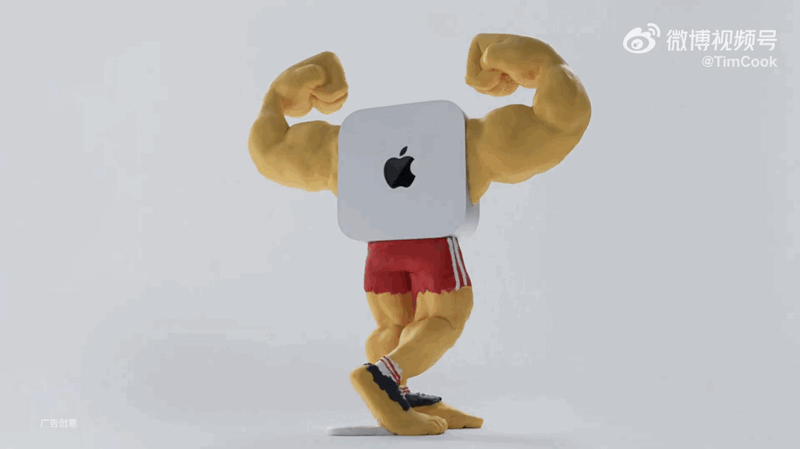
再回头看苹果那支 Mac mini 宣传片,小盒子上长出的粗壮肌肉胳膊,像极了过去几十年大家对「性能」最朴素的想象。但在 AI 时代,肌肉练得再大,如果原料和养料供不上,庞大的身躯也只能原地干等。
有意思的是,在这个连做张海报都能一键交给 AI 生成的时代,苹果这次给 Mac mini 拍宣传片反而罕见地用了「古法手作」:从草图起步,到手工雕刻微缩模型、焊接机械联动结构,镜头里那些稍纵即逝的机械变形与视觉特效,背后大多真有一个可以拿在手里的实体道具。
在全行业为纯虚拟的 AI 生成狂热时,苹果反倒花大量「笨功夫」打磨实体质感。这恰好就像今天芯片底层的处境——无论上层 AI 模型如何神乎其神,底层硬件系统依然无法逃避最朴素的物理法则;想要数据跑得快,那些实实在在的通道、走线和晶圆工艺,终究一步都偷不了懒。