MiniMax 转身:B端收入暴涨700%
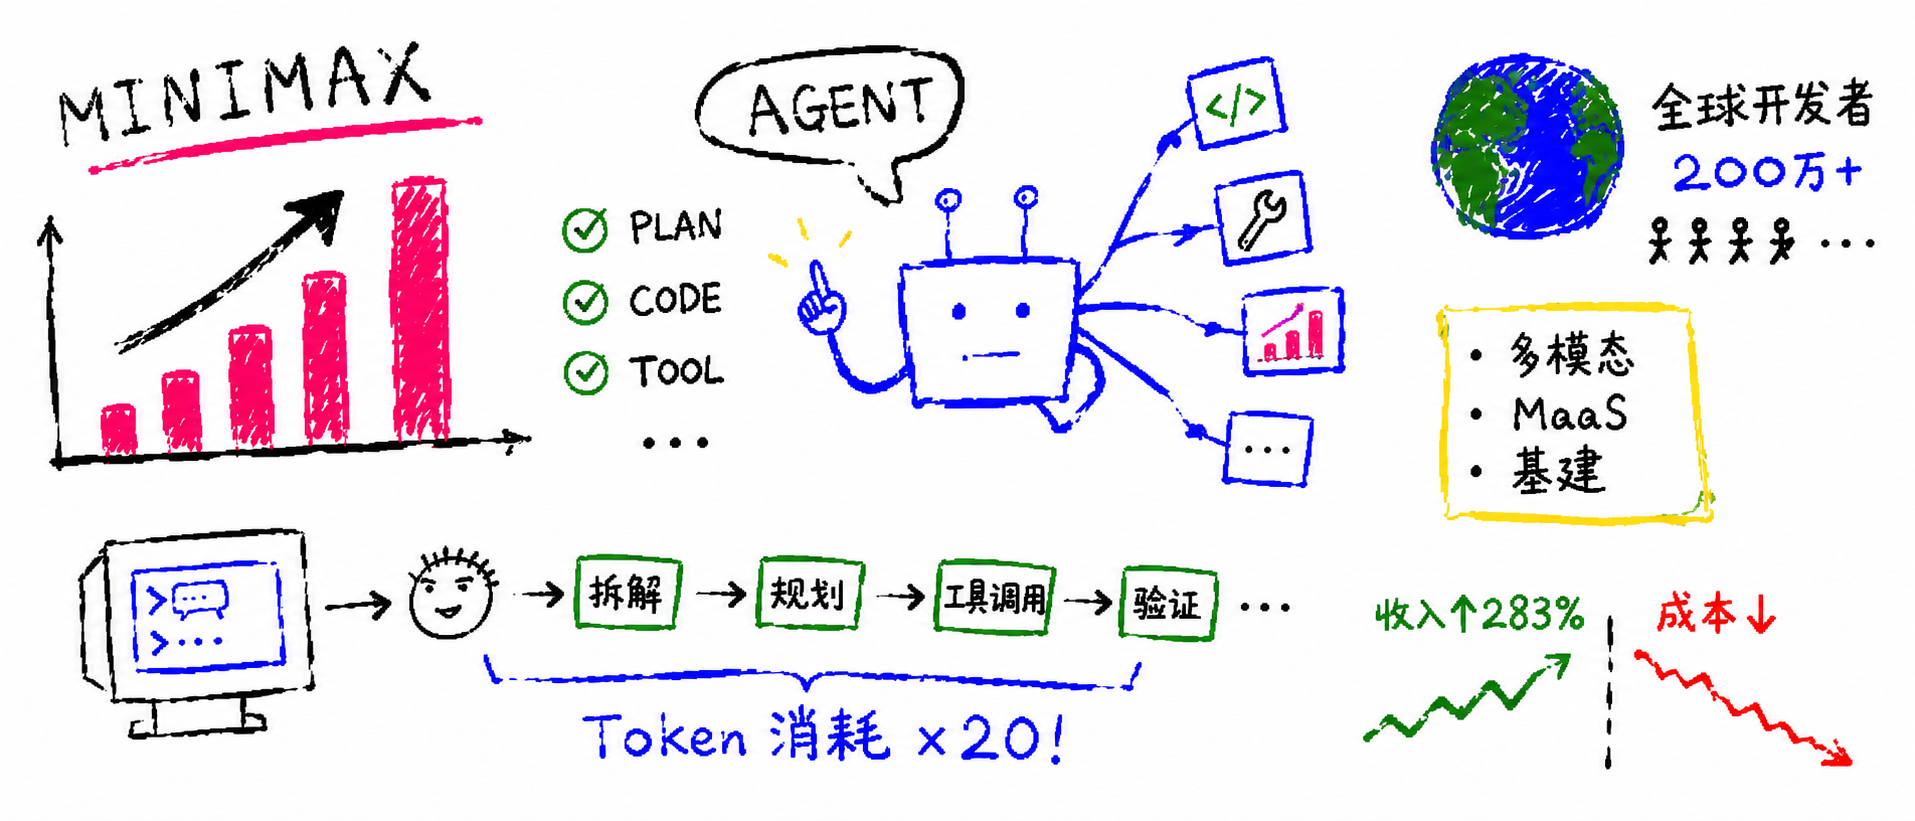
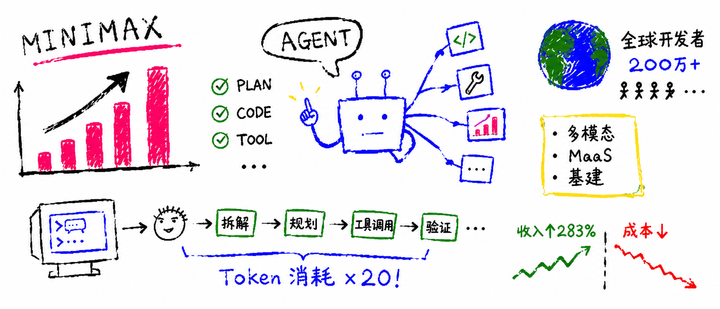
MiniMax 2026上半年营收1.2亿美元,B端占比飙升至63.4%,ARR达8亿美元,从C端公司转向算力底座,押注后训练与多模态开源。
从「C端公司」到算力底座:一年完成结构性迁徙
在很多人的印象里,MiniMax 还是那个靠 Talkie、星野和海螺 AI 被记住的「C端公司」。但最新发布的 2026 年中期财报显示,这家大模型独角兽的营收结构已经彻底倒挂。
一年前,消费端收入约占 70%,企业端仅约 30%;如今,B端业务收入高达 7390 万美元,同比暴增超 700%,占总收入比重从去年同期的 30.3% 飙升至 63.4%,一举成为公司最大收入支柱。
整体盘子也在迅速膨胀。2026 年上半年,MiniMax 实现总收入约 1.2 亿美元,同比增长 283.1%,仅半年就达到 2025 年全年收入的 1.5 倍。
收入狂飙的同时,销售开支反而降了
更值得关注的是增长质量的变化。
- ARR(年度经常性收入) 截至 8 月达到 8 亿美元,其中 To B 业务占比约 80%,To C 仅约 20%。
- 海外市场贡献约六成收入,全球化底色进一步凸显。
- 销售及分销开支同比下降 17.9% 至 2700 万美元,毛利同比增长 464.8% 至 2081 万美元。
- 净亏损从上年同期约 4 亿美元收窄至约 3.6 亿美元。
这意味着,MiniMax 已经告别了早期泛娱乐 C 端应用靠买量获客的阶段,转向由企业和开发者生态驱动的自然网络增长。
Token 消耗断层式拉升,模型消费范式已变
收入暴增的核心推手,是 Token 消耗量的非线性跃迁。仅今年 7 月,MiniMax 全平台 Token 消耗量就达到 1 月份的 20 倍。截至目前,其全球企业客户与开发者数量突破 200 万,是 2025 年底的 10 倍。
CEO 闫俊杰指出,模型消费范式已经从「人与 AI 的直接对话」,全面跃迁至「Agent 与 AI 的多轮级联交互」。由 Agent 驱动的推理需求增长,显著快于人类用户数和消息数的增长,直接导致单用户 Token 消耗呈倍数级爆发。
这背后还有一个新的行业共识:后训练正在成为 Scaling 的新上限。从近期智谱 GLM 5.3、DeepSeek V4 Flash、Gemini 3.x Flash 的公开资料来看,越来越多模型厂商在小版本更新中重度依赖后训练,就能显著提升特定任务表现。
闫俊杰在业绩会上表示,当前大模型的 Scaling 正从单一预训练,快速拓展至中训练、后训练以及强化学习。在后训练阶段,海量合成数据生成、强化学习环境 rollout、任务试错验证,本质都是推理计算。单位算力下推理成本越低、吞吐越大,模型能吞吐的轨迹与实验规模就越大。
他进一步指出,在相同算力规模下,推理计算效率的提升倍数,与后训练规模变大倍数呈现基本线性相关。换言之,即使预训练 Scaling 被认为撞墙,后训练的效率提升仍然可以提高整体 Scaling 的上限。
新模型矩阵:M3.1、M3 Pro 与 H3.1
MiniMax 透露正在稳步推进三个新模型:M3 Pro、M3.1 和 H3.1。
- M3.1 定位面向主流用户的「标准版」模型,在 M3 基础上充分预训练并持续 Scaling 后训练规模,重点提升任务完成质量、推理效率、稳定性以及作为 Agent 基模的适配性。
- M3 Pro 参数规模约 3 万亿,基座更大,目标是更强泛化能力和更高智能上限,将采用第二代自研注意力架构 MSA 2.0,显著提高推理阶段缓存命中率。
- MiniMax 的目标是在 M3.1 推出时,将其推理成本降至 M3 初期上线时的 三分之一左右。闫俊杰认为,降价既能降低使用门槛、扩大用户基数与 Token 用量,也能改善毛利率,两者并非不可兼得。
多模态方面,MiniMax 前不久发布的 H3 继续采取开源策略。仅三周后,H3 全球下载量突破 2400 万次,衍生出超过 300 个公开模型。H3 的核心并非单纯扩散生成,而是将语言模型深度嵌入视觉生成流,实现全局上下文感知、多主体一致性控制和镜头精细化调度。闫俊杰认为,H3 证明了语言模型能力可以进一步提高视觉生成模型的上限,开放权重、产品和 API 可以形成相互促进的生态。
横向对比与「Min-Max」哲学
作为参照,The Information 报道称 DeepSeek 今年前七个月实现 7070 万美元收入,毛估 MiniMax 上半年营收约为 DeepSeek 的两倍上下;但 DeepSeek 前七个月净亏损为 1.06 亿美元,MiniMax 本期净亏损约为其 3.4 倍。两者路径不同,MiniMax 更偏向企业级与全球化。
MiniMax 的公司名称让人想起 Min-Max 这一术语,套用在模型实验室身上,则体现其「最小化单位智能成本,才能最大化智能水平」的认知。上半年在后训练阶段持续发力、以更低成本实现模型能力提升,正是这一认知的直接体现,也带来了企业端市场的重视与营收的显著增长。
从行业视角看,大模型竞争不可避免进入价格战阶段,而那些率先押注单位成本的厂商,或许将比盲目追求大参数、大智能的对手们领先一筹。