自变量发布WALL-SS世界模型
自变量机器人推出自回归世界模型WALL-SS,通过逐尺度预测与压缩记忆,让机器人在虚拟训练场中预演长任务并筛选可靠策略。
机器人从赛场走向家庭,试错成本陡然上升
过去一周,人形机器人几乎刷屏:刷新百米纪录、原地起飞近三米、腾空外摆 540°……今年在北京举办的世界人形机器人运动会更是热闹,来自六大洲 16 个国家的 666 支队伍、2056 台机器人参赛,项目从田径武术延伸到家庭、酒店、工业和应急救援等真实场景。
赛场上翻车,大家笑笑就过去了。可一旦进入家庭,打翻水杯、撞倒家具、把刚收好的衣服重新扯到地上,就笑不出来了。真实世界里没有固定跑道和统一摆放的道具,杯子被挪动一点、桌面多出一块抹布,原本训练好的动作就可能失效。
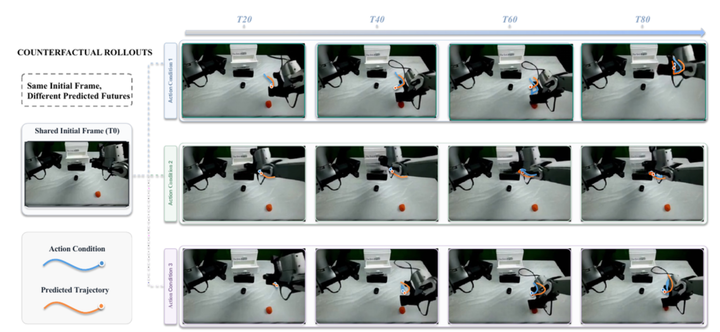
把试错搬进虚拟世界,正是当下世界模型想做的事:让机器人在动手前先预演——手往左偏一点会不会抓空,夹爪提前闭合会不会碰倒杯子。
世界模型的瓶颈:画面逼真,不等于策略可靠
不少世界模型无法实现可靠的虚拟测试。它们可能看懂了画面,却没有真正听从动作;推演时间一长,物体和位置开始漂移;虚拟世界里表现更好的策略,到了真机上未必奏效。
问题出在几个层面:
- 磁铁式抓取:训练数据以成功示范为主,模型容易走捷径——只要夹爪闭合,物体就应该被抓起来,即使画面里夹爪与物体之间还有明显空隙。
- 误差累积:生成完一段画面后,还要把它作为下一段预测的依据,前面一点小误差会在后续不断放大。
- 记忆两难:只保留最近几帧会忘记做过什么,保留全部历史则计算量和显存持续增长。
机器人从「会做」走到「做成」,往往就卡在最后几毫米。世界模型如果直接把这几毫米抹平,给出的未来越流畅,机器人越容易高估一套动作的可靠性。
WALL-SS 的解法:让动作和画面走在同一条时间线上
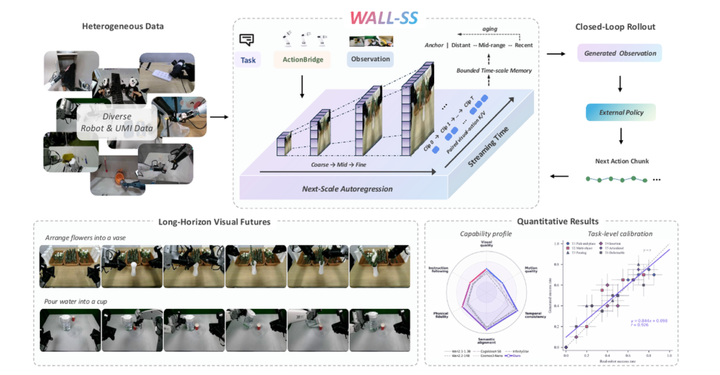
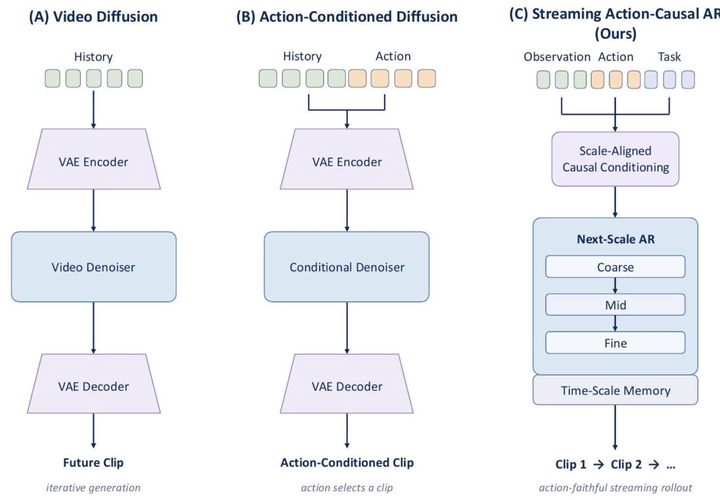
自变量机器人发布的自回归世界模型 WALL-SS,试图突破这些瓶颈。它的核心思路是:预测接下来几秒画面时,先搭出一版「低清预览」,确定机械臂往哪走、物体大概怎么移动;随后把同一段画面一层层调清,补上物体轮廓、夹爪开合和接触位置。论文把这种从大轮廓到小细节的层级称为「尺度」,已生成画面和发生过的动作会成为下一段预测的历史,即「下一尺度自回归」。
画面每清晰一些,动作也会再影响一次未来。手臂往左还是往右,先改变低清画面里的运动方向;夹爪何时闭合,继续影响清晰画面里有没有碰到杯子。
研究团队还保留了抓空、滑落、碰撞、重新抓取、人工接管和失败恢复等过程。如果训练数据里没有失败,世界模型很容易把「任务目标」误当成「必然结局」。
长任务不「断片」:压缩记忆与梦境强迫
家庭任务往往包含多个连续步骤,打开抽屉、拿起物品、放进抽屉、再关上,可能持续几十秒。机器人还要记住抽屉是否已经打开、物品目前在桌面还是手里。
WALL-SS 没有让模型把每一帧永远背下来,而是让记忆随时间自动变得「模糊」:刚刚发生的动作保留更多细节,更早的历史被压缩,最初的观察画面则作为场景和物体身份的锚点。这就是「尺度压缩的长时间跨度记忆」。
即便如此,预测过程中仍会积累小误差。为此 WALL-SS 采用「逐尺度梦境强迫」:训练时给历史信息加入扰动,要求基于有误差的信息预测正确的未来,相当于让机器人平时就在「有小错误的梦」里继续往下走,学会别把一个小错滚成整段任务崩溃。
在长时测试中,WALL-SS 连续推演 60 秒,轨迹误差、片段衔接、物体状态和视觉质量都比对照模型更稳定。倒水任务包含接近水瓶、抓握、抬起、倾倒和放回等阶段,60 秒推演中机械臂逐帧轨迹误差保持在画面对角线的 0.5% 以下。只保留最近片段的版本在 20 至 30 秒后开始明显恶化;去掉梦境强迫后,长期状态一致性也会持续下降。
虚拟成绩能否替真机筛策略
就算动作对了、记忆没断片,虚拟世界仍可能与现实存在偏差。WALL-SS 给自己的预测安排两位长期在线的「裁判」:一个检查动作,比如画面里的机械臂是否按给定方向移动、物体是否产生对应变化;另一个审核长期一致性,看机器人和物体的状态有没有漂移、前后片段能否接上、多个摄像头看到的世界是否一致。最后根据评分调整下一次生成不同未来的概率,这套过程叫「视觉动力学的在线策略对齐」。
对齐之后,动作跟随从 0.264 提升至 0.290,轨迹精度从 0.512 提升至 0.539,跨片段边界误差从 0.118 降至 0.104,画面质量基本没有变化。
研究团队还把多套机器人策略分别放进 WALL-SS 和真实世界测试,在虚拟世界里执行效果很好的动作策略,搬到物理世界往往也有好的结果。机器人做的「梦」,开始能够用来练习和筛选真实动作。