Hugging Face政策主管:AI评测体系远未成熟
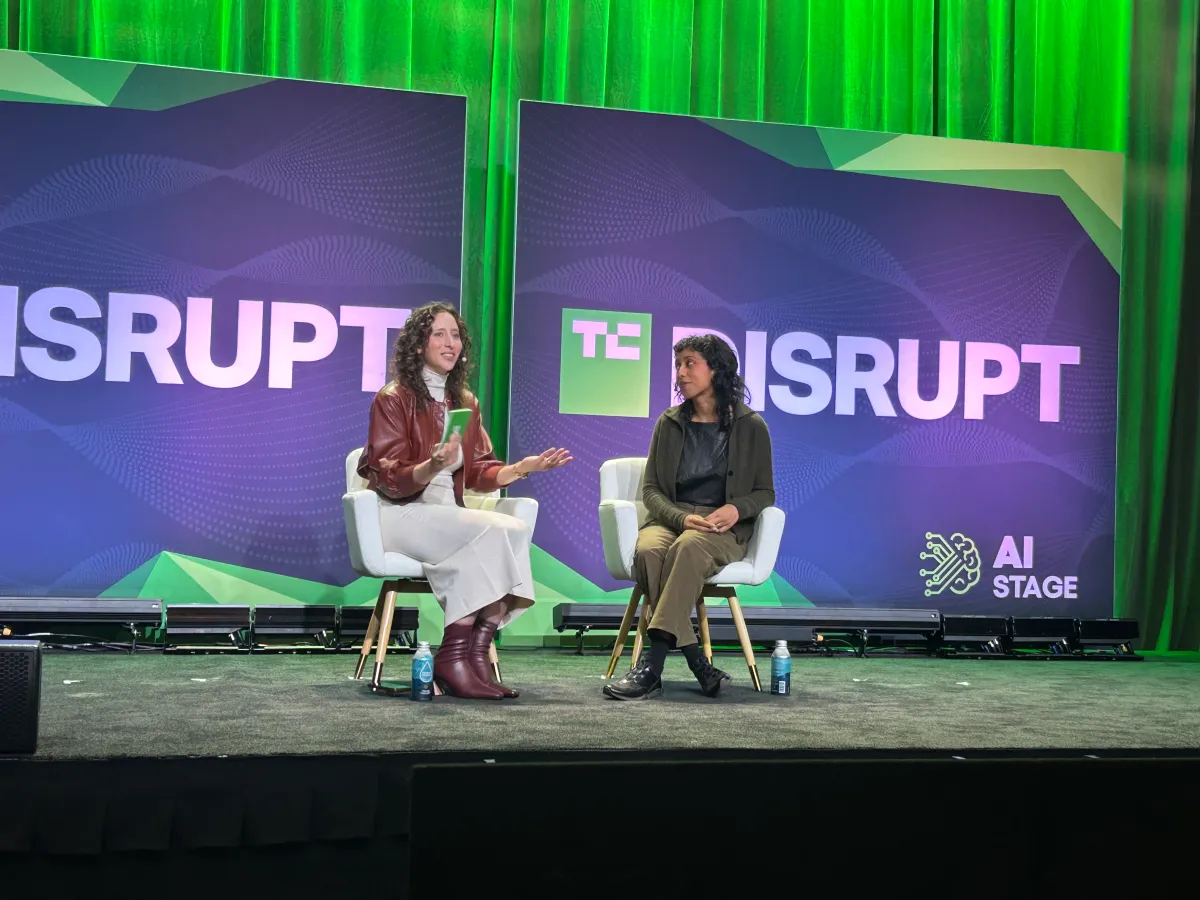
Hugging Face首席政策官Irene Solaiman在TechCrunch Disrupt上指出,当前AI模型评测方法复杂且尚未成熟,可复现性不足,嵌入式评估员方案存在中立性质疑,行业亟需建立统一标准。
AI评测的"信任危机"
在上周的TechCrunch Disrupt大会上,Hugging Face首席政策官Irene Solaiman发表了一番引发行业深思的言论。她坦言,当前各AI实验室赖以建立声誉的模型评测体系——那套号称中立、客观的评估机制——其背后的方法论依然复杂且远未成熟。
"信任是一个分量很重的词,"Solaiman说,"要判断评测结果是否可信,一个关键问题是:你能否复现这些结果?你是否拥有访问模型本身所需的权限——这正是开放权重(open weights)能发挥巨大作用的地方。"
可复现性:评测体系的阿喀琉斯之踵
模型评测的可复现性长期以来一直是基准测试中最棘手的环节之一,也是行业内部争论的焦点。Solaiman指出,评测结果不仅难以复现,不同评测之间的横向比较也缺乏意义。
"它们是一门正在演化的科学——我们尚不知道如何有意义地相互比较,"她说道,"它们会相对迅速地失效,而且我们没有建立起足够繁荣的生态。"
这意味着,当前发布的各类评测报告,其可信度和参考价值都需要审慎对待。
"嵌入式评估员":好方案还是纸面方案?
近期,一种被称为**嵌入式评估员(embedded evaluators)**的方案在AI行业受到关注。其核心思路是:将所谓的"中立"第三方观察者派驻到AI组织内部,以监督模型安全性。
这一方案的兴起与AI实验室接连遭遇的安全事件有关——Hugging Face本身就是其中之一。面对安全危机,各实验室倾向于推动第三方评估方案,而非接受主动的政府监管。
然而,这一方案的中立性和有效性受到广泛质疑。Anthropic选择安永(Accenture)作为其首位评估员,引发了大量批评,有人认为这家咨询公司并不具备从事此类工作的资质。
Solaiman对此表达了明确的保留态度:"现在行业对嵌入式评估员生态有迫切需求,但界定谁是有资格的评估员、在哪些任务上有效,这些标准需要大量规范化工作。"
评测对象正在从"模型"扩展到"系统"
Solaiman还揭示了一个重要的趋势转变:评测正在从单纯测试模型本身,转向测试围绕模型的整个系统——包括harness(用户访问模型的工具层)和agent(智能体)。
"harness对模型表现影响很大,一个较弱的模型配上更好的harness,完全可以跑赢前沿模型,"她解释道。
她还指出,当前行业面临评测资源分配失衡的问题:
- 针对模型本身的评测相对丰富
- 针对harness的评测严重不足
- 针对整体agent的评测正在发展中
"智能体评测非常困难且成本高昂,"Solaiman直言。
行业需要统一标准
综合来看,Solaiman的核心观点可以概括为:当前的评测领域处于一种"自由竞争"的混乱状态。如果基准测试要继续保持作为行业决策工具的价值,就需要建立更统一、全行业共识的方法论。
这一呼吁对以下群体尤为相关:
- AI实验室:需要更可靠的第三方评估来建立公信力
- 监管者:需要可验证的评测标准来制定有效政策
- 开发者与研究者:需要可复现的评测结果来指导模型选择与优化
AI评测体系的成熟,或许是行业从"野蛮生长"走向"规范发展"的关键一步。
本文目录(5 节)
本文基于 TechCrunch AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:Embedded AI evaluators won’t be an easy solution, Hugging Face’s policy chief says
阅读原文