OpenAI自研推理芯片九个月流片
OpenAI与博通联合研发的推理芯片Jalapeño公开测试,能效比英伟达GB200高1.5至1.9倍,从设计到流片仅用九个月,AI自身深度参与了芯片开发。
OpenAI 造芯:一颗为推理而生的小辣椒
「我们制造了一款芯片,它很快。」Sam Altman 对 Jalapeño 的总结只有这一句。
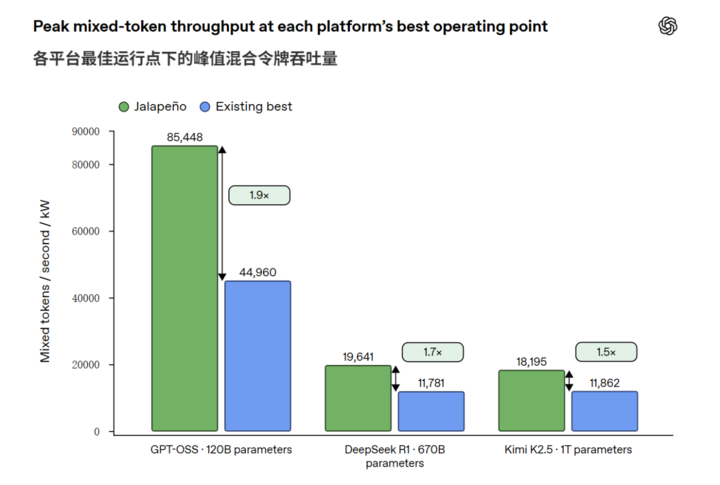
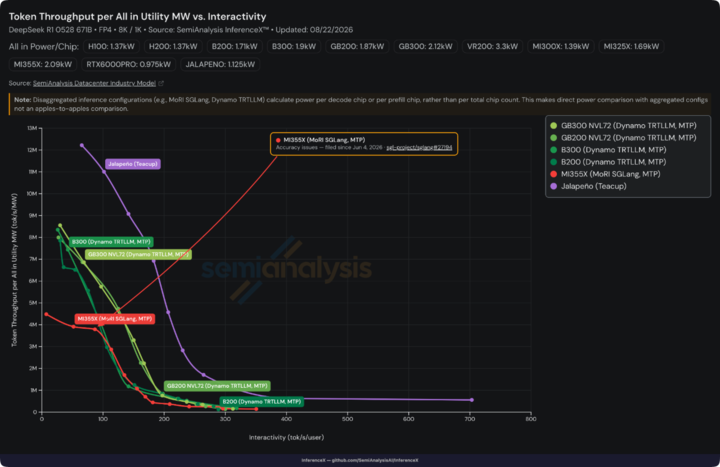
OpenAI 与博通联合自研的首款 AI 推理芯片 Jalapeño(墨西哥辣椒)近日公布了首轮公开测试成绩。在 SemiAnalysis 发布的 InferenceX 基准测试中,它运行了 GPT-OSS 120B、DeepSeek R1 670B 和 Kimi K2.5 1T 三款模型,每瓦完成的 AI 工作比英伟达 GB200、GB300 多出 1.5 至 1.9 倍,端到端延迟缩短到对照系统的约 30% 至 60%。
以 DeepSeek R1 为例,一次 8K 输入、1K 输出的推理从 5.99 秒降到 1.65 秒,最低 token 间隔由 5.90ms 压到 1.43ms。这意味着未来 ChatGPT 上出现的不只是 1.5 倍速的「快速」模式,3 倍速在成本允许时也有实现空间。
为什么需要一颗专用推理芯片
普通聊天一问一答,只需调用几轮模型,延迟尚可忍受。但 Agent 干活时往往要连续调用模型几十次:读文件、搜资料、操作软件、检查结果,再据此推进下一步。每一步的推理延迟累积起来,哪怕处理日常事务也会消耗大量时间。
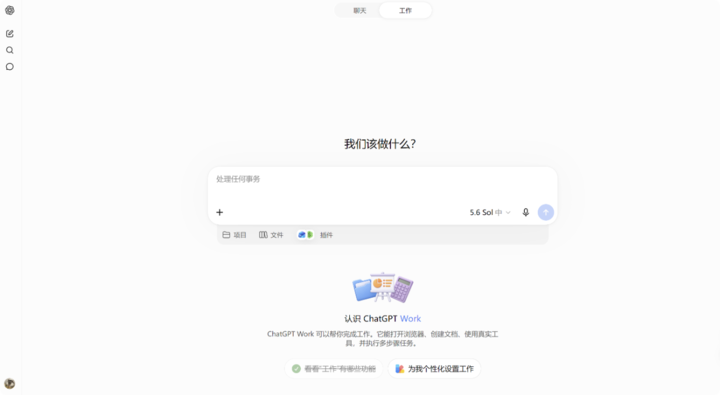
这正是 ChatGPT 首页被分为「聊天」和「工作」的原因——复杂任务必须单独区分,以免「想得太多」的 Agent 拖慢日常体验。如果推理足够快,Agent 的响应就能接近普通聊天,首页或许可以回归到最初的单一对话框形态。
内存墙与协同设计
大模型推理分两个阶段:Prefill 阶段一次性读懂整段提示词,考验计算能力;Decode 阶段逐个生成 token,需要反复从内存读取权重和 KV Cache,几乎必然撞上「内存墙」。
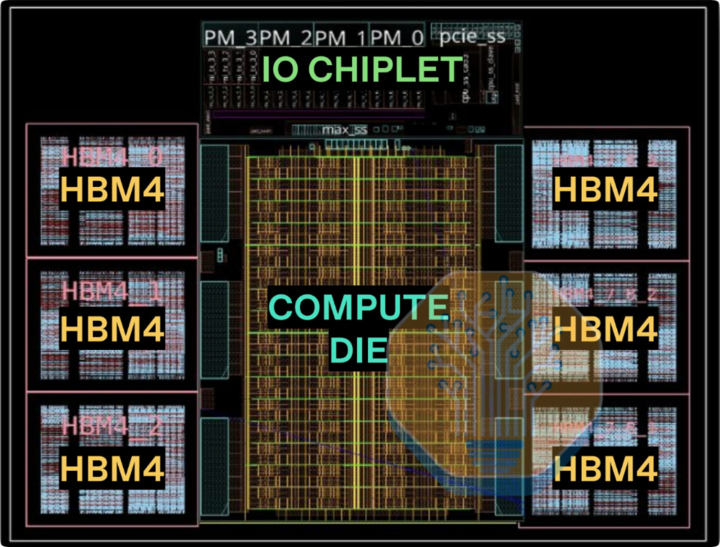
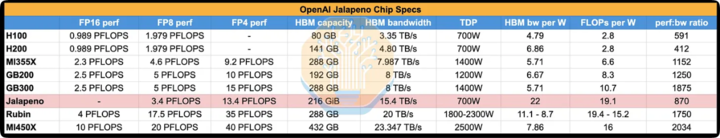
Jalapeño 的应对思路是把计算核心、HBM 内存和网络通盘考虑。据 SemiAnalysis 披露,它配有 216GiB HBM4,内存带宽达 15.4TB/s,接近微软 Maia 200 和 Google Ironwood 的两倍。芯片还将计算核心与 HBM 划分为多个对应区域,让模型权重和 KV Cache 尽量留在本地内存,跨区域同步时才走高速通信网络,减少数据来回搬运。
效果体现在能效上:Jalapeño 标称功耗 700W,实测持续功耗低于 550W;对照之下,英伟达 GB200 和 GB300 标称功耗分别为 1200W 和 1400W。用约一半的能耗,实现更高的推理性能,对数据中心意味着实打实的成本削减。OpenAI 计划年底前将其部署到计算基础设施中,第二代产品已在开发中段,第三代也初具雏形。
九个月流片:AI 参与造芯
Jalapeño 的速度不只体现在性能上。据路透社报道,项目正式起步约在 2024 年底至 2025 年初,初始成员很多来自 Google TPU 项目;更早一年,OpenAI 已邀请前 Google TPU 负责人 Richard Ho 组建硬件团队。
综合各方信息可以整理出一条时间线:2025 年 2 月进入正式设计周期,11 月完成流片,今年 5 月拿到第一块成品芯片,8 月完成调试并开启公开测试。而据 Semiconductor Engineering 估算,同类高复杂度 AI 加速芯片从正式设计到流片通常需要 18 至 24 个月,OpenAI 把周期压缩了接近一半。
关键因素正是 AI 本身。OpenAI 表示,其模型在设计期间用于探索实现方案、参与验证和修改、优化芯片算术电路;成品进入实验室后,又用 Codex 和未发布的 Astra 模型,在两个月内完成了 GPT-OSS、DeepSeek R1、Kimi K2.5 等原本不在适配计划中的模型适配。
头部厂商的共同选择
OpenAI 并非这条路上最早的玩家。Google TPU 已迭代到第八代,第七代 Ironwood 就是首款专为推理设计的 TPU,第八代进一步细分为训练用 TPU 8t 和推理用 TPU 8i。据 The Information 报道,Google 还在研究代号 Frozen v2 的服务器芯片,尝试把 Gemini 部分架构直接固化进硬件。亚马逊 AWS 则先后推出 Inferentia 和 Trainium,Anthropic 已通过 Project Rainier 获取接近 100 万颗 Trainium 芯片的算力,同时也在组建内部专用芯片团队。
直接动因是经济账。2024 年 GPT-4o 发布时,每百万输入、输出 token 分别收费 5 美元和 15 美元;如今 GPT-5.6 Luna 已降到 0.2 美元和 1.2 美元。把计算效率的主导权握在手中,结合 ChatGPT 的巨大调用量,收回自研芯片投入并不困难。 成本之外,算力供给的稳定性同样是模型公司必须考虑的问题。