AI能读懂猫咪的面部疼痛吗?
研究测试了专用AI模型和通用聊天机器人对猫咪面部疼痛的识别能力:专用模型准确率95.5%,但聊天机器人普遍低估疼痛,主人仍应使用专业量表自行初步筛查。
猫咪会"笑"也会"痛",但大多数猫不会告诉主人
猫咪天生善于隐藏不适,主人往往是最后一个发现异常的人。但猫在疼痛时,面部确实会发生可测量的变化。加拿大蒙特利尔大学的研究团队将这种变化转化为了一套评分工具,随后训练AI从照片中读取它。2025年,一组研究者进一步测试了日常聊天机器人能否胜任同样的工作——结果对养猫人很有启发。
猫脸疼痛的五个信号
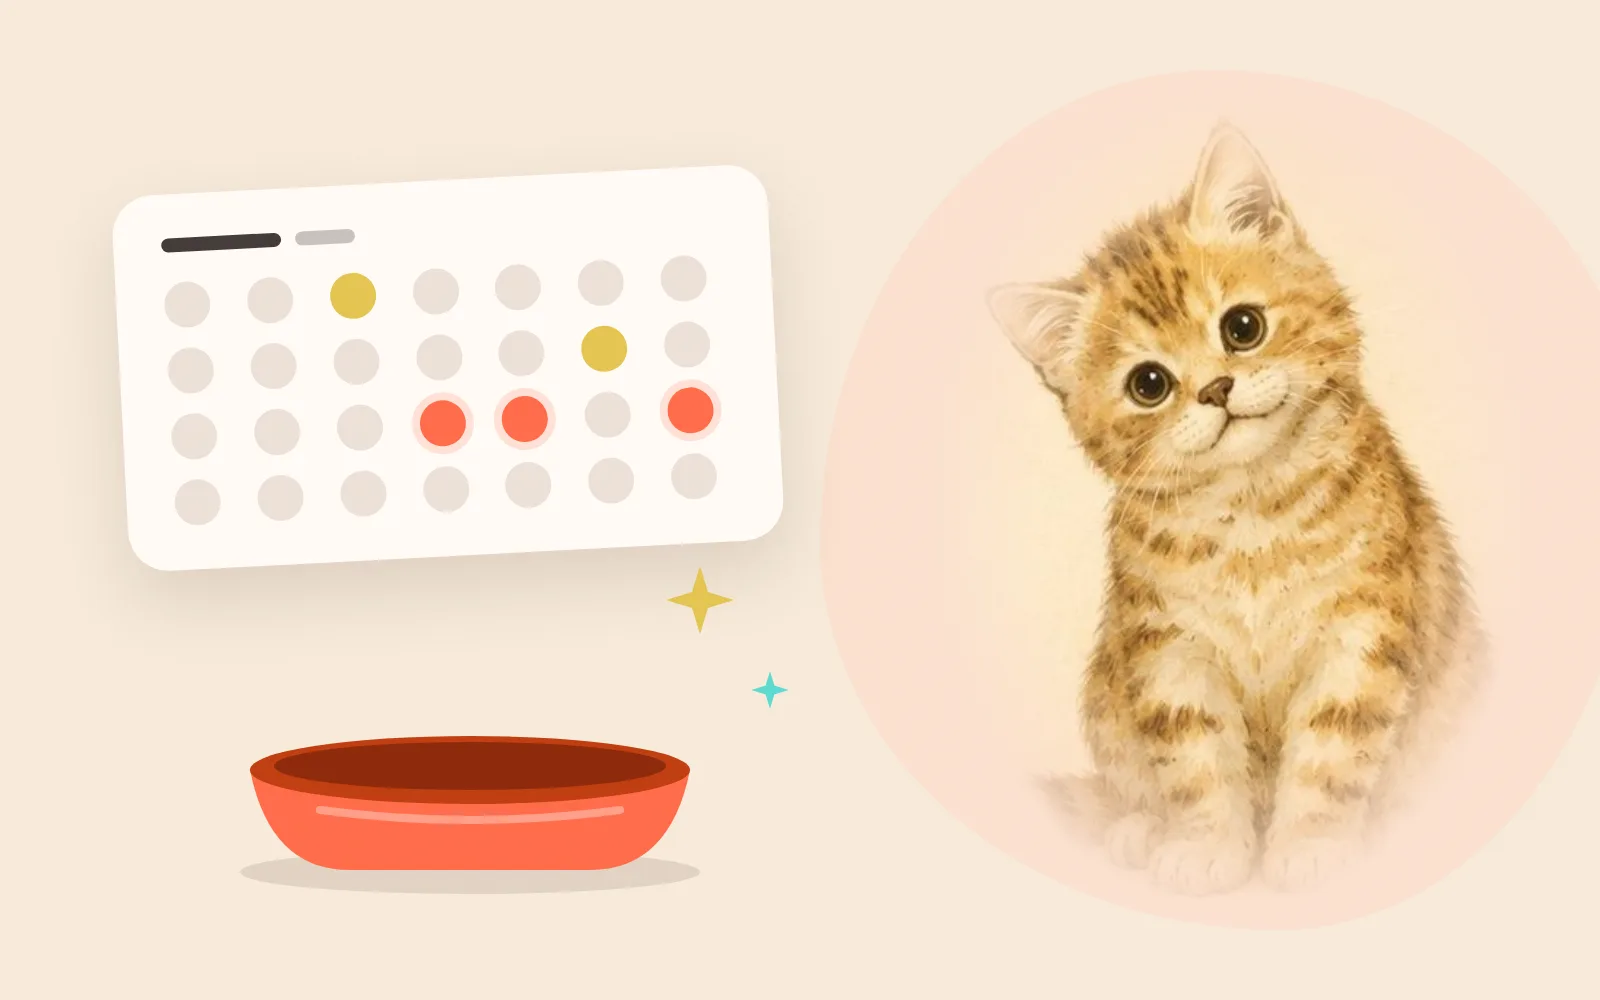
猫科面部 grimace 量表(Feline Grimace Scale)于2019年发表,评估五个"动作单元",每项0-2分:
| 部位 | 放松(0分) | 明显疼痛(2分) |
|---|---|---|
| 耳朵 | 朝前 | 向外拉开并旋转 |
| 眼睛 | 睁开 | 眯到不足一半或紧闭 |
| 口鼻 | 圆润放松 | 扁平拉伸成椭圆 |
| 胡须 | 松散弯曲 | 笔直前推 |
| 头部 | 高于肩部线 | 低于肩部或低头 |
总分4分及以上意味着猫咪可能需要止痛治疗。原始研究中,该量表区分需要止痛和不需要止痛的猫,敏感性90.7%,特异性86.6%。
专用AI模型能做到吗?——95.5%准确率
2023年,同一研究团队用3,447张猫脸照片训练神经网络,每张照片标注了37个面部关键点(眼角、耳基、口鼻边缘等)。一个模型定位关键点,另一个将位置转化为 grimace 评分。最佳组合区分疼痛与无痛猫的准确率达95.5%,且模型足够小,可在手机上运行。
这是一个窄而精的工具:为单一任务构建,训练数据由专家手工评分,不是泛用模型。
通用聊天机器人:系统性低估疼痛
2025年发表在《Scientific Reports》上的研究提出了另一个问题:如果主人只是把照片上传给通用聊天机器人呢?研究者将50张猫脸照片分别交给ChatGPT、Gemini、Claude和Perplexity,要求它们按猫科面部 grimace 量表评分,并与兽医麻醉师的结果对比。测试进行了两轮,间隔两个月。
结果令人担忧:
- ChatGPT (GPT-4o):两轮分别低估2.2分和2.1分,表现稳定但持续低估疼痛
- Claude (3.5 Sonnet):平均偏差最小(1.1分和0.5分),但单次评分在疼痛阈值附近波动大
- Gemini (1.5 Pro):低估2.2分和2.5分,且分散
- Perplexity:低估2.1分和1.8分,重测时同样分散
所有聊天机器人都把猫评为比专家判断更不痛。 研究者认为,这种系统性低估可能导致真正疼痛的猫得不到止痛治疗,或无痛猫被过度治疗。当然,聊天机器人每次更新都会变化,这只是快照而非最终定论。但核心观点不变:一个听起来很有把握的通用模型,并不等同于经过验证的专用工具。
在家自己给猫评分:不需要AI
2023年的一项调查覆盖了66个国家的1,262名猫主人和护理者,他们使用猫科面部 grimace 量表给猫照片打分,结果显示评分可靠且不受评分者身份影响。胡须和头部位置最难判断,不确定时优先关注耳朵、眼睛和口鼻。
实操步骤
- 选择安静时刻——猫在睡觉、进食、梳理毛发或叫唤时不要评分
- 观察30秒——不要触摸或呼唤猫
- 逐项打分——按上表对五个部位分别打0、1或2分,不确定给1分
- 加总判断——总分4分及以上提示需要看兽医
- 拍照存档——正面、与猫眼平齐的角度拍摄
关键提醒:这套量表是筛查工具,不是诊断工具。如果总分≥4,请及时联系兽医。AI专用模型在特定任务上表现优异,但通用聊天机器人目前还不适合承担疼痛评估这类需要精确判断的任务。