20ms转PDF为Markdown,开源OCR提速近300倍
Firecrawl团队开源浏览器插件OCR It,20ms内将不可复制PDF转为Markdown,速度比Docling快近300倍,支持离线运行,但处理复杂版式仍不稳定。
从PDF到Markdown,只要20毫秒
手动摘取PDF文字、结果满屏乱码、大模型读不懂——这些困扰许多人的问题,可能很快成为过去式。
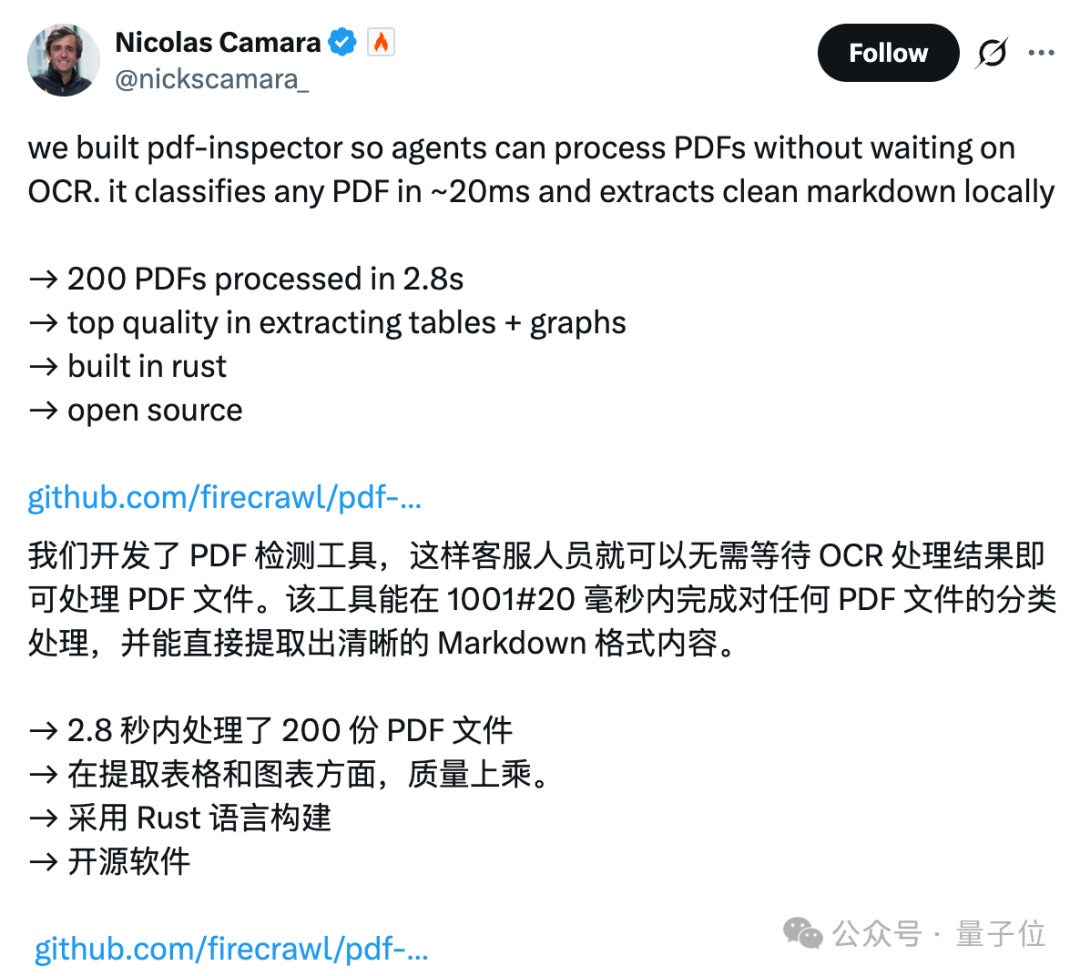
Y Combinator孵化的Firecrawl团队最近开源了一款名为OCR It的工具。其联合创始人兼CTO Nicolas Camara表示,它能在20ms内将一份不可复制的PDF中的全部文字内容提取出来,并转换成结构清晰的Markdown格式,方便直接喂给AI阅读。
20ms是什么概念?基本是你刚点完确认、眼睛还没来得及眨完,一份处理好的Markdown文件就已经交到手上。更关键的是,它不需要联网,可以通过内置的Tesseract实现100%离线运行。
速度与定位:对标Docling
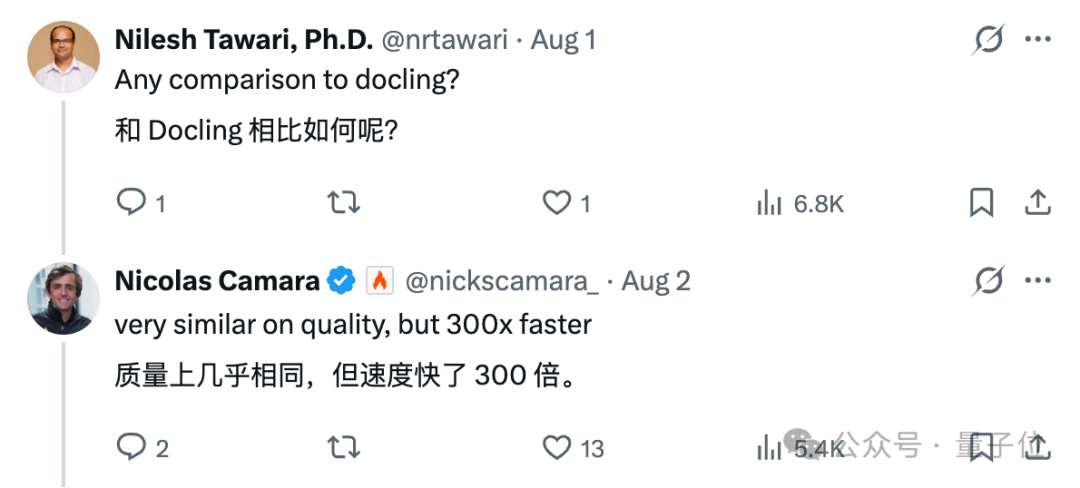
据Nicolas Camara介绍,在处理质量与Docling旗鼓相当的前提下,OCR It的处理速度比Docling快了近300倍。这个刚开源的项目发布不久,就在GitHub上获得了不少关注,有网友在X上实测后留言称“快,确实快得很”。
怎么用:浏览器插件,手动自动两档
OCR It是一款适用于Chrome和Firefox的免费浏览器插件。核心逻辑是:框选一次区域后,之后每按一次快捷键(或开启自动模式),就能把整本书或整个文档变成完整可编辑的纯文本,便于交给AI总结或提问。
为了避免在末页无限重复抓取,OCR It会在连续识别到两张相同页面、无法继续翻页、OCR失败或达到300页上限时自动停止。
手动档
- 框选与识别:按
Option+Shift+R选定需要识别的文字区域,确认后按Enter保存;再按一次Option+Shift+S,工具开始识别当前页面,完成后自动翻到下一页。重复操作直到整份文档识别完毕。 - 批量排队:也可以一边翻页一边在每页按一次
Option+Shift+S,系统会立即截图并在后台自动排队执行识别任务。 - 检查与导出:全部识别完成后,可在插件面板中检查、修改文本,也可重新识别单独某一页,最后选择“Copy all”或“Download .txt”导出全文。
(注:Windows和Linux用户需将Option键替换为Alt键。)
自动档
按下 Option+Shift+A 或点击Start auto-run,OCR It会自动循环执行“截图—OCR—翻页”,直到文档结束。中途想停止按ESC即可,检查流程与手动档基本一致。
此外,据OCR It仓库界面显示,它不需要API Key、不需要联网,安装时也不索取任何网站权限,只在需要自动运行或操作跨域iframe时按需申请当前站点权限。需要注意的是,浏览器内置PDF阅读器目前暂不支持自动翻页,处理这类PDF时建议用手动档。
短板:复杂版式还不太稳定
OCR It虽然又快又方便,但还远没到“把所有PDF丢给它就能高枕无忧”的程度。网友实测后形成的共识是:它目前可以相当顺手地处理版式简单、文字清晰的PDF文档,但还不太能处理标题、脚注、表格、数学公式和正文段落混排的复杂页面,仍有不小的提升空间。
对于日常简单的PDF转写需求,OCR It已经足够轻快;至于复杂排版场景,不妨期待团队后续的更新。