提升 MMM 准确性的三大关键:预算分阶段算法
市场组合模型(MMM)常因多重共线性、选择偏差和饱和效应失效。本文探讨如何通过预算分阶段算法构建模型所需的数据变化,从而提升预测准确性。
MMM 模型的准确性与挑战
在增长黑客和营销分析领域,衡量营销支出的回报率(ROAS)是极具挑战性的任务。近年来,随着开源模型的兴起,市场组合模型 重新成为了解决这一难题的热门方案。Meta 的 Robyn、Google 的 Meridian 以及 PyMC Labs 的 PyMC-Marketing 等开源工具,极大地降低了运行 MMM 的门槛。
然而,“运行容易,信任难”。Google 在 2017 年发布的《媒体组合建模的挑战与机遇》论文中,至今仍是最清晰地阐述了模型为何会失效的文献。该论文指出了三个核心问题,它们大多源于模型无法捕捉到支出数据中缺失的某种变异性。
MMM 的三大核心缺陷
1. 多重共线性
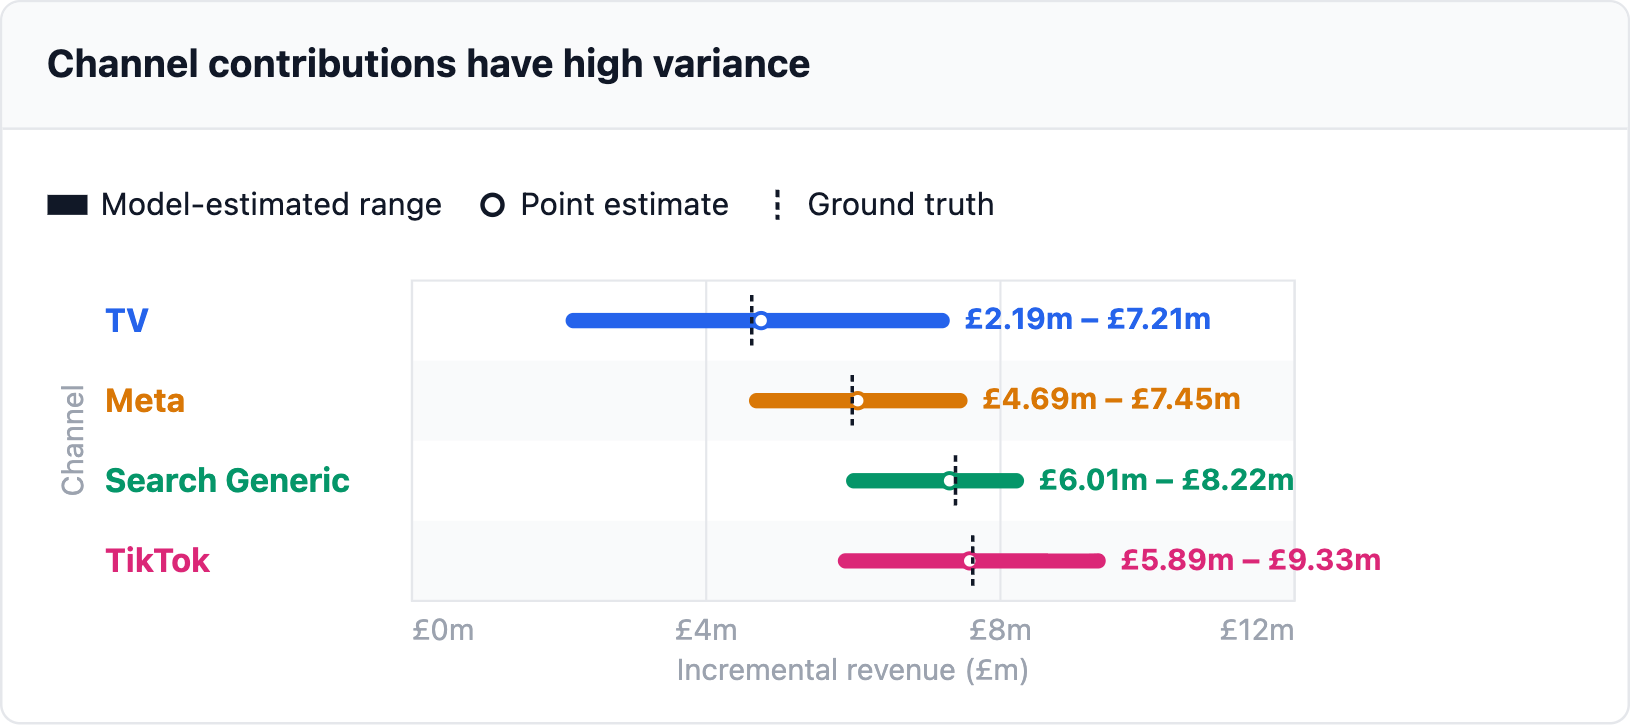
营销渠道通常遵循相同的预算规划周期,导致它们在同一时期内同涨同跌。对于模型而言,如果两个渠道从未分开移动,模型就无法将它们区分开来,导致估算结果具有极高的方差。
关键缺失: 每个渠道独立移动的能力。
2. 选择偏差
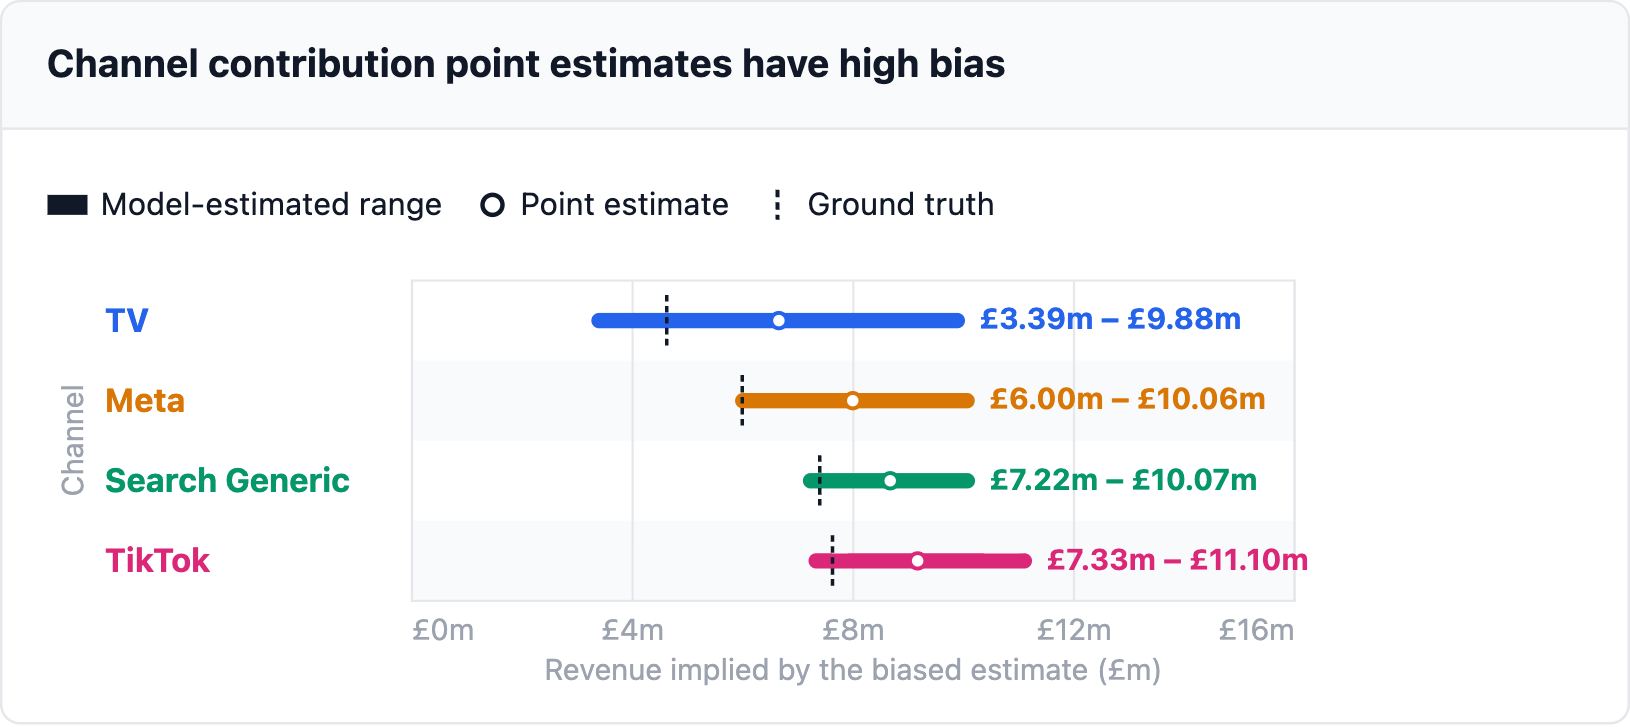
组织的营销支出往往跟随需求波动,例如在旺季增加投入。但由于需求本身往往是不可直接观测的,模型只能依赖代理变量。这会导致渠道系数吸收了代理变量遗漏的信息,从而产生教科书级别的遗漏变量偏差。
关键缺失: 支出因非需求原因(如策略调整)而移动的数据。
3. 不可识别的广告库存与饱和效应
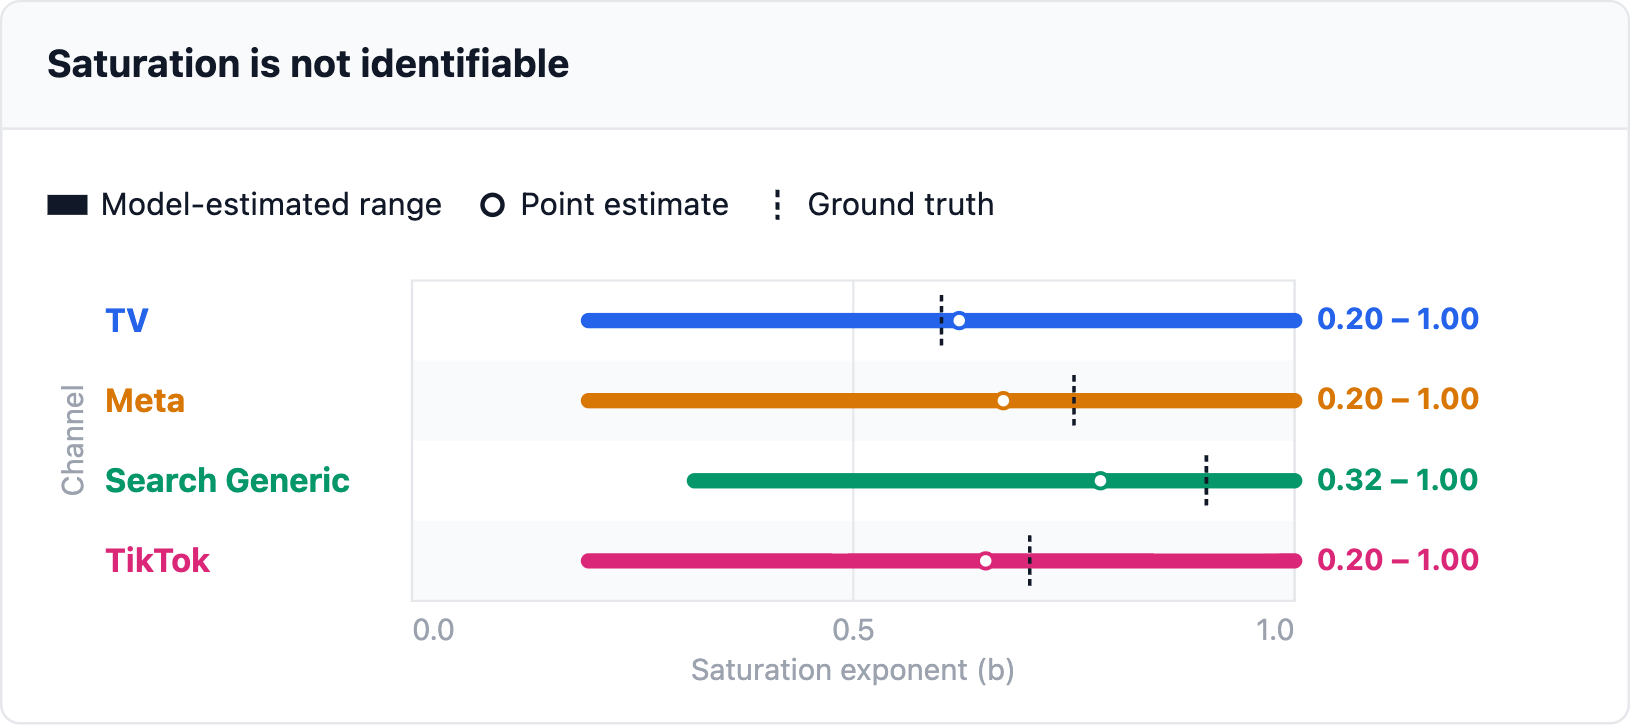
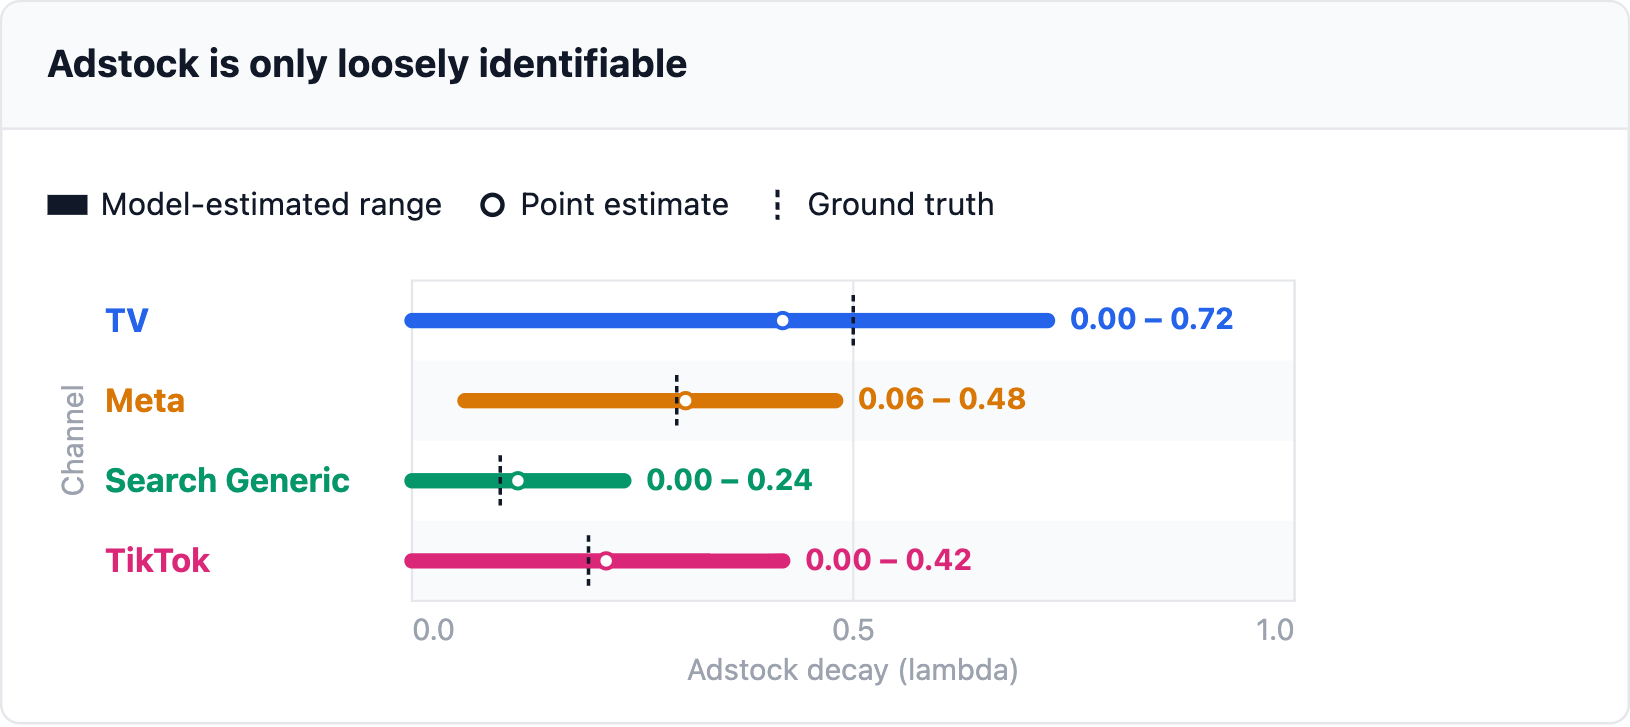
模型必须识别广告库存(Adstock)和饱和效应。2024 年的一项研究发现,这些形状参数往往无法从普通的支出数据中单独识别出来。
关键缺失: 在不同水平上保持足够长的时间,以超过库存效应的数据。
解决方案:预算分阶段算法
面对这些问题,Google 在 2017 年的论文中建议“获取更好的数据”。如今,行业的主要应对手段是增量测试,但这种方法每次只能测试一个渠道,耗时数月,且根据 2026 年 Recast 的研究,大多数开放地理测试工具的误报率高达 14-30%。
退一步看,这三个问题的共同解法在于:支出必须以模型所需的方式发生变化。这就引出了“预算分阶段算法”的概念——即通过算法在预算计划中人为构建上述三种变化。
如何通过模拟数据验证算法?
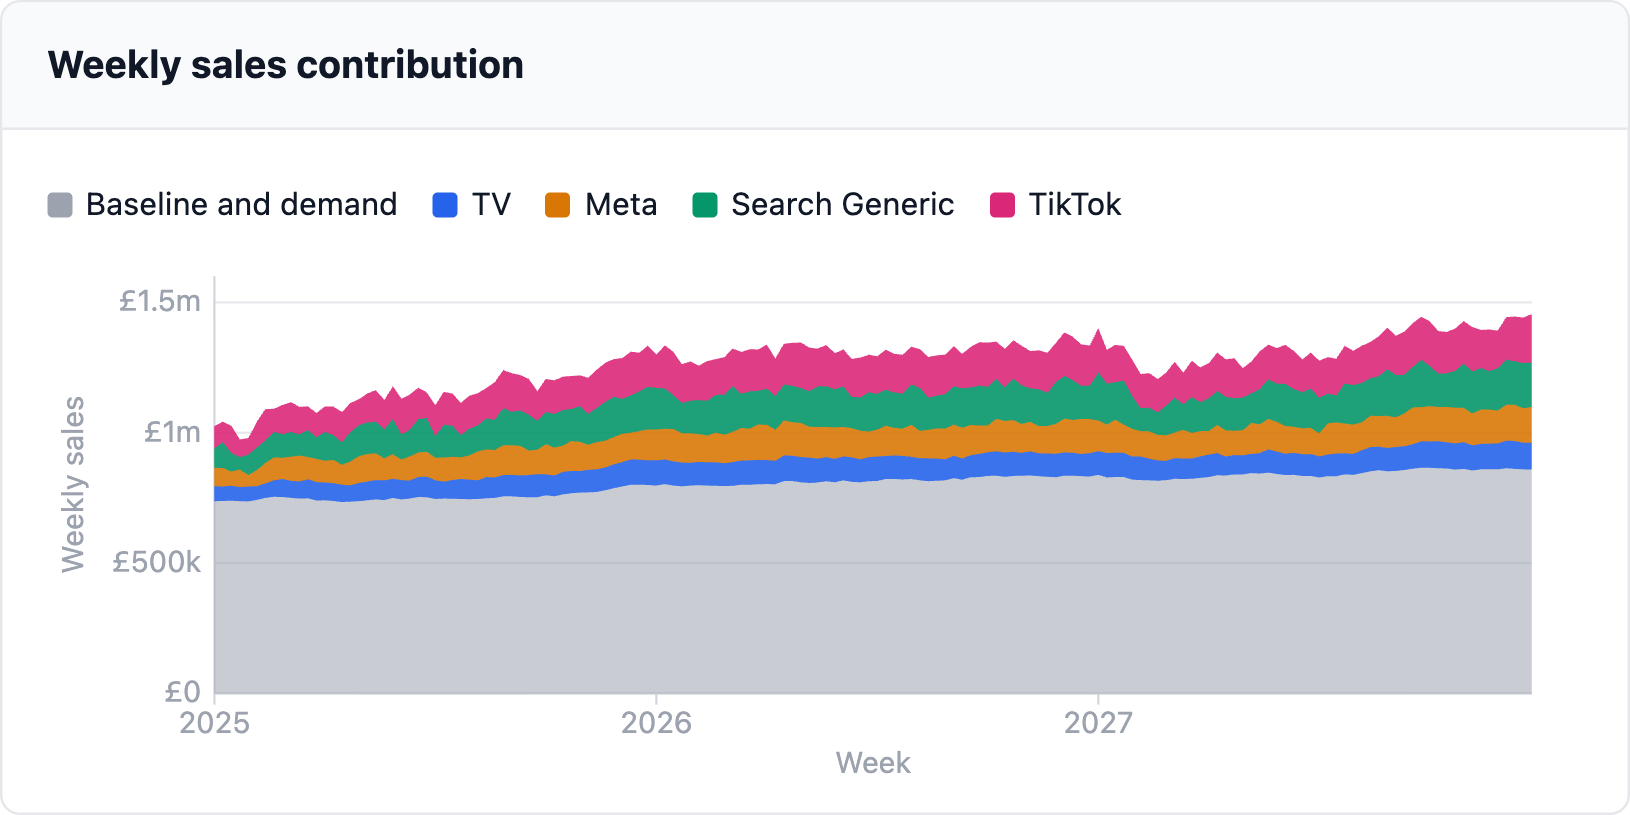
为了测试这种算法是否有效,我们需要构建一个数据生成过程(DGP)。由于我们不知道过去和未来的真实收入数据,必须通过模拟来验证。我们将模拟已知的营销响应,以此作为模型估算的基准。
模拟步骤详解
在构建测试环境时,开发者通常遵循以下步骤,这也是评估 MMM 健壮性的标准流程:
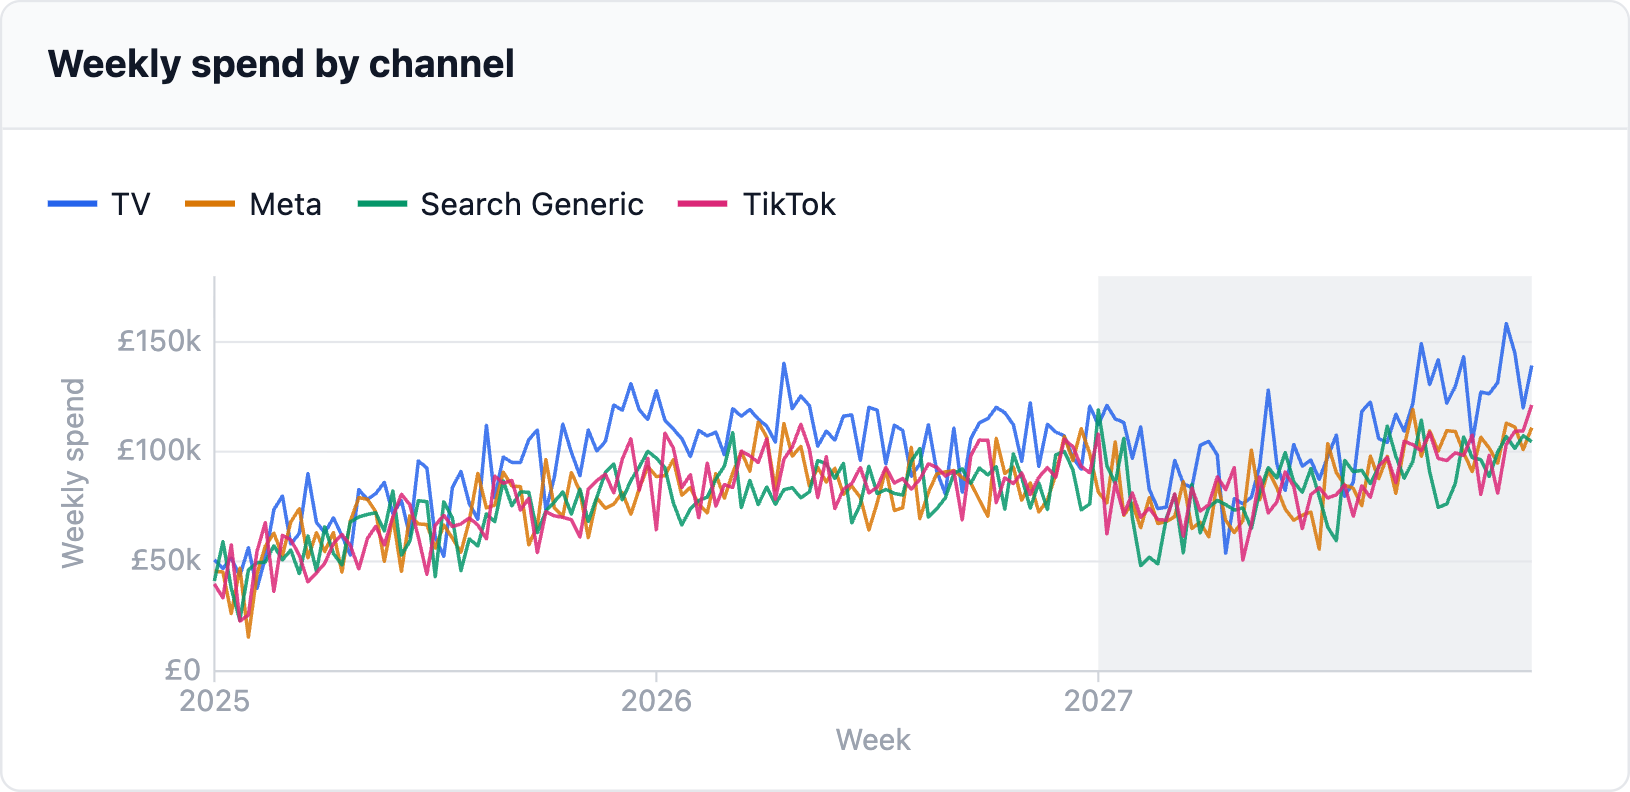
模拟营销支出与需求 我们将生成四个渠道(TV、Meta、通用搜索、TikTok)的三年周度支出数据。
- 渠道选择:虽然实际场景可能有更多渠道,但为了演示,我们选择 4 个渠道。这有助于在文章后续部分展示算法如何扩展到 10-15 个渠道。
- 数据周期:选择三年周度数据,因为它在数据量和时效性之间取得了最佳平衡。
- 相关性设定:设定各渠道遵循相同的底层信号,相关系数为 0.7。这是一个现实且合理的场景,源于预算规划紧随需求预测。此外,我们还设定了向上的趋势,模拟三年间的增长。
- 目的:在现实中,你提供过去两年的实际支出和明年的计划。而在模拟中,我们是为了测试预算分阶段算法是否能将模型所需的“独立性”和“变化性”融入计划中。
通过这种模拟,开发者可以验证模型是否能够从看似捆绑在一起的数据中,分离出各渠道的真实贡献,从而克服多重共线性、偏差和饱和效应带来的困扰。