Uber:如何将扩缩容意图与执行解耦,降低集群资源成本
Uber 通过引入 ServiceScale CRD 和服务扩缩容控制器(SSC),实现了扩缩容意图与执行的解耦。该方案解决了区域故障转移时的资源复用问题,通过引入“读己所写”机制和并发修复策略,成功将稳态配置降低至 1.3 倍,节省超百万核 CPU,为多编排器系统提供了宝贵实战经验。
Uber:如何将扩缩容意图与执行解耦,降低集群资源成本
在 Kubernetes 平台上管理大规模分布式系统,最大的挑战往往不在于架构本身,而在于意图与执行之间的复杂交互。Uber 作为拥有全球最大规模的 Kubernetes 容器平台之一,每天处理 150 万个 Pod 的启动和 300 万核 CPU 的调度,其最新的架构实践为我们提供了极具参考价值的样本。
背景:从“预留容量”到“弹性复用”
过去,为了应对区域级故障,Uber 在所有数据中心都预留了闲置容量。这种做法虽然安全,但极大地浪费了计算资源。随着业务规模扩大,工程师们意识到,通过复用低优先级工作负载的容量来应对高优先级故障转移,是更优的解法。
然而,引入这一机制后,系统面临一个核心难题:故障转移编排器需要动态调整扩缩容,但这不能增加原有部署控制器(UDC)的复杂度。 如果将故障转移逻辑硬编码进 UDC,一旦出现回归问题,可能会影响整个集群的稳定性。
核心方案:ServiceScale 与 SSC 控制器
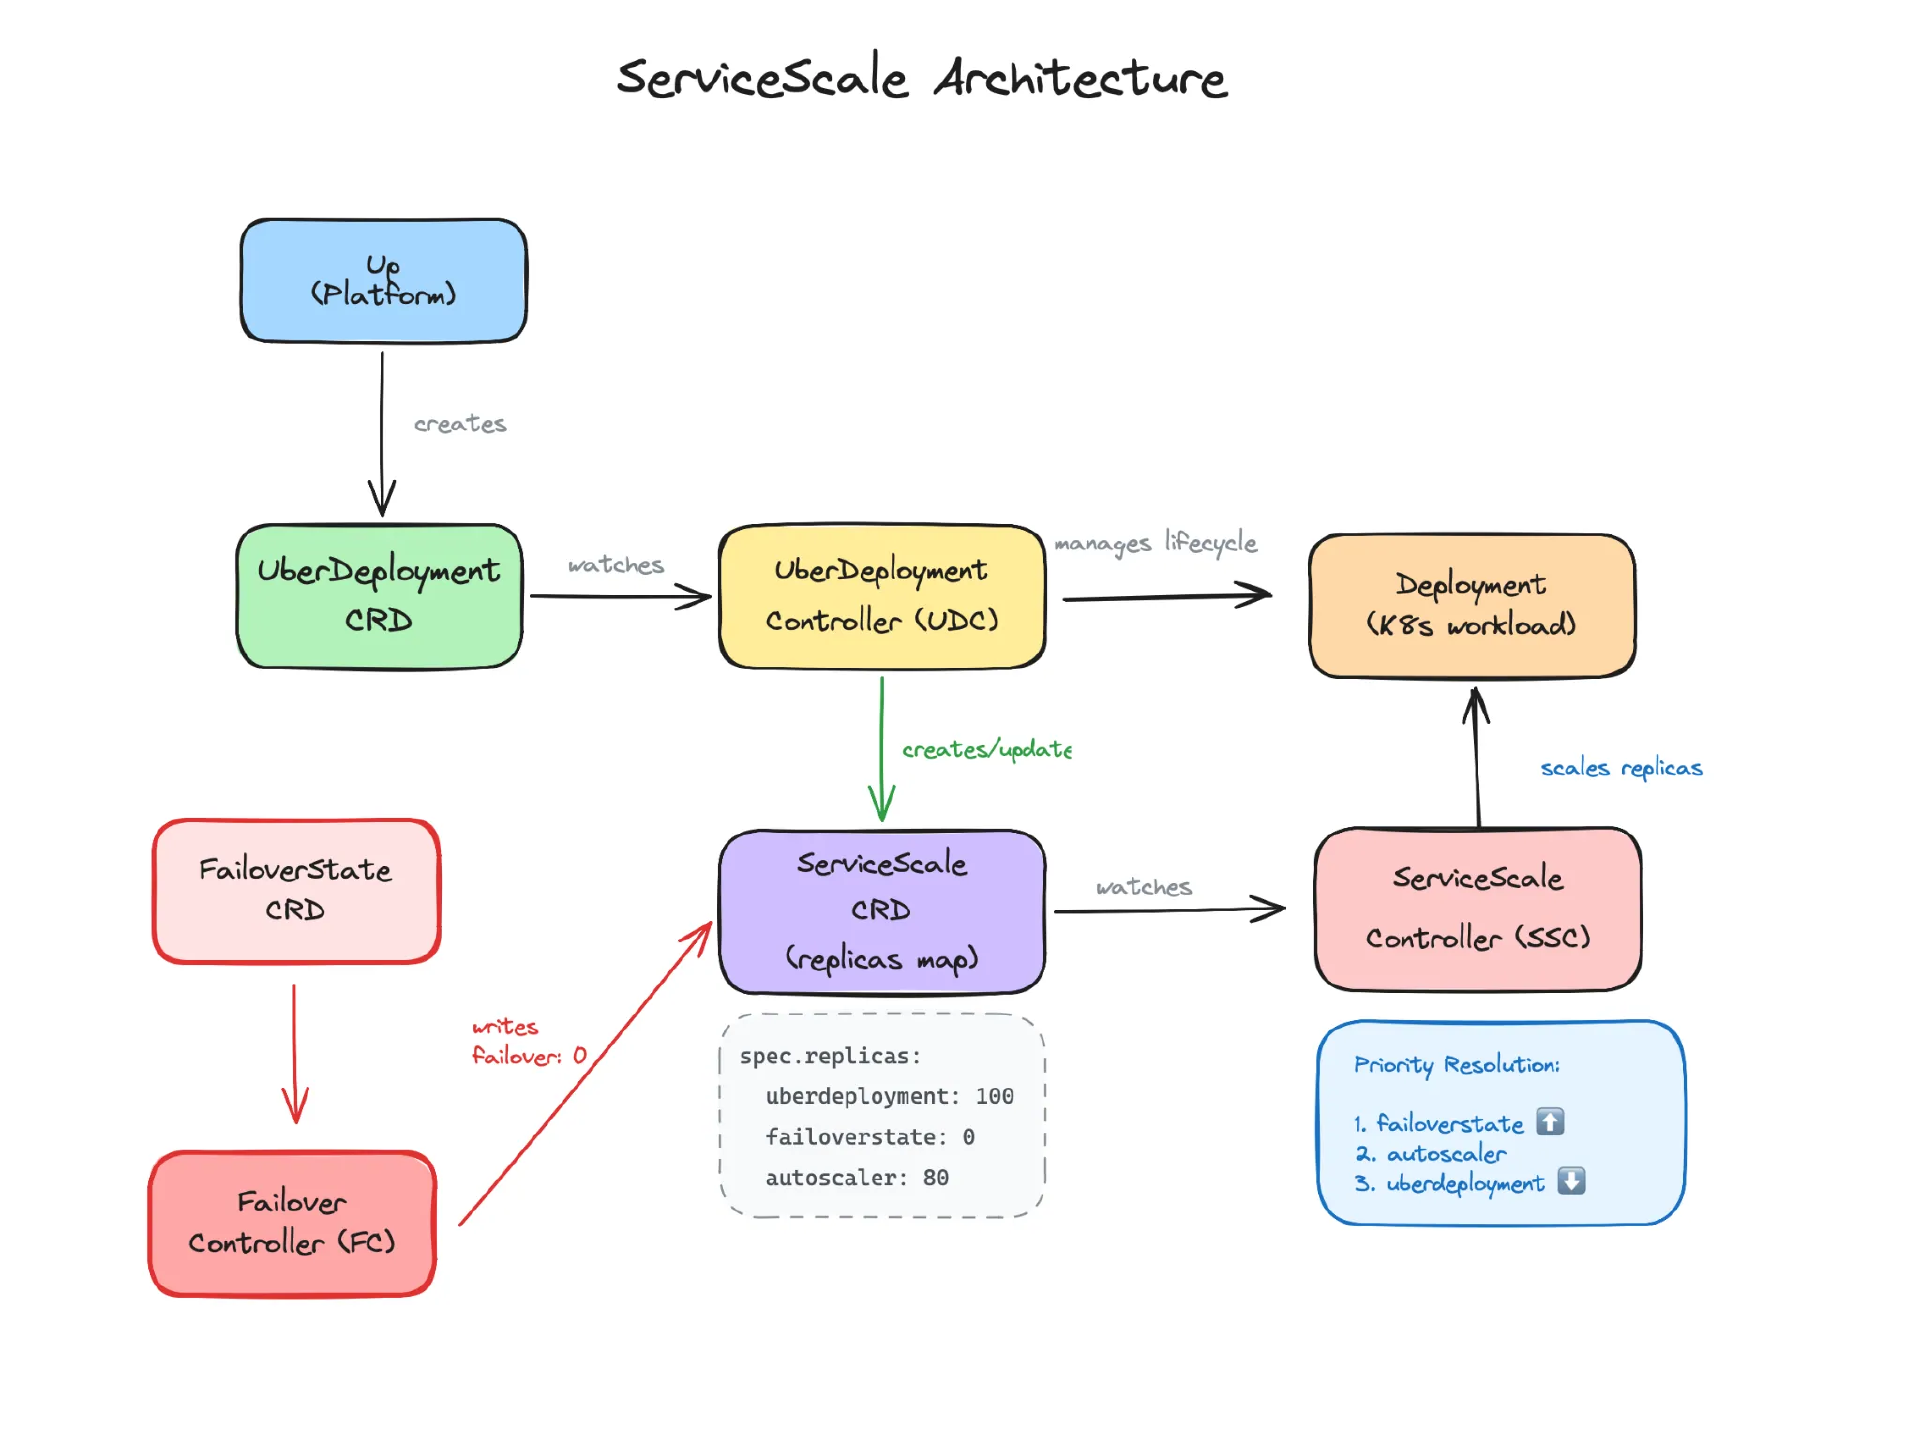
为了解决这个问题,Uber 引入了意图与执行解耦的设计思想,核心组件包括一个新的自定义资源定义(CRD)——ServiceScale,以及新的服务扩缩容控制器(SSC)。
1. 意图的分层表达
- 常规意图(UDC): Up 平台和 UDC 负责维护服务的常规期望状态。
- 应急意图(故障转移): 当发生区域故障时,故障转移编排器通过写入 ServiceScale CRD 来表达扩缩容意愿。
2. 执行的统一调和
SSC 控制器成为了“调和者”。它不关心意图的来源,只负责读取所有编排器写入的 ServiceScale 资源,并将其转化为 Kubernetes 的原生对象(如 Deployment 或 CloneSet)进行扩缩容操作。
这种设计的好处显而易见:
- 状态可观测: 所有的扩缩容意图直接物化在 Kubernetes 资源中,无需外部数据库,排查问题时可直接查看 CRD。
- 易于恢复: 稳态和临时故障转移信息都在规范中,恢复时无需重建状态。
生产实战:两个关键避坑指南
在将方案上线的一年过程中,工程师们积累了两条宝贵的经验,对于开发 Kubernetes 控制器的开发者极具参考价值。
经验一:解决 Informer 缓存过期问题(“读己所写”)
Kubernetes 控制器通常依赖 Informer 缓存来读取资源,缓存数据往往比真实状态延迟数秒。如果控制器在缓存过期时误判状态,可能导致错误的操作。
Uber 的解决方案是“读己所写”一致性防护: 当控制器更新下游资源时,会将当前资源版本号作为注解打上。在上报状态前,控制器会先校验本地缓存是否已读到该版本号。如果缓存版本低于已写入版本,控制器将拒绝执行操作。
对开发者的启示: Kubernetes v1.36 已引入类似机制,建议开发者关注 controller-runtime 框架对“读己所写”语义的支持,确保 API 契约的严谨性。
经验二:应对多写入者的并发漂移
在 UDC 和 SSC 同时更新同一个 Kubernetes 资源(如 ReplicaSet)时,特定的时序条件会导致元数据与规范产生漂移,破坏滚动更新的比例,甚至导致工作负载卡死。
应对策略:
- 全集群可观测: 在 UDC 中增加监控,实时检测元数据与规范的不一致。
- 自动修复: 构建自动修复程序,在扩缩容路径中修补受损的 ReplicaSet。
实施效果
经过一年的打磨,该方案上线后未造成客户感知的中断。Uber 的数据表明,通过更灵活的资源复用,他们成功将稳态配置从 2 倍降低到了 1.3 倍,节省了超过 100 万核 CPU。
这一实践也印证了 CNCF 社区的趋势,如 Karmada 项目的毕业和 Kubernetes v1.36 对缓存问题的关注,都指向了同一个方向:多编排器系统的难点不在于 API,而在于如何优雅地处理并发问题。
对于 AI 使用者和开发者而言,理解这种“意图-执行”分离的架构模式,有助于在设计高可用系统时,更好地平衡资源利用率与系统稳定性。