TypeSafe Jev:无需额外 LLM 的 AI Agent 安全守卫
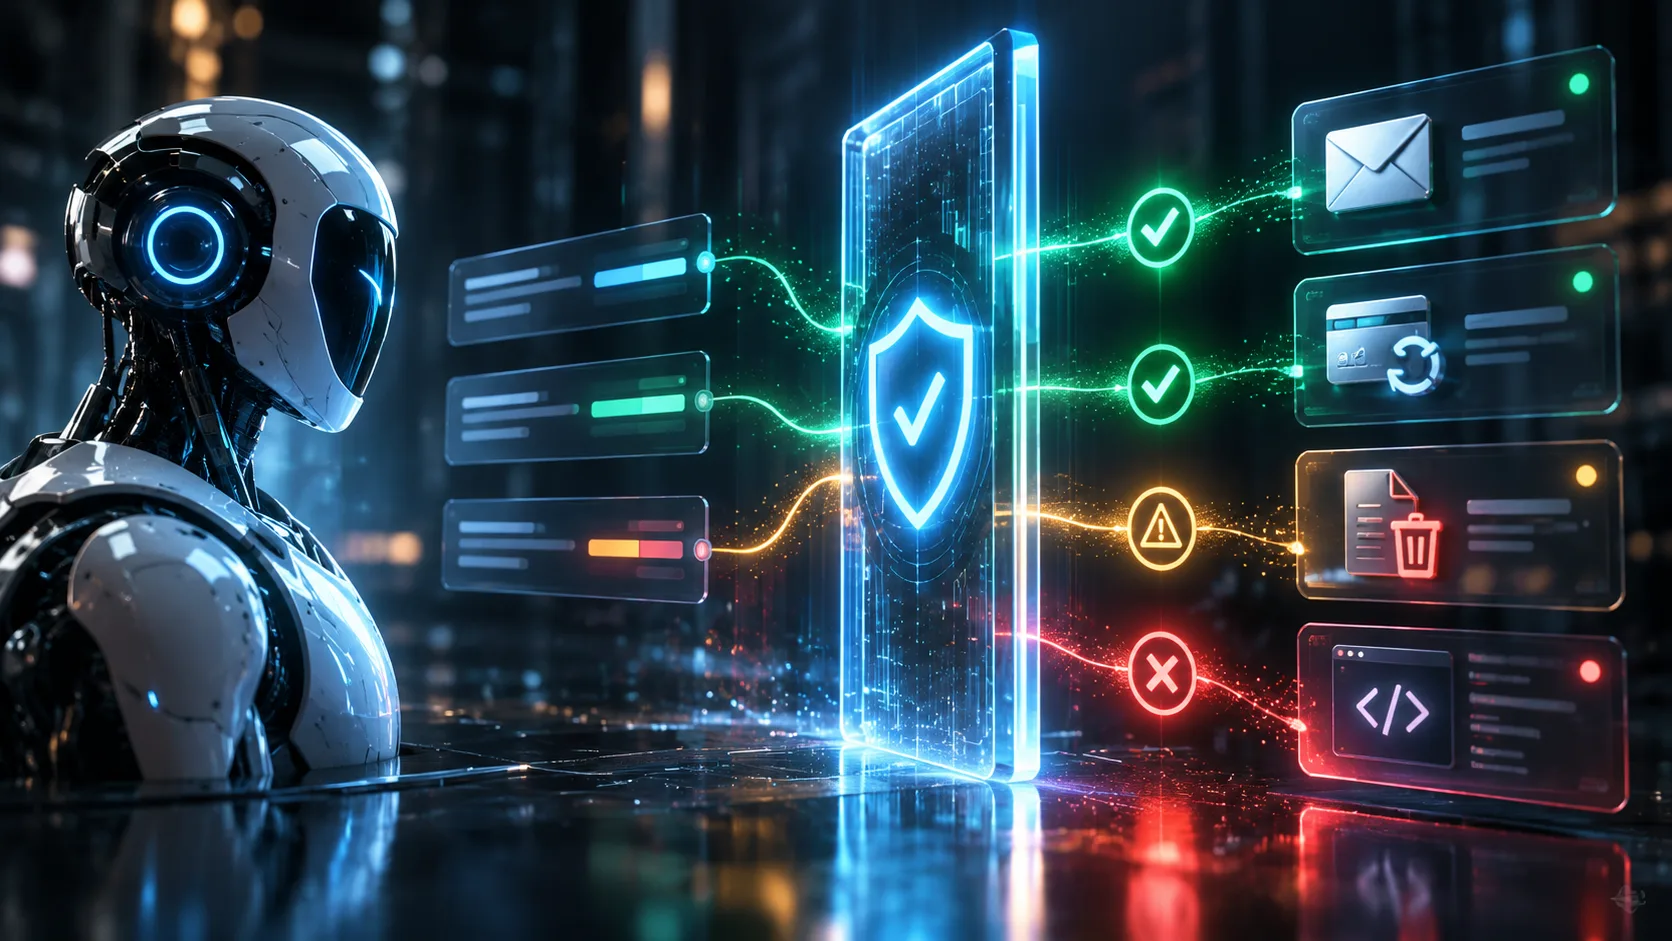
介绍 TypeSafe 推出的 Jev 决策优先模型,它能在 AI Agent 执行工具调用前拦截高风险操作,无需依赖另一个大语言模型,为开发者提供轻量级安全防护方案。
AI Agent 的安全盲区:工具调用风险
随着 AI Agent 从"只会聊天"走向"能动手做事",一个被低估的风险正在浮现——工具调用(Tool Call)的安全性。当 Agent 被授权调用外部工具(如发送邮件、修改数据库、调用支付接口)时,一次错误的参数传递或越权操作,就可能造成真实的业务损失。
传统做法是用另一个 LLM 做安全审查,但这意味着额外的推理成本、更高的延迟,以及"用 AI 审 AI"本身的可靠性问题。
Jev:一个决策优先的安全模型
TypeSafe 推出的 Jev 正是针对这一痛点设计的。它的核心思路是决策优先(Decision-First)——不依赖大语言模型的通用推理能力,而是专注于"判断当前工具调用是否安全"这一单一任务。
与通用 LLM 不同,Jev 不需要理解自然语言的全部语义,它只需要回答一个问题:这个即将执行的工具调用,风险有多高?
为什么不需要另一个 LLM?
这是 Jev 最值得关注的点。用另一个 LLM 做安全审查,存在几个实际问题:
- 成本叠加:每次工具调用都要多跑一次 LLM 推理,在高频调用场景下成本翻倍
- 延迟增加:安全审查串行在主流程中,会拖慢整体响应速度
- 审查一致性差:通用 LLM 的安全判断可能因提示词措辞不同而波动
Jev 作为专用模型,可以在不增加 LLM 推理开销的前提下完成风险拦截,这对生产环境的部署非常友好。
工作原理:在动作落地前拦截
Jev 的工作时机是 工具调用发出之后、实际执行之前。流程大致如下:
- Agent 决定调用某个工具,生成调用参数
- Jev 接收这次调用请求,评估其风险等级
- 如果判定为高风险,Jev 拦截该调用,阻止其执行
- 如果判定为安全,调用正常放行
这意味着 Jev 是一个轻量级的中间件层,可以嵌入到现有的 Agent 框架中,而不需要重写 Agent 的核心逻辑。
对开发者的实用价值
对于正在构建 AI Agent 应用的开发者来说,Jev 带来的价值可以总结为三点:
- 降低安全门槛:不需要自己训练安全模型,也不需要维护复杂的规则引擎
- 控制成本与延迟:专用模型比通用 LLM 审查更轻量,适合生产级部署
- 快速集成:作为中间件插入现有工具调用链路,改动成本低
适用场景
Jev 特别适合以下场景:
- Agent 拥有写权限的工具调用(如修改文件、发送消息、操作数据库)
- 工具调用涉及外部 API 且失败代价较高的场景
- 需要实时拦截而非事后审计的安全需求
小结
AI Agent 的安全性不能只靠提示词约束或事后审计,在动作执行前做决策才是更可靠的防线。Jev 通过"决策优先"的专用模型思路,提供了一种不依赖额外 LLM 的轻量级安全方案,值得在 Agent 安全架构设计中关注。
本文基于 Towards Data Science 的公开内容,由 AI 辅助整理改写后发布。
原标题:Can TypeSafe's Jev Make AI Agents Safer Without Another LLM?
阅读原文