RLHF后训练新书发布:50%折扣及核心解读
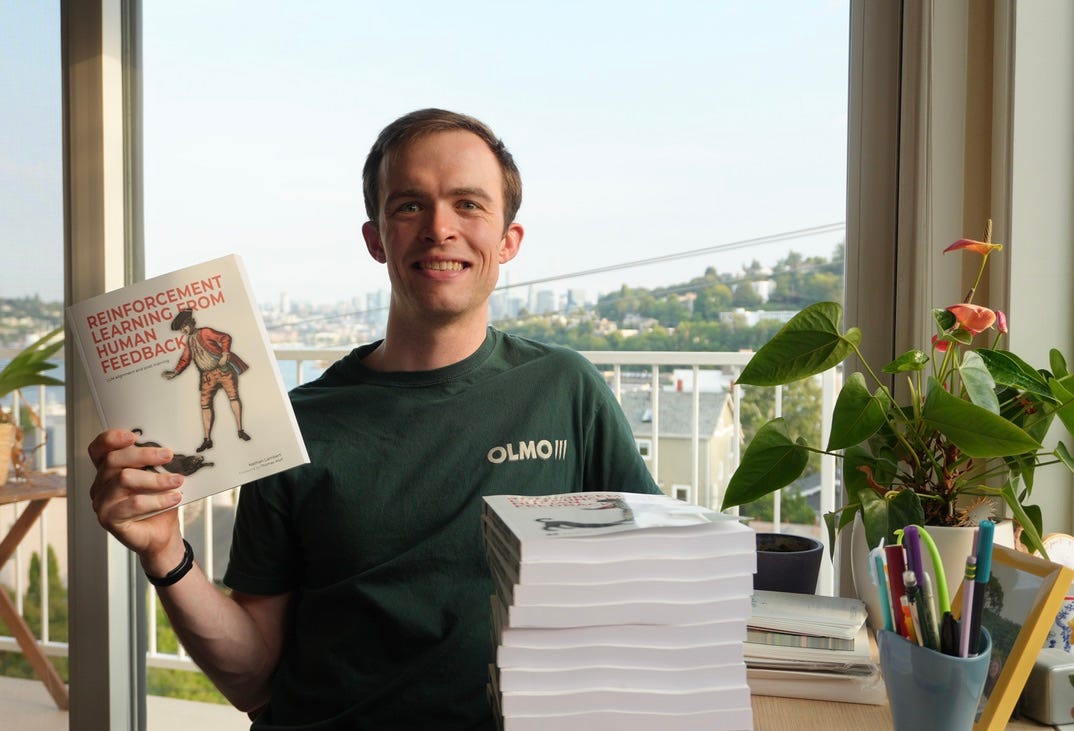
资深研究员Nathan Lambert新书《Reinforcement Learning from Human Feedback》上线,详解RLHF与模型后训练。包含12小时课程与50%折扣优惠,适合有CS基础的开发者。
RLHF后训练新书发布:50%折扣及核心解读
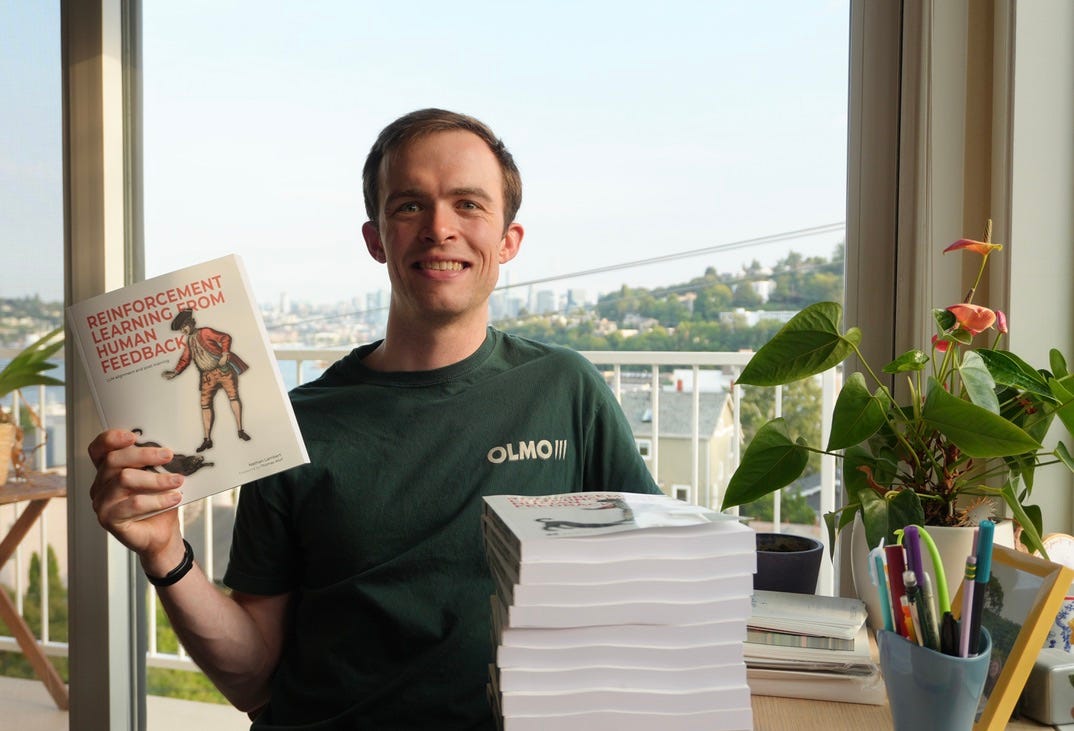
在人工智能领域,特别是大语言模型(LLM)的训练中,后训练 是决定模型表现的关键环节。然而,关于这一领域的系统性文档往往稀缺且晦涩。资深研究员 Nathan Lambert 的新书《Reinforcement Learning from Human Feedback: Aligning and Post-training LLMs》填补了这一空白,为开发者和研究人员提供了一份详尽的指南。
为什么你需要这本关于“后训练”的书?
Lambert 在 Interconnects 博客上积累了多年的实战经验,他发现市面上关于后训练技术的资料要么极其复杂难懂,要么根本不存在。这本书正是基于他在训练开源模型时遇到的痛点而写。
1. 侧重直觉而非枯燥的数学
市面上大多数技术书籍都堆砌了大量数学公式,但 Lambert 选择了不同的路径。这本书的核心价值在于沟通直觉和历史背景。
- 解决痛点:书中涵盖了拒绝采样、结果奖励模型、角色训练等关键技术,用通俗易懂的方式解释了这些概念。
- 纠正误区:帮助读者理解后训练的权衡取舍,避免陷入常见的认知误区。
- 高语调叙事:为了降低阅读门槛,书中保留了较高的叙事性,读起来更像是一篇深入浅出的技术散文,而非死板的教科书。
2. 针对进阶开发者的实战手册
这并不是一本给编程初学者的入门书,而是专为已完成计算机科学学士学位的开发者准备的。
对于已经掌握基础概念的开发者,这本书能帮助你构建更完善的“后训练世界观”。Lambert 本人仍在定期使用这本书,许多行业内的资深研究员也将其作为案头参考。
核心技术亮点:如何理解RL算法?
书中约 25% 的篇幅专门讲解强化学习(RL)算法。这部分内容对于想要深入理解模型如何从人类反馈中学习的开发者至关重要。
理解算法的“六个区域”
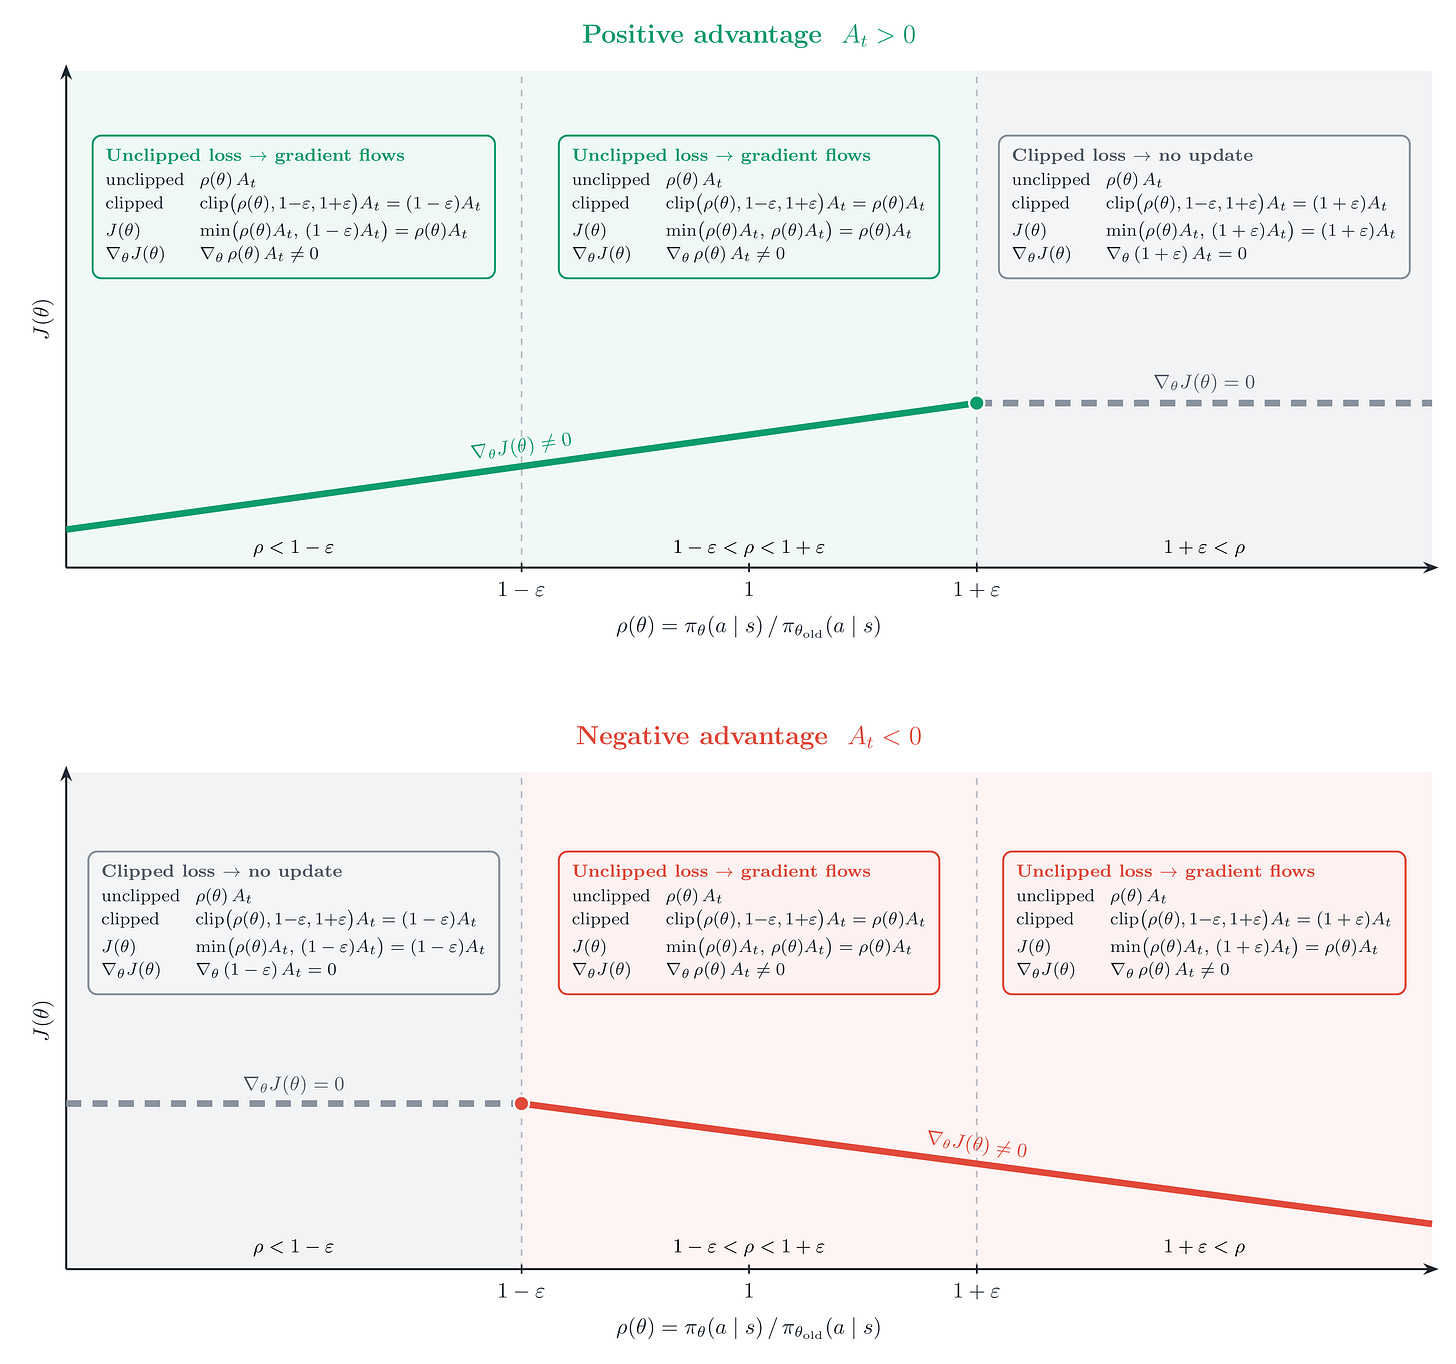
书中重点剖析了 PPO(Proximal Policy Optimization)等经典算法的底层逻辑。例如,作者通过一个直观的图表,将 PPO 的目标函数简化为六个关键区域。
- 梯度分析:通过这些区域,读者可以直观地看到当 Token 的优势值为正或负时,策略梯度如何变化。
- 算法评估:这不仅有助于理解 PPO,还能让你学会如何判断一个新提出的 RL 算法是“伪创新”还是真正有潜力的改进。
从基础到前沿
内容覆盖了从基础策略梯度定理到现代变体如 GSPO 和 CISPO 的演进,让你在阅读新论文时能更快地抓住重点。
如何获取?超值优惠与资源
为了让更多人受益,作者提供了丰富的资源包。
- 50% 折扣优惠:目前通过 Manning 出版社购买,使用代码 PBLambert 可享受半价优惠,活动截止日期为 8 月 19 日。
- 免费在线阅读:书籍内容完全免费在线提供。
- 配套课程与代码:购买后包含一个 12 小时的完整课程(含视频和幻灯片),以及配套的代码库和模型对比实验。
这本书现已从 Manning 和 Amazon US 发货,英国站预计将于 10 月上线。对于希望在 AI 后训练领域进阶的开发者来说,这无疑是一本不容错过的资源。
总结
如果你正在寻找一本能够弥合数学理论与工程实践之间差距的书籍,这本《Reinforcement Learning from Human Feedback》是最佳选择。它不仅解释了“怎么做”,更解释了“为什么这样做”,能极大提升你对模型对齐技术的理解深度。
本文基于 Interconnects 的公开内容,由 AI 辅助整理改写后发布。
原标题:5 useful things you'll learn in my new post-training textbook (shipping now!)
阅读原文