PrismAlign:多视角VLM对齐如何终结表格OCR幻觉
华为团队提出的PrismAlign框架借鉴人类双目视觉原理,通过多VLM视角交叉验证与贝叶斯决策层,将表格提取幻觉从系统性偏差降为可控噪声,在OmniDocBench 1.5上TEDS达94.62。
从ADC到Token化:一场对称的信息革命
八十年前,模数转换(ADC)把光、电、温度等连续信号离散化为比特,催生了德州仪器、高通、华为等一批产业巨头。八十年后的今天,大语言模型正在做一件对称的事——把图像、版式、表格、手写体等非结构化信息词元化为模型可消费的结构化表征。
正如ADC的有效位数决定了数字信号对物理世界的保真度,文档结构化提取的还原精度,构成了大模型时代数据管线的有效位宽。在模拟域,高性能ADC的误差已逼近$10^{-n}$量级;我们有理由预判:文档提取的字段级错误率将从$10^{-1}$逐步压至$10^{-2}$,最终向$10^{-n}$区间收敛。每一次数量级的收敛,都意味着幻觉风险的实质性收缩与商业落地确定性的阶跃。
痛点:VLM幻觉为何成为系统性偏差
表格是商业世界结构化信息最密集的载体——财报、保单、报关单、工程图纸的物料清单,几乎全部以表格形态沉淀在扫描件与版式PDF中。把这份"纸面结构"无损还原为机器可消费的Markdown或HTML,看似是OCR老问题,实则是多模态理解尚未啃下的硬骨头。
GPT-4V、Qwen-VL、InternVL等VLM的入场曾让人看到希望,但一旦进入真实生产环境,幻觉从偶发噪声退化为系统性偏差——凭空补出源图中不存在的单元格、把多级表头压平为单层、将模糊墨点"脑补"成货币符号。这并非模型偷懒,而是单视角视觉推理的固有盲区:就像观察者在侧逆光、低对比度下读一张折叠过的网格纸,视觉残差会本能地由先验填补。
更深层的问题在于训练资源的碎片化:各家头部厂商各自囤积独家标注语料,在自有Benchmark上表现优异,但缺乏统一开源数据集,每家模型都发展出了独特的优势和偏见。
生物学启示:为什么多视角天然优于单目
PrismAlign(棱镜对齐)的核心隐喻来自人类立体视觉:左右眼以约6-7厘米基线采集到存在视差的两帧信号,视皮层在自下而上的特征映射之上,再做一层视差估计与置信融合——同一边缘在双目中一致则提升为本体轮廓,仅单侧出现的伪纹理则被抑制为噪声。
立体视觉的本质不是"看两遍",而是用视角间的交叉验证把单目先验的越位空间压缩掉。这也解释了为什么单眼在弱光、遮挡场景下极易产生"脑补"——缺乏第二视角的反证,经验式补全就会接管感知。
回看信息技术史的几次范式切换,节奏高度同构:通信从单天线走向MIMO空分复用,计算从单核走向众核,存储从单机走向分布式共识。文档感知同样逃不开"由单通道走向多通道共识"的通用曲线——差别只在于,这里的"多通道"不是物理阵列,而是同一视觉信号在模型空间里的多先验投影。
技术解构:三步实现棱镜般的清晰对齐
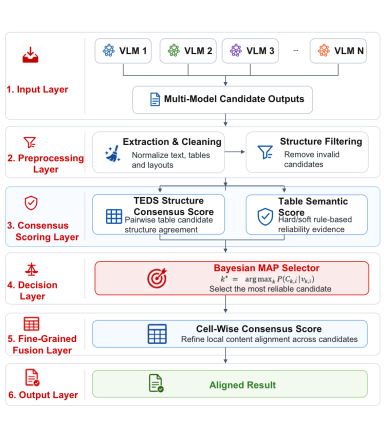
1. 解耦:结构对齐与内容对齐
表格识别的错误天然分属两个独立维度:结构错误(合并单元格边界判定失误、行列拓扑错乱)与内容错误(字符误识、数字漏读)。产生机理完全不同——结构错误来自视觉token对版式几何的建模偏差,内容错误更多来自OCR解码阶段的置信度塌缩。PrismAlign将两者解耦处理,让每一路对齐都能针对自己的错误模式选择最合适的相似度度量与融合权重。
2. 先验约束:几何不变量作为安全护栏
表格区别于自由文本的天然优势在于——它是一个受严格几何与逻辑约束的离散结构。PrismAlign将领域知识显式编码为一组先验约束:
- 行列守恒:计入合并单元格后,表格每一行的有效列数应当一致
- 物理极限:绝大多数业务文档基于A4幅面,行列数天然存在合理上界
论文将这些先验约束与提取错误之间的相关性建模为概率事件,推导了贝叶斯估计公式。纯模型提取走的是经验主义路径,遇到低质扫描只能以先验"猜"出缺失网格;而几何不变量对应的是理性主义立场——无论训练分布覆盖到哪,一个合法表格在笛卡尔离散空间里就应当满足行列守恒与幅面有界。
3. 贝叶斯推断:最大后验概率下的结构化投票
在推断阶段,系统对每个候选提取结果计算其在给定多视角观测下的最大后验概率(MAP)。当存在多个竞争选项时,框架引入TEDS-Structure相似度作为结构层面的两两比较度量,过滤掉与多数视角在拓扑上显著偏离的异常输出。这比纯数据驱动的端到端融合多了一层可解释的几何合法性校验。
性能表现:从数据飞轮到算力换精度
过去很长一段时间里,多VLM组合在文档智能管线中的角色是幕后的——MinerU 2.5 Pro、PaddleOCR-VL 1.5等技术的范式高度一致:用多个模型交叉标注、滤噪,把冗余性消耗在训练数据生产环节,最终仍收敛回单个推理模型交付。
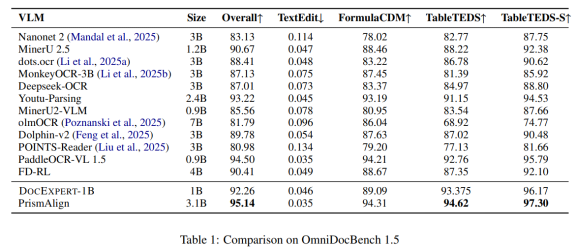
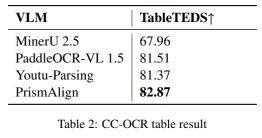
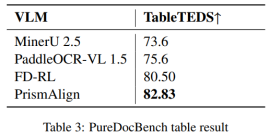
PrismAlign做的关键转向,是把多VLM从标注后台推到推理前台:不再用多模型去造数据,而是做决策。这一角色切换让框架在多个权威榜单上拿到了可量化优势——在OmniDocBench 1.5上TEDS达到94.62,TEDS-Structure达到97.30,Overall达到95分区间;在CC-OCR、PureDocBench等榜单的表格任务上也达到了SOTA。
值得单独点出的是,这些数字并非来自更大参数量、更长标注链或私有数据囤积,而是在优质开源模型之上叠加一层多视角贝叶斯融合,使系统稳态精度稳定站到任一单backbone之上。这样的设计也建立在华为的硬件自信之上:昇腾系列天然支持"多模型并行观测+决策层低延迟归并"的部署形态。
对开发者的实用价值
对于正在构建文档智能管线的团队,PrismAlign的启示在于:与其在单模型能力的红海里内卷,不如把问题重新定义为系统层命题——如何让生态中已有的多路开源VLM,通过架构级设计实现互补。这与华为在基站、终端、超节点等惯用打法同构:不赌单点器件的绝对领先,而是以系统调度、多源融合、软硬协同,把既有组件的能力上限再抬一个台阶。