Kubernetes 控制面扩容的三个瓶颈
Kubernetes 控制面并非无限可扩展,etcd 对象数、API 请求速率、调度与控制器吞吐量是三大常见瓶颈。本文梳理每种瓶颈的成因与应对思路。
为什么控制面会成为瓶颈?
很多团队在 Kubernetes 集群规模扩大后,首先遇到的不是节点不够用,而是控制面组件先扛不住。控制面由 API Server、etcd、Scheduler、Controller Manager 等组成,它们共同维护集群状态。当 Pod 数量、对象数量或请求频率超过阈值,整个集群就会出现响应变慢、调度延迟甚至不可用的情况。
下面逐一拆解三个最常见的瓶颈。
瓶颈一:etcd 对象数量与数据体积
etcd 是 Kubernetes 的单一事实来源,所有对象(Pod、Service、ConfigMap、Deployment 等)的状态都存储在 etcd 中。etcd 的默认数据库大小限制为 2 GB,超过这个阈值后写入会变慢,甚至拒绝写入。
常见触发场景:
- 大量短生命周期 Pod(如 Job、CronJob)产生的历史对象未及时清理
- 使用大量 ConfigMap 和 Secret 存储配置
- 未设置 TTL 或清理策略的自定义资源
应对思路:
- 定期清理已完成的 Job 和 Pod 对象
- 使用
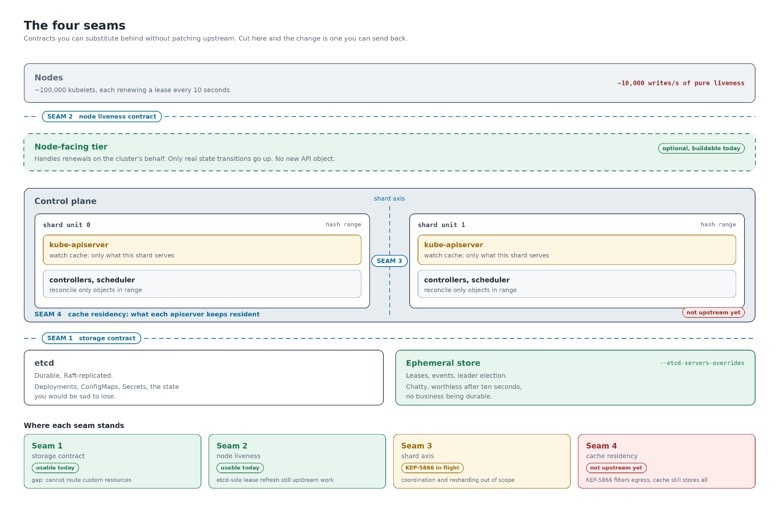
--etcd-servers配合 etcd 的 compaction 和 defrag 机制 - 对 ConfigMap/Secret 做瘦身,避免存储大文件
瓶颈二:API Server 请求速率与 Watch 连接数
API Server 是所有组件访问集群状态的入口。当大量控制器、客户端同时发起 watch 请求或高频轮询时,API Server 的连接数和请求 QPS 会迅速逼近上限。
常见触发场景:
- 大量自定义控制器同时 watch 同一种资源
- 监控工具(如 Prometheus、Datadog)高频采集指标
- 第三方工具通过 API 频繁创建/删除资源
应对思路:
- 合理设置 API Server 的
--max-requests-inflight和--max-mutating-requests-inflight - 使用 Informer 缓存机制替代直接轮询
- 对非关键 watch 添加退避重试和限流逻辑
- 考虑使用 API Aggregator 或自定义 API 来分流请求
瓶颈三:Scheduler 与 Controller Manager 的吞吐量
Scheduler 负责将 Pod 调度到合适的节点,Controller Manager 负责维护各种控制器的期望状态。当 Pod 数量激增(如大规模扩容)时,这两个组件的调度延迟和调和延迟会明显上升。
常见触发场景:
- 一次性创建数千个 Pod(如弹性伸缩触发)
- 大量 Deployment 同时滚动更新
- 自定义控制器逻辑复杂,单次调和耗时过长
应对思路:
- 使用 Scheduler Framework 扩展调度策略,优化打分逻辑
- 对 Deployment 设置合理的
maxSurge和maxUnavailable,避免同时更新过多副本 - 将自定义控制器的调和逻辑异步化,避免阻塞主循环
- 考虑使用 Leader Election 和水平扩展控制器实例
实用建议:如何提前发现瓶颈?
- 监控 etcd 指标:关注
etcd_mvcc_db_total_size_in_bytes和etcd_server_leader_changes_seen_total - 监控 API Server 指标:关注
apiserver_request_total、apiserver_request_duration_seconds - 设置告警阈值:当对象数量超过预期的 70% 时提前预警
- 定期压测:在预生产环境模拟大规模场景,验证控制面容量
总结
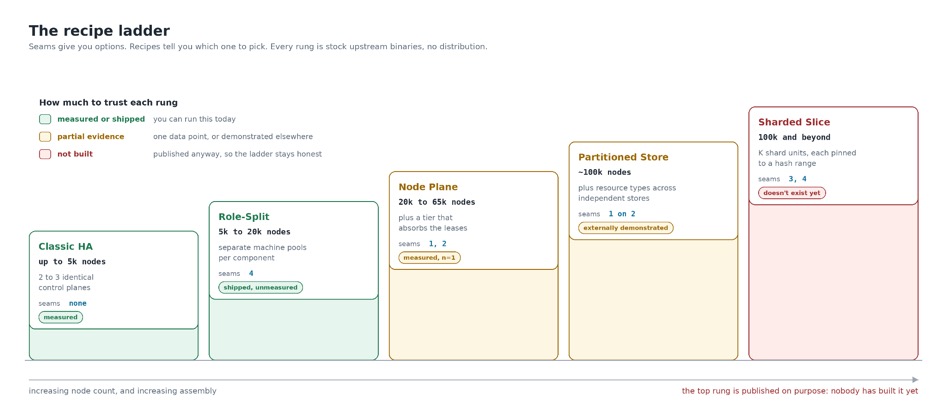
Kubernetes 控制面的扩容不是简单地加机器,而是需要理解每个组件的资源边界和吞吐上限。在集群设计初期就规划好对象数量上限、API 请求模式和调度策略,可以大幅降低后期运维成本。对于正在构建大规模 Kubernetes 基础设施的团队,建议将控制面容量规划纳入架构评审流程。
本文目录(6 节)
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Scale isn’t one number: three ways a Kubernetes control plane runs out of room
阅读原文