GPT-6模型选型与生产环境优化指南
本文深入解析GPT-6家族(Astra/Sol/Luna)的选型策略,详解上下文缓存、推理强度调整等生产环境优化技巧,以及如何通过提示词和异步工具管理长任务。
2026-10-03 0来源:OpenAI Blog
GPT-6 系列模型作为 OpenAI 迄今最先进的模型,提供了从顶级智能到极致速度的多种选择。对于开发者而言,如何根据业务需求选择合适的模型、控制成本并确保生产环境的稳定性,是构建高质量 AI 应用的关键。以下是一份实用的实战指南。
一、 模型选型:平衡智能、成本与速度
选择模型本质上是在智能水平与价格之间做权衡。GPT-6 家族包含三款核心模型,各有侧重:
- GPT-6 Astra:最智能的模型,适合难度最大的推理工作。输入 $10.00,输出 $50.00。
- GPT-6.1 Sol:接近 Astra 的智能水平,但价格仅为其五分之一。适合复杂编程、研究和计算机使用任务。输入 $2.00,输出 $10.00。
- GPT-6 Luna:快速高效,适合大规模处理特定任务,如发票提取、请求分类或生成结构化摘要。输入 $0.10,输出 $0.50。
除了模型本身,开发者还需要关注推理强度和速度模式:
- 推理强度:在 API 中选择任务投入的资源。低(常规任务)、中(规划/比较)、高(调试/分析)、极高/Max(仅在效果提升抵消成本时使用)。
- 速度模式:聊天或编程工具可使用快速模式(响应更快但单价更高);超高速模式适用于需要快速迭代代码的场景。
二、 生产环境优化:控制成本与上下文
在生产环境中高效运行 GPT-6,必须重视上下文管理和成本控制。
善用上下文缓存 这是降低成本的关键。对于重复性工作,启用缓存输入可节省高达 95% 的 Token 费用。建议将固定的指令和参考资料放在会变化的任务细节之前,并保持工具定义一致。部署前务必测试缓存复用率,并计入缓存写入费用。
压缩与并行处理 对于较长的对话,使用压缩技术减小上下文体积,同时保留执行所需状态。此外,尽量并行运行彼此独立的任务,避免某个缓慢的步骤拖累整个流程。
监控与规划 部署前需衡量任务成功率、延迟以及每次成功的成本。利用仪表板监控缓存失效的环节,并审查应用的数据控制措施。
三、 提示词工程:明确边界与任务定义
随着模型理解能力的提升,过度的详细指导反而可能成为负担。优化提示词的核心在于“明确”与“边界”。
- 定义“完成”的标准:不要只要求模型“修复代码”,而应明确“完成”包含实施改动、运行测试、检查结果并修复问题等全流程。
- 设定决策边界:明确哪些操作可以独立执行,哪些需要批准。例如,模型可以决定摘要的组织方式,但在更改项目范围前必须征求你的意见。
- 更新 AGENTS.md:说明特定文档和测试的适用范围,并授权安全的常规工作流(如本地测试不访问生产环境)。
四、 管理长时间运行的任务
GPT-6 支持处理持续数小时甚至数天的复杂任务。利用以下功能可让工作流更顺畅:
- 异步工具与并行工作:在 API 中,模型可以在应用执行较慢任务(如测试)时,继续处理其他独立工作,结果就绪后再进行依赖处理。
- 中途引导:通过 Responses WebSocket API,你可以在模型运行中途发送纠正信息,这些更新会进入队列,不会取消已运行的工具。
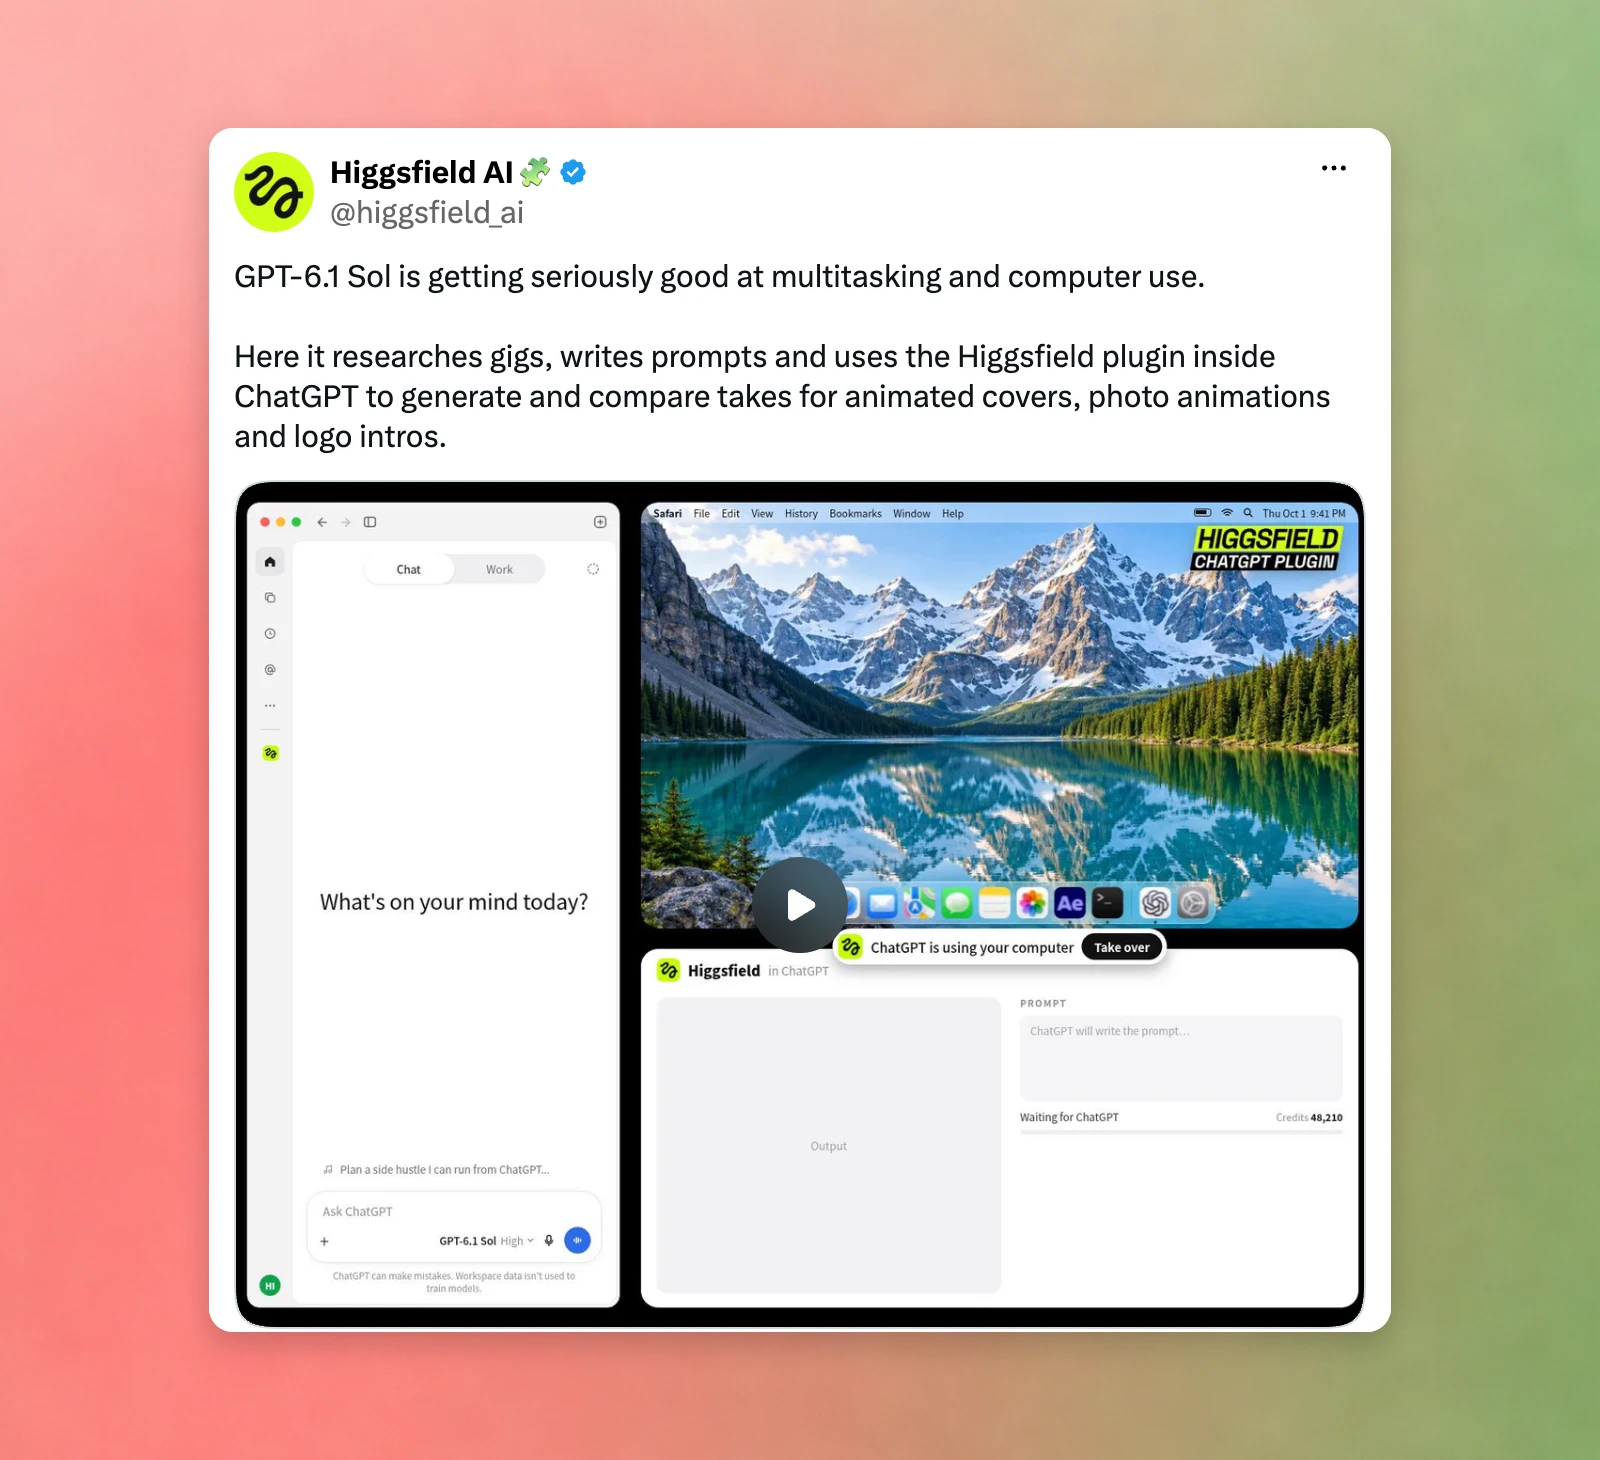
- 计算机使用能力:GPT-6 Astra 和 Sol 可以直接操作浏览器或桌面应用。开发者可以通过 Playwright 控制浏览器,或通过 PyAutoGUI 操作桌面软件,让模型自动完成从测试到生产环境的闭环验证。
五、 实战应用案例
- Harvey(法律领域):利用 GPT-6 Astra 结合法院信息、判例法,提供更丰富的上下文,大幅提升文稿质量。
- Cognition (Devin):使用 GPT-6 Astra 进行自动化测试,生成模拟器录屏和详细报告,清晰展示已通过和未测试的项。
- Hex(数据分析):将业务问题转化为交互式仪表板,通过 GPT-6 Astra 实现从文本分析到可视化的快速转化。