GitHub自测AI代码审查:Copilot领先,独立评测结论却不同
GitHub发布自研代码审查基准测试,Copilot表现领先,但独立评测给出不同结论。本文探讨AI代码审查工具评测中的自测偏差问题及其对开发者的实际影响。
一个耐人寻味的事实
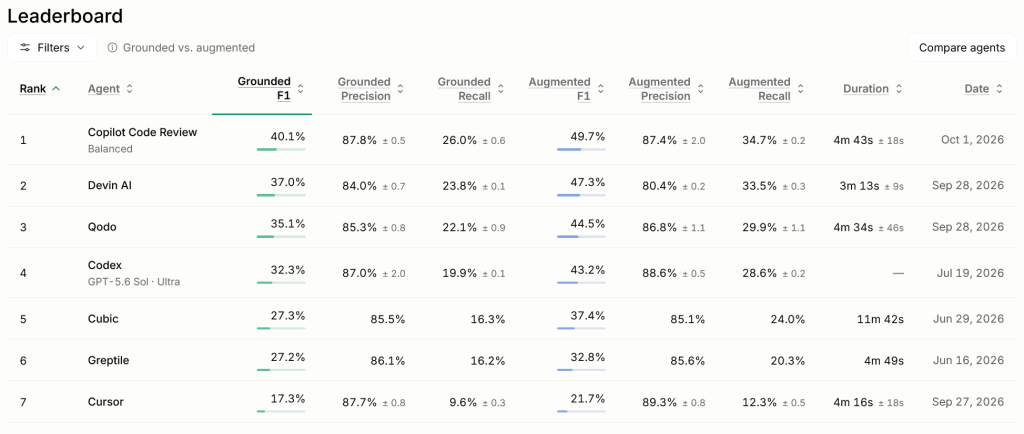
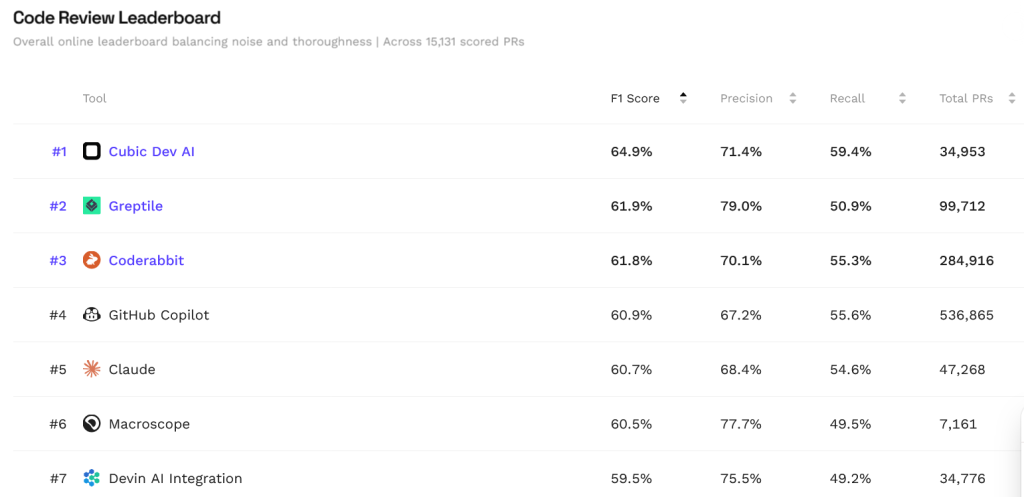
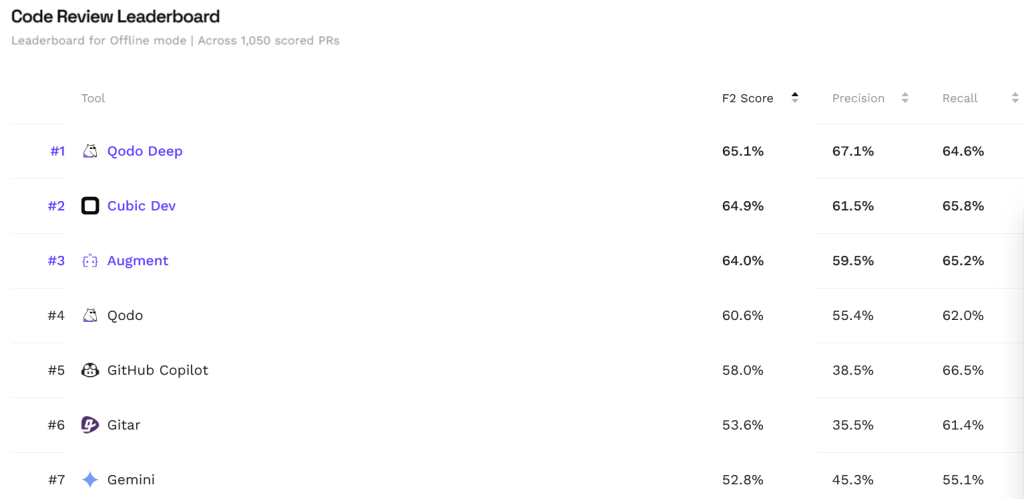
GitHub 推出了一项自研的代码审查基准测试(ReviewBench),在其自家评测中,Copilot 位居榜首。然而,当独立的第三方机构对同类工具进行评估时,结论却大相径庭。
这不是一个孤立事件。在 AI 工具评测领域,"自己出题、自己考试、自己打分"的现象并不罕见。但问题在于,当一家公司既是工具提供方又是评测标准制定者时,结果的客观性难免受到质疑。
自测基准的局限性在哪里?
自研基准测试天然存在几个结构性偏差:
- 测试集偏向:评测题目可能无意中更贴合自家工具的训练数据或优化方向
- 评分维度可控:哪些维度纳入评分、权重如何分配,都由评测方决定
- 对比对象选择:参与对比的工具列表及其版本,未必反映市场全貌
- 发布节奏自主:什么时候公布结果、公布哪些结果,完全由发布方把控
这些并不意味着自测数据一定"造假",但确实意味着自测结果不能等同于客观排名。Copilot 在自家基准中领先,至少说明它在特定测试场景下表现不错,但不能直接推导为"Copilot 是所有代码审查工具中最强的"。
独立评测为什么可能得出不同结论?
独立评测通常面临不同的约束:
- 评测方与工具方无利益关联,评分标准更倾向于中立
- 测试集可能覆盖更广泛的代码场景,包括自测基准未涉及的边界情况
- 对比维度可能更侧重实际开发痛点,如误报率、审查深度、上下文理解等
当独立评测的结论与自测结果不一致时,开发者应该更关注哪一方?答案是:两个都看,但需要理解各自的方法论和局限性。
对开发者的实用建议
如果你正在评估 AI 代码审查工具,以下几个原则可能比任何单一排名更有用:
1. 明确你的核心需求
不同工具在不同场景下各有优势。如果你的团队主要关注:
- 安全漏洞检测 → 关注工具的静态分析深度和已知漏洞库覆盖
- 代码风格与规范 → 关注规则自定义能力和误报率
- 逻辑错误与边界条件 → 关注上下文理解能力和测试用例生成质量
- 性能优化建议 → 关注对热点代码和复杂算法的识别能力
2. 用你自己的代码做 PoC
没有任何公开基准能完全代表你的代码库特征。最可靠的方法是:
- 选取团队中 20-30 个典型 PR(含 bug 修复、功能开发、重构等)
- 让候选工具逐一审查,记录发现的问题
- 与人工审查结果对比,计算召回率和误报率
- 评估审查意见的可操作性——是否具体到可以直接修复
3. 关注误报率而非仅看发现数量
一个能发现 100 个问题但其中 60 个是误报的工具,实际效率可能不如只发现 30 个问题且全部有效的工具。误报率直接影响开发者的信任度和工具采纳率。
4. 理解工具的审查范围
有些工具擅长审查单文件变更,有些能理解跨文件的调用链影响。如果你的项目存在大量跨模块交互,需要确认工具是否支持仓库级上下文分析。
评测偏差的行业启示
这件事揭示了一个更广泛的行业问题:当 AI 工具的评测标准由工具提供方自己制定时,整个生态的决策基础可能不够稳固。
对于开发者而言,这意味着:
- 不要仅凭厂商发布的基准排名做工具选型决策
- 关注独立第三方评测,同时理解其方法论
- 最终还是要回到自己的代码库做验证
对于工具厂商而言,开放评测标准、支持第三方审计、提供可复现的评测环境,是建立信任的长期策略。
总结
Copilot 在 GitHub 自研基准中领先,这是一个事实;独立评测给出不同结论,也是事实。两者之间的张力,恰恰提醒我们:在 AI 工具快速迭代的今天,批判性思维和自主验证能力,比追逐任何单一排名更重要。
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Copilot tops GitHub’s own AI code review benchmark. An independent one tells a different story.
阅读原文