Gemma 4到DeepSeek V4:四大架构创新如何降低长上下文成本
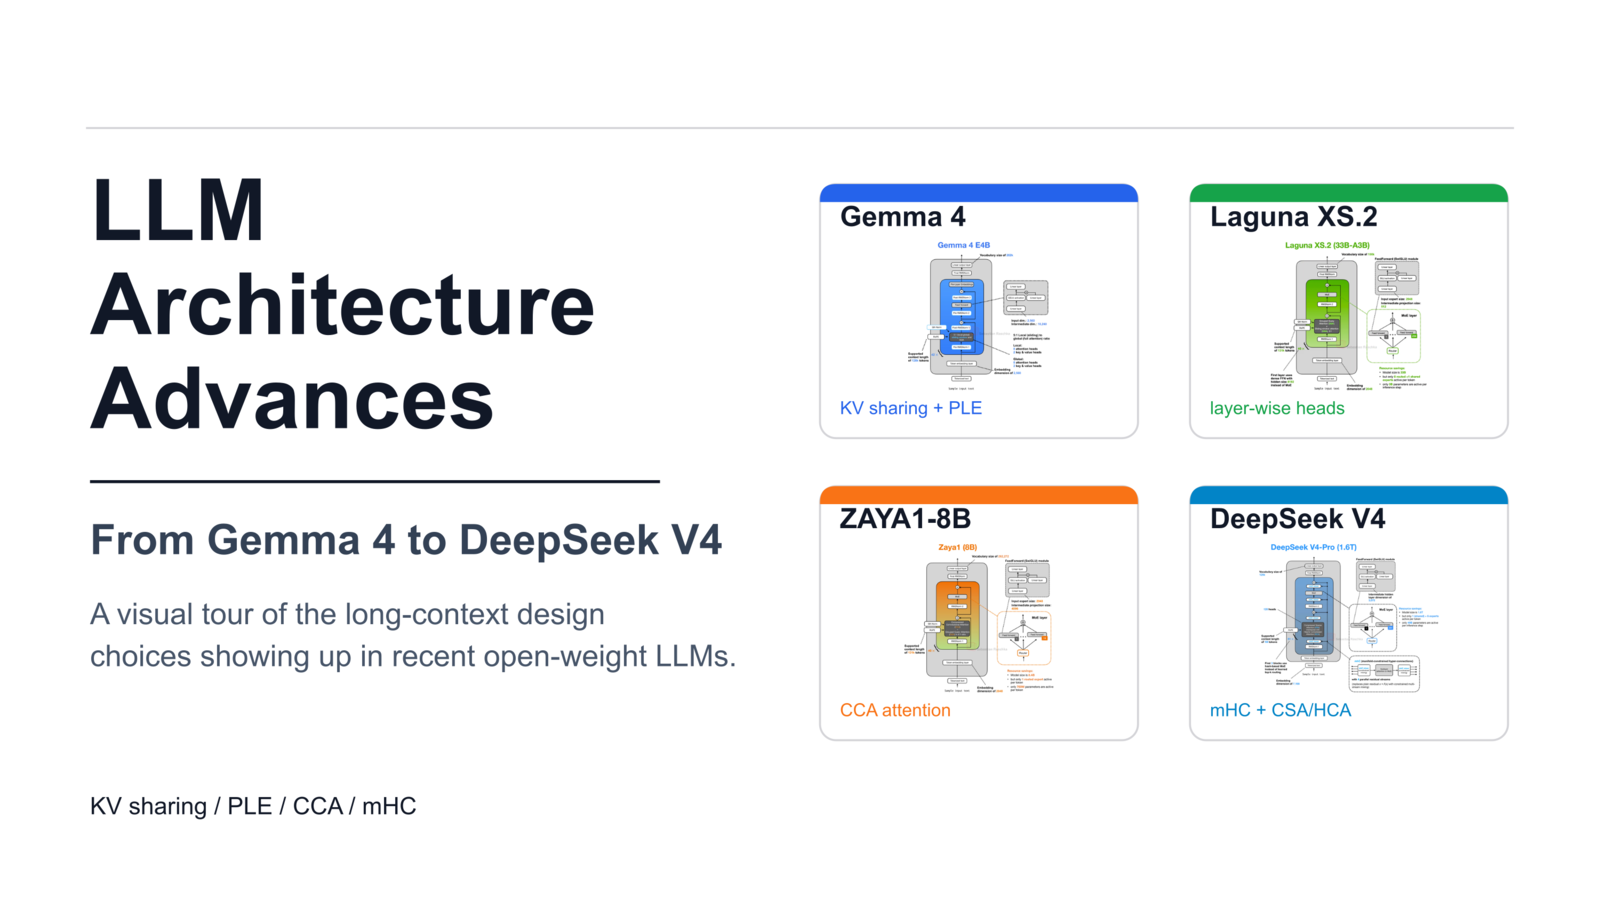
从KV共享到压缩注意力,近期开源LLM通过架构级优化大幅削减长上下文推理的显存与计算开销,本文梳理四项关键技术及其适用场景。
近期开源大模型架构创新:KV共享、mHC与压缩注意力
随着推理模型和Agent工作流需要保留更多token更长时间,KV缓存体积、显存带宽和注意力计算量已经成为制约长上下文能力的核心瓶颈。2026年4月至5月间,多家团队在开源模型中引入了一系列架构层面的优化手段,目标直指降低长上下文推理成本。
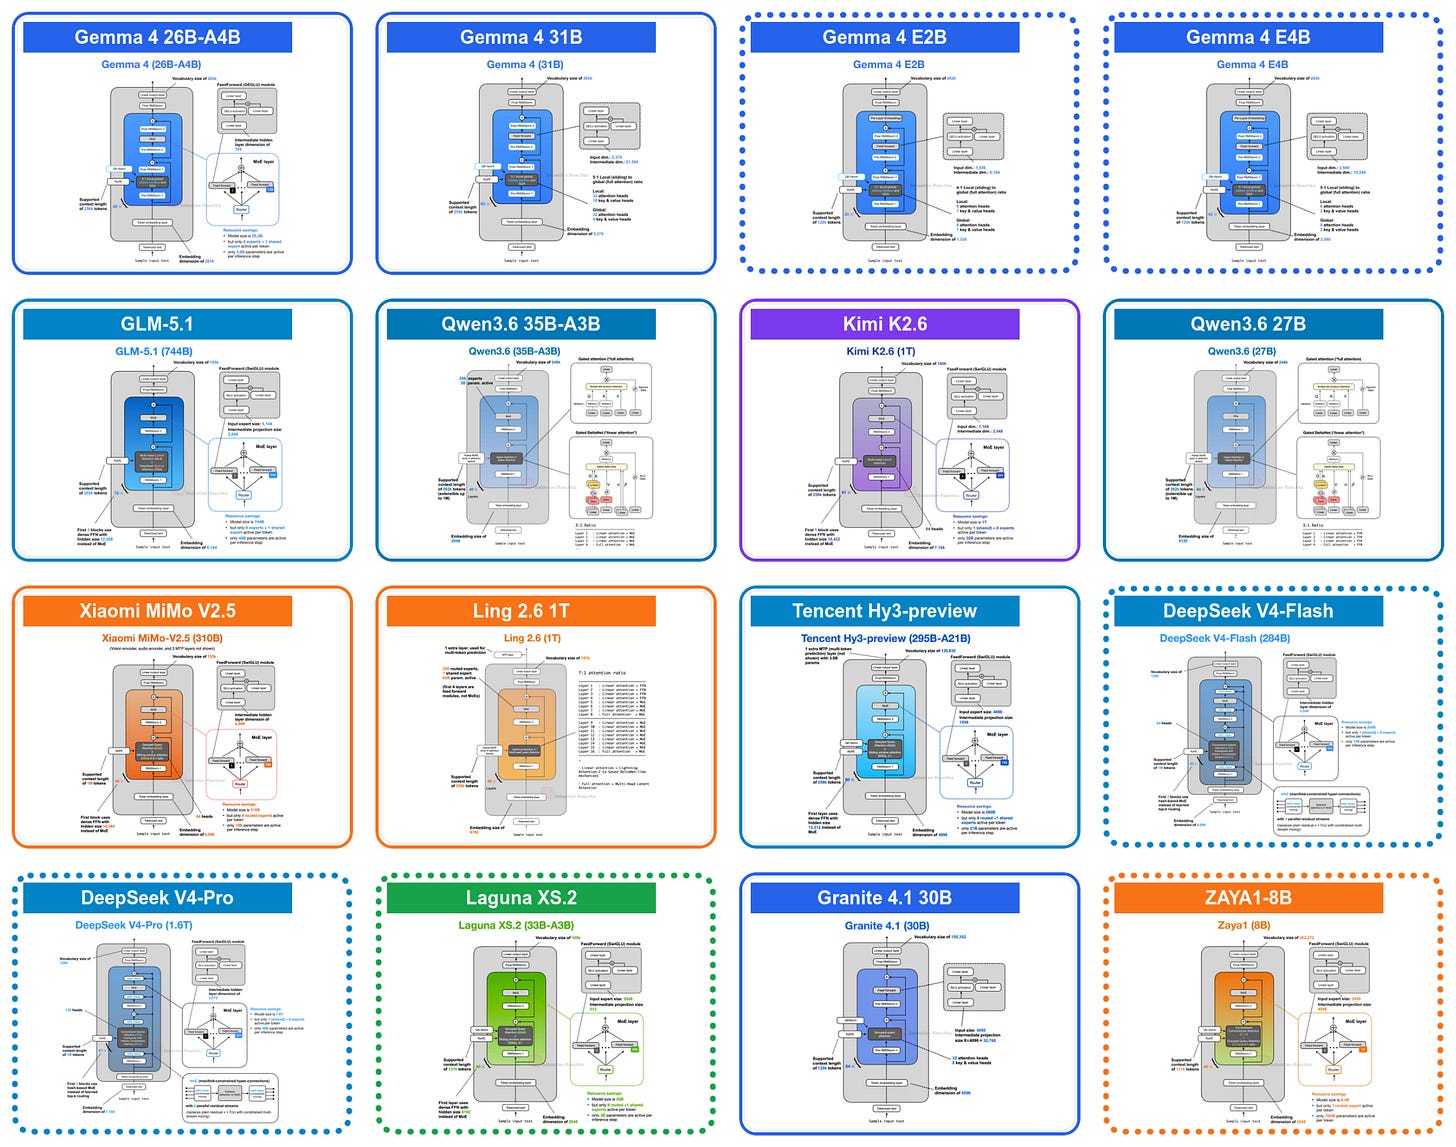
本文聚焦四项代表性设计:Gemma 4的KV跨层共享与逐层嵌入、Laguna XS.2的逐层注意力预算分配、ZAYA1-8B的压缩卷积注意力、DeepSeek V4的mHC与压缩注意力。这些改动在架构图上往往只占几行差异,但内部设计相当精巧。
一、KV跨层共享:用复用换缓存空间
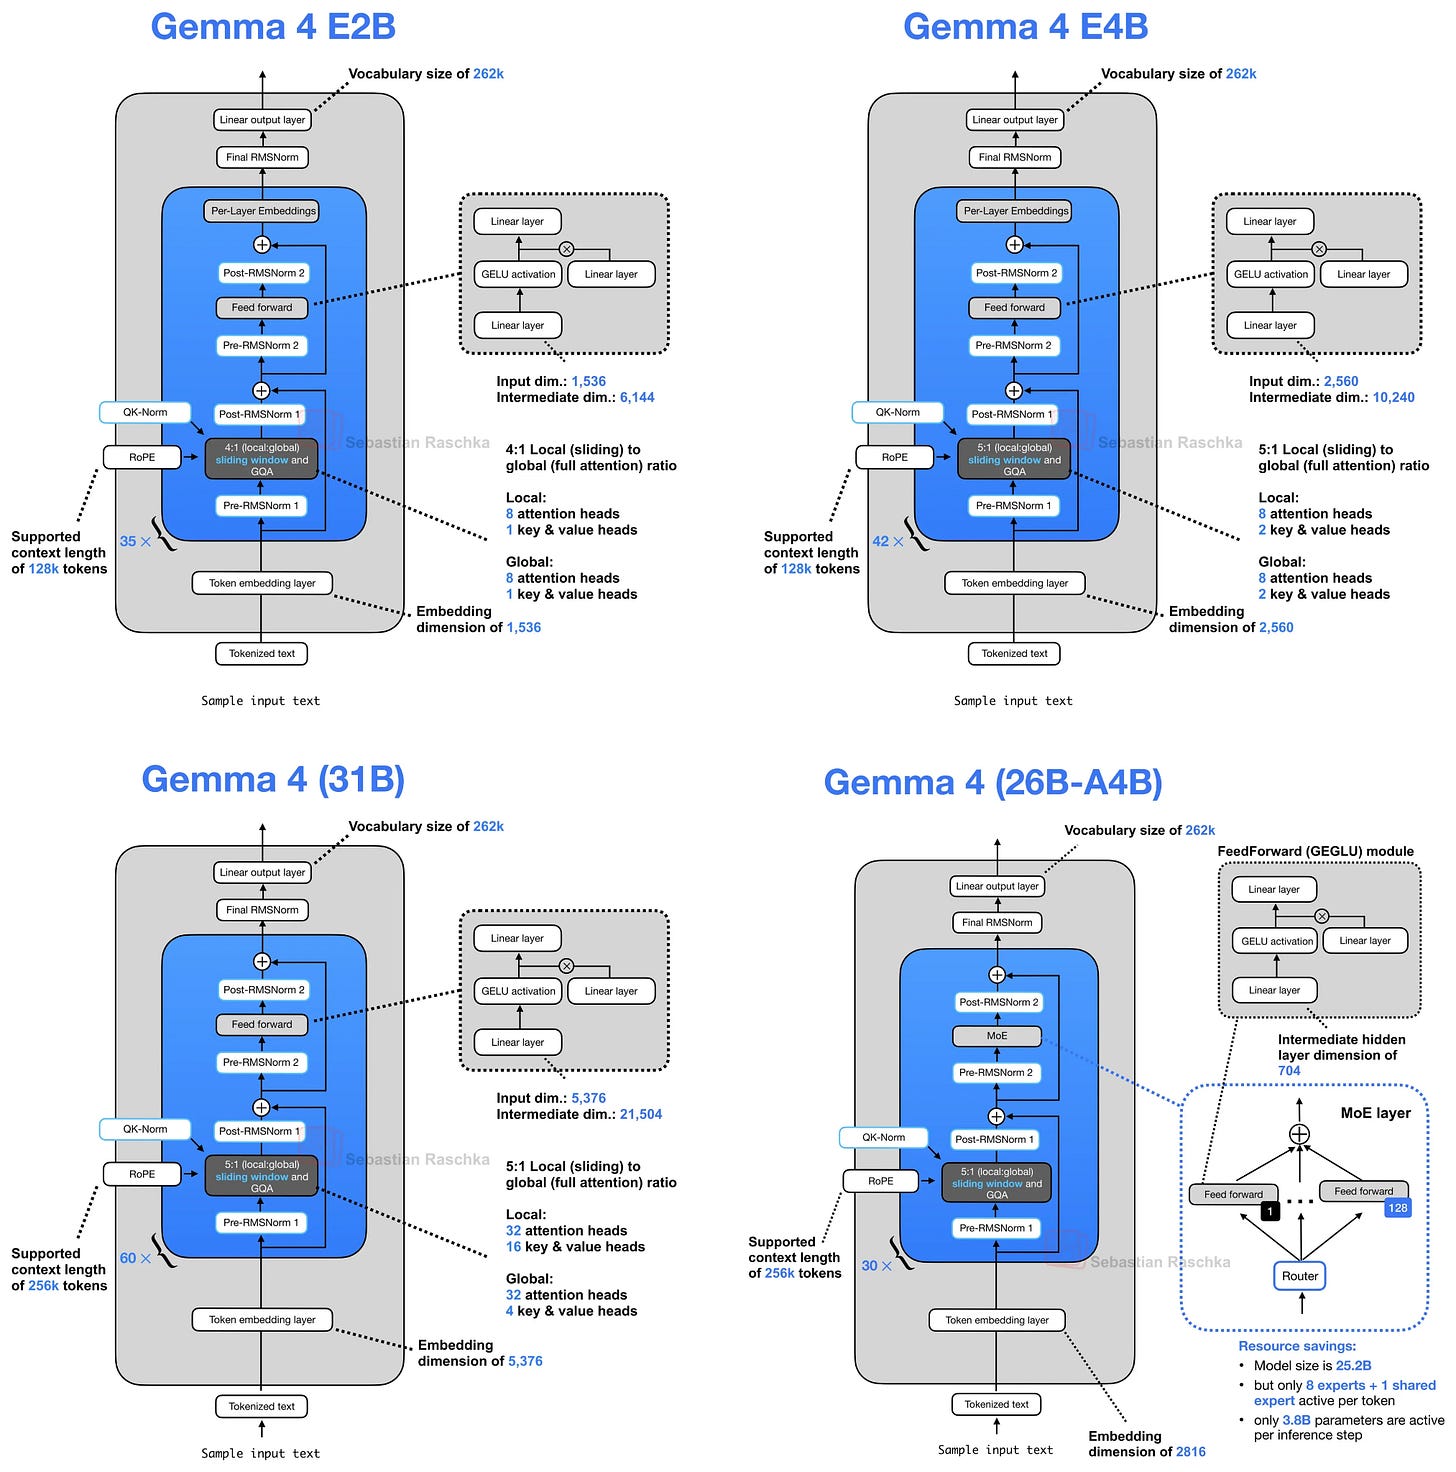
Gemma 4系列包含三个产品线:面向移动和嵌入式设备的E2B/E4B小模型、面向本地高效推理的26B MoE模型,以及31B稠密模型。其中一项关键设计是KV张量跨层复用——相邻或特定层之间共享同一份KV缓存,而非每层独立存储。
为什么这样做? 传统Transformer每层都维护自己的KV缓存,层数越多,缓存总量越大。在长上下文场景下(例如128K token),KV缓存可以占据数十GB显存,成为推理的内存瓶颈。跨层共享直接减少了需要存储的独立KV张量数量,从而线性降低显存占用。
Gemma 4还引入了逐层嵌入(per-layer embeddings),让不同层获得差异化的输入表示,配合KV共享策略在压缩缓存的同时尽量保留层间表达能力。
对开发者的价值: 如果你需要在消费级GPU或边缘设备上部署长上下文模型,KV共享类架构能显著降低显存门槛,值得在选型时重点关注。
二、逐层注意力预算分配:按需分配计算资源
Laguna XS.2提出了**逐层注意力预算分配(layer-wise attention budgeting)**的思路。核心思想是:并非每一层都需要处理完整的全量注意力,不同层可以根据语义需求分配不同的注意力计算预算。
传统做法中,每一层的注意力机制都计算所有token之间的两两关系,计算量随序列长度的平方增长。通过预算分配,某些层可以只关注局部窗口或稀疏子集,将计算资源集中到真正需要全局建模的层。
这种设计本质上是一种层级的计算稀疏化,与稀疏注意力、滑动窗口注意力等思路一脉相承,但粒度更细——不是全局统一策略,而是逐层自适应。
三、压缩卷积注意力:以卷积近似替代部分注意力
ZAYA1-8B采用了压缩卷积注意力(compressed convolutional attention),用卷积操作替代部分标准注意力计算。
注意力机制的长序列瓶颈在于O(n²)的复杂度。卷积操作天然具有局部性,计算复杂度与序列长度成线性关系。通过将部分注意力层替换为压缩卷积,ZAYA1在保持局部依赖建模能力的同时,大幅削减长序列的计算开销。
这种混合架构的思路在近年来的高效模型中越来越常见——不是完全抛弃注意力,而是在计算成本与表达能力之间寻找平衡点。
四、mHC与压缩注意力:DeepSeek V4的组合拳
DeepSeek V4同时采用了mHC(multi-head compression)和压缩注意力两项技术。mHC的核心是对多头注意力中的Key和Value进行跨头压缩,减少需要存储和传输的张量维度;压缩注意力则进一步降低注意力矩阵的计算和存储开销。
两项技术叠加后,DeepSeek V4在不显著牺牲模型能力的前提下,大幅压缩了长上下文推理的显存和计算需求。对于需要在有限硬件上运行大参数模型的团队来说,这是一个值得深入研究的架构方向。
总结:长上下文优化的架构趋势
| 技术 | 核心思路 | 主要收益 |
|---|---|---|
| KV跨层共享(Gemma 4) | 多层复用同一KV缓存 | 线性降低显存占用 |
| 逐层注意力预算(Laguna XS.2) | 按需分配各层注意力计算量 | 减少不必要的全局注意力 |
| 压缩卷积注意力(ZAYA1) | 卷积替代部分注意力 | 线性复杂度替代平方复杂度 |
| mHC+压缩注意力(DeepSeek V4) | 跨头压缩+注意力压缩 | 同时降低存储与计算成本 |
共同趋势: 这些设计都在做同一件事——在Transformer的注意力计算和KV缓存中引入结构化的压缩与复用,从而在长上下文场景下实现"同样的模型能力,更低的硬件成本"。
对于开发者和AI应用构建者而言,理解这些架构差异有助于:
- 模型选型: 根据部署场景(边缘设备 vs. 数据中心)选择合适架构
- 推理优化: 识别模型中可进一步压缩的环节
- 自研架构: 将KV共享、注意力预算等技巧组合到自己的模型中
长上下文能力不再是"堆参数"的简单问题,架构效率正在成为开源大模型竞争的新前沿。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:Recent Developments in LLM Architectures: KV Sharing, mHC, and Compressed Attention
阅读原文