ECS 自动修复 GPU 故障:SRE 运维减负新能力
AWS ECS 新增自动修复功能,可检测并替换 GPU 硬件故障实例,大幅降低 SRE 手动干预频率,对 ML 推理和训练工作负载尤为关键。
ECS 自动修复:从被动响应到主动自愈
AWS Elastic Container Service(ECS)近期推出了一项重要更新——**自动修复(Auto-Repair)**能力。该功能能够自动检测实例级别的故障(包括 GPU 硬件异常),并在无需人工介入的情况下替换有问题的实例,恢复服务可用性。
对于运行 GPU 密集型工作负载(如模型推理、训练任务)的团队来说,这项能力直接切中了运维痛点。
为什么 GPU 故障对 SRE 特别棘手
GPU 实例的故障模式与普通 CPU 实例有本质区别:
- 检测难度大:GPU 可能出现部分计算核心失效、显存 ECC 错误、NVLink 通信异常等问题,传统健康检查往往无法覆盖
- 恢复成本高:GPU 实例通常对应昂贵的实例类型(如 P4d、P5 系列),手动排查和替换流程耗时
- 影响面广:一个 GPU 节点故障可能导致整个训练任务中断或推理服务降级
过去,SRE 团队需要依赖 CloudWatch 告警 + 手动判断 + 手动替换的链路,响应时间通常在分钟到小时级别。
自动修复的工作机制
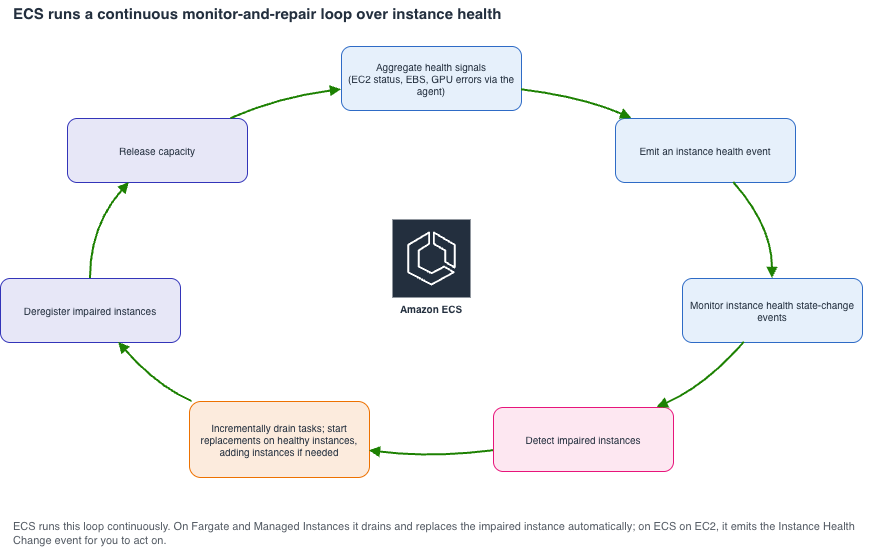
ECS 自动修复的核心逻辑是:
- 持续健康监控:ECS 在实例层面执行扩展的健康检查,涵盖 GPU 设备状态
- 故障判定:当检测到 GPU 硬件故障或实例不可用等条件时,标记实例为不健康
- 自动替换:系统自动终止故障实例,并从任务定义中重新调度容器到新实例上
- 容量管理:配合 Auto Scaling 或 Capacity Provider,确保替换后集群容量不下降
整个过程对用户透明,任务编排层自动完成容错切换。
对 SRE 和开发者的实际价值
减少告警疲劳:自动修复在告警触发前或同时完成修复,减少无效告警和手动操作。
缩短 MTTR:从故障发生到服务恢复的时间大幅压缩,尤其对长时间训练任务意义重大。
简化 on-call 流程:SRE 不再需要为 GPU 硬件故障编写复杂的 runbook,自动修复承担了大部分恢复动作。
提升资源利用率:故障实例被及时替换,避免"僵尸节点"占用配额和预算。
使用建议
- 启用条件:在 ECS 服务或任务定义中配置 auto-repair 策略,明确哪些故障类型触发自动替换
- 配合监控:虽然修复是自动的,但仍建议保留 CloudWatch 指标和告警,用于事后分析和容量规划
- 容量预留:自动替换需要可用容量,建议配合 Spot 或按需实例的混合策略,确保替换时不会因容量不足而失败
- 测试验证:在生产环境启用前,先在测试集群中模拟 GPU 故障场景,验证修复流程和业务影响
总结
ECS 自动修复将基础设施层的容错能力下沉到编排平台,让 SRE 团队可以从"手动救火"转向"策略配置 + 效果验证"的工作模式。对于重度使用 GPU 实例的团队,这是降低运维复杂度和提升系统弹性的关键一步。
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Amazon ECS now auto-repairs failing GPUs and instances. Here’s why it matters for SREs.
阅读原文