DeepSeek V3到V3.2:稀疏注意力与RL架构演进
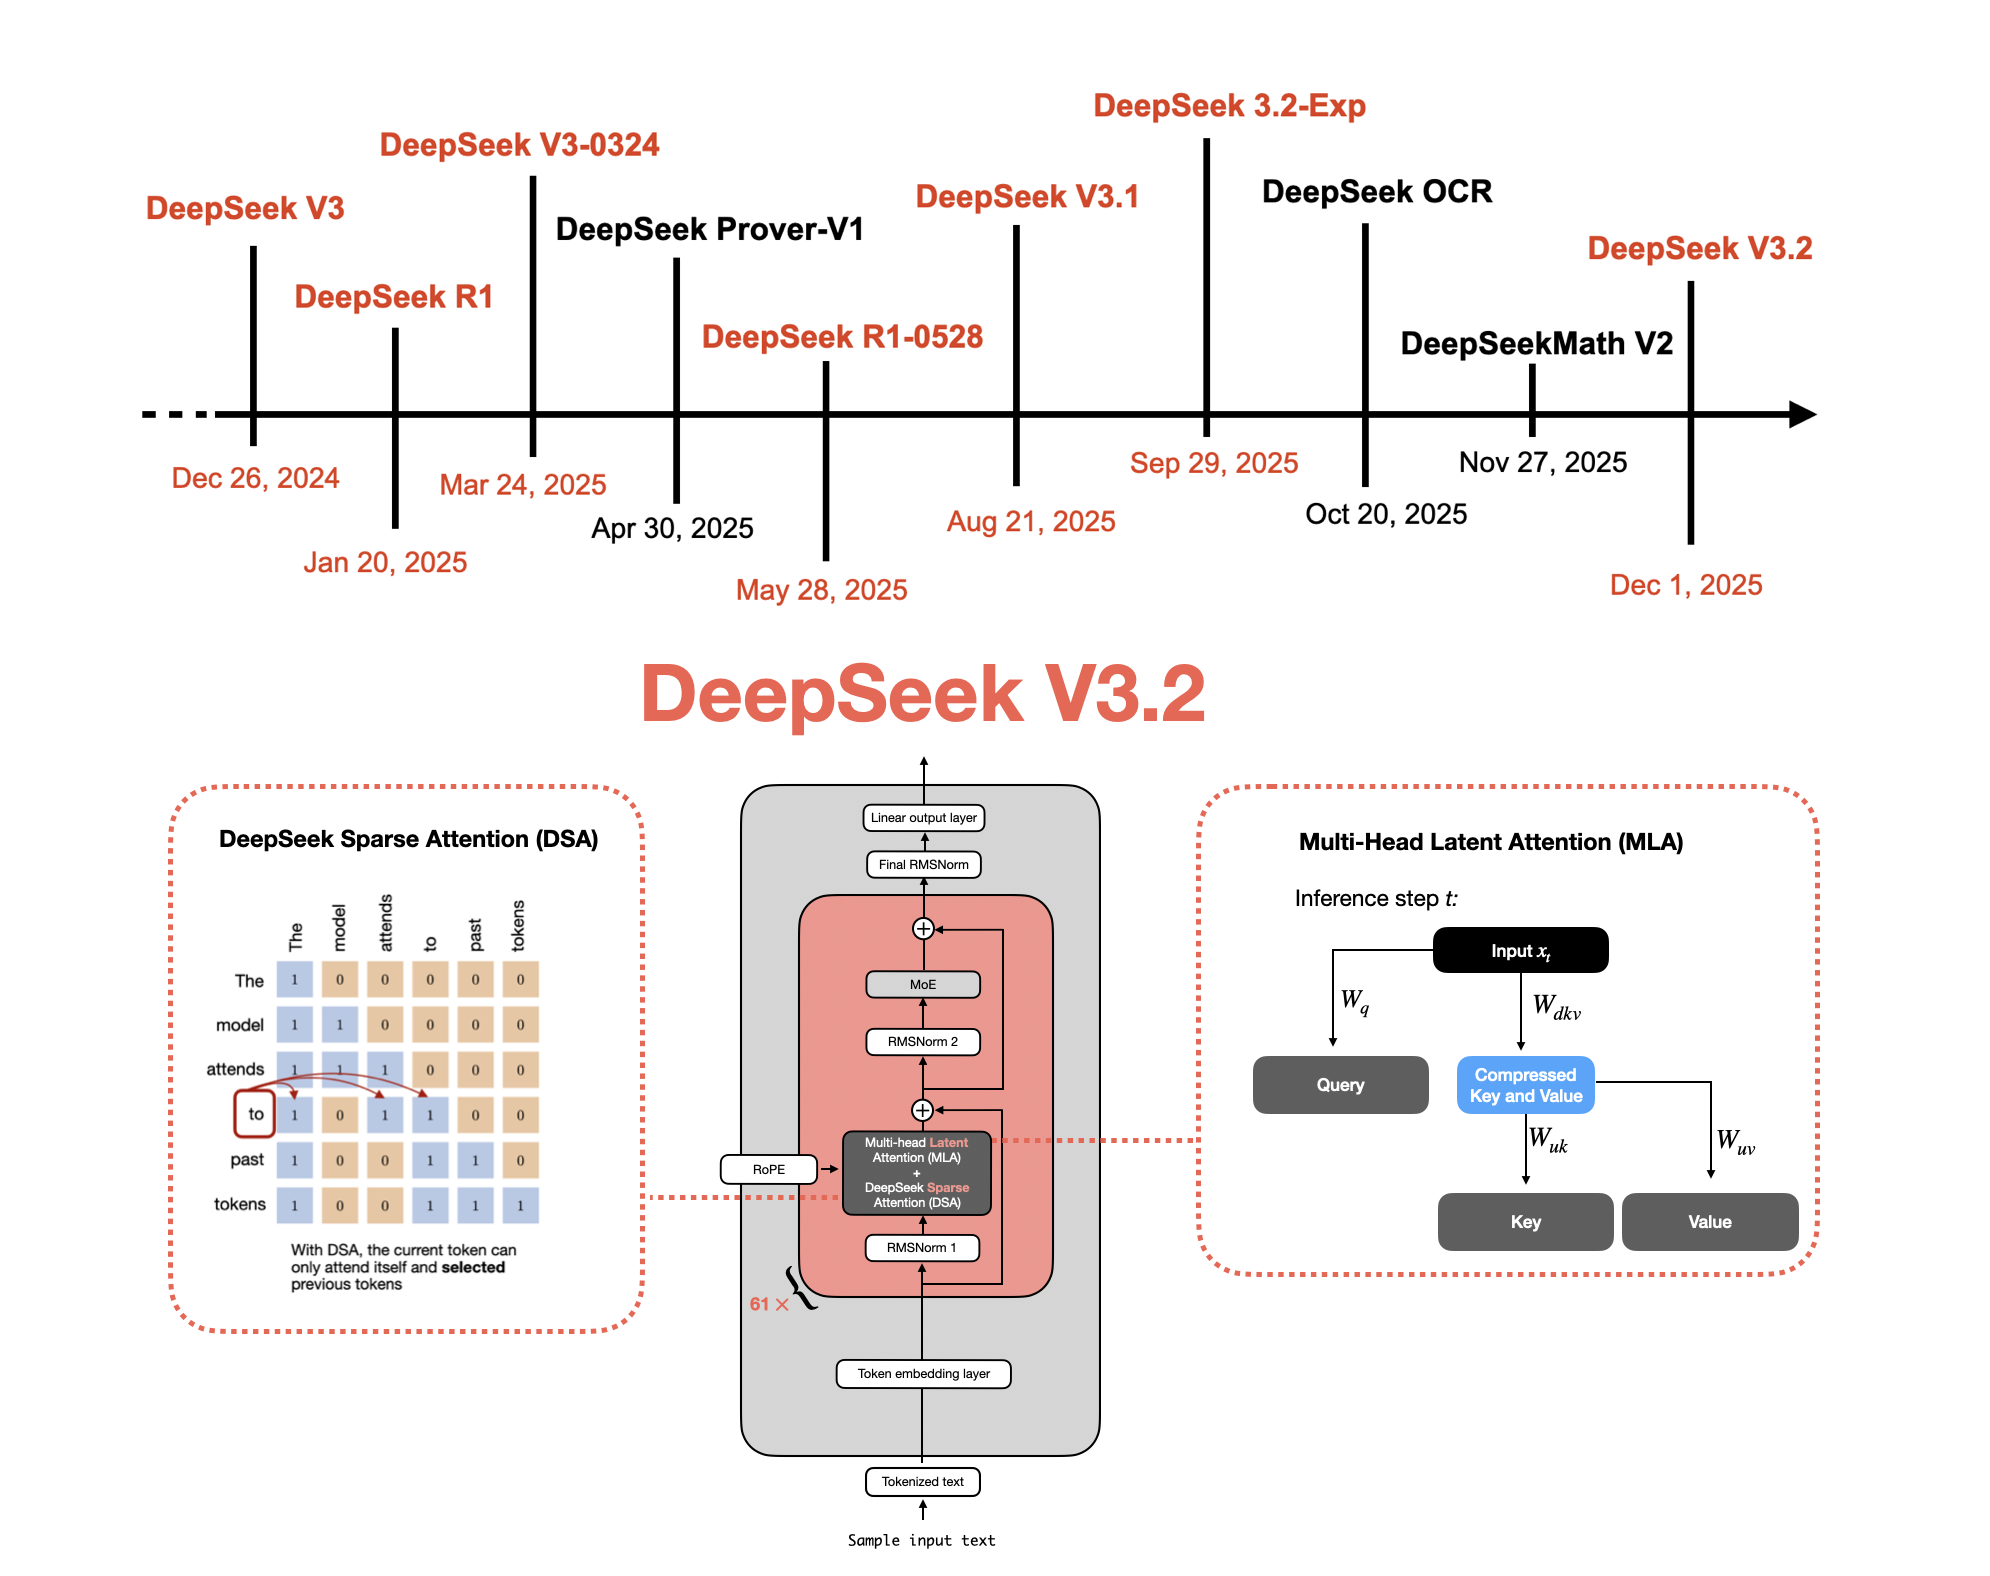
深度解析DeepSeek从V3到V3.2的架构升级路径,涵盖稀疏注意力机制、推理模型训练流程与开源生态建设,为开发者提供实用参考。
从 V3 到 V3.2:一次值得关注的架构跃迁
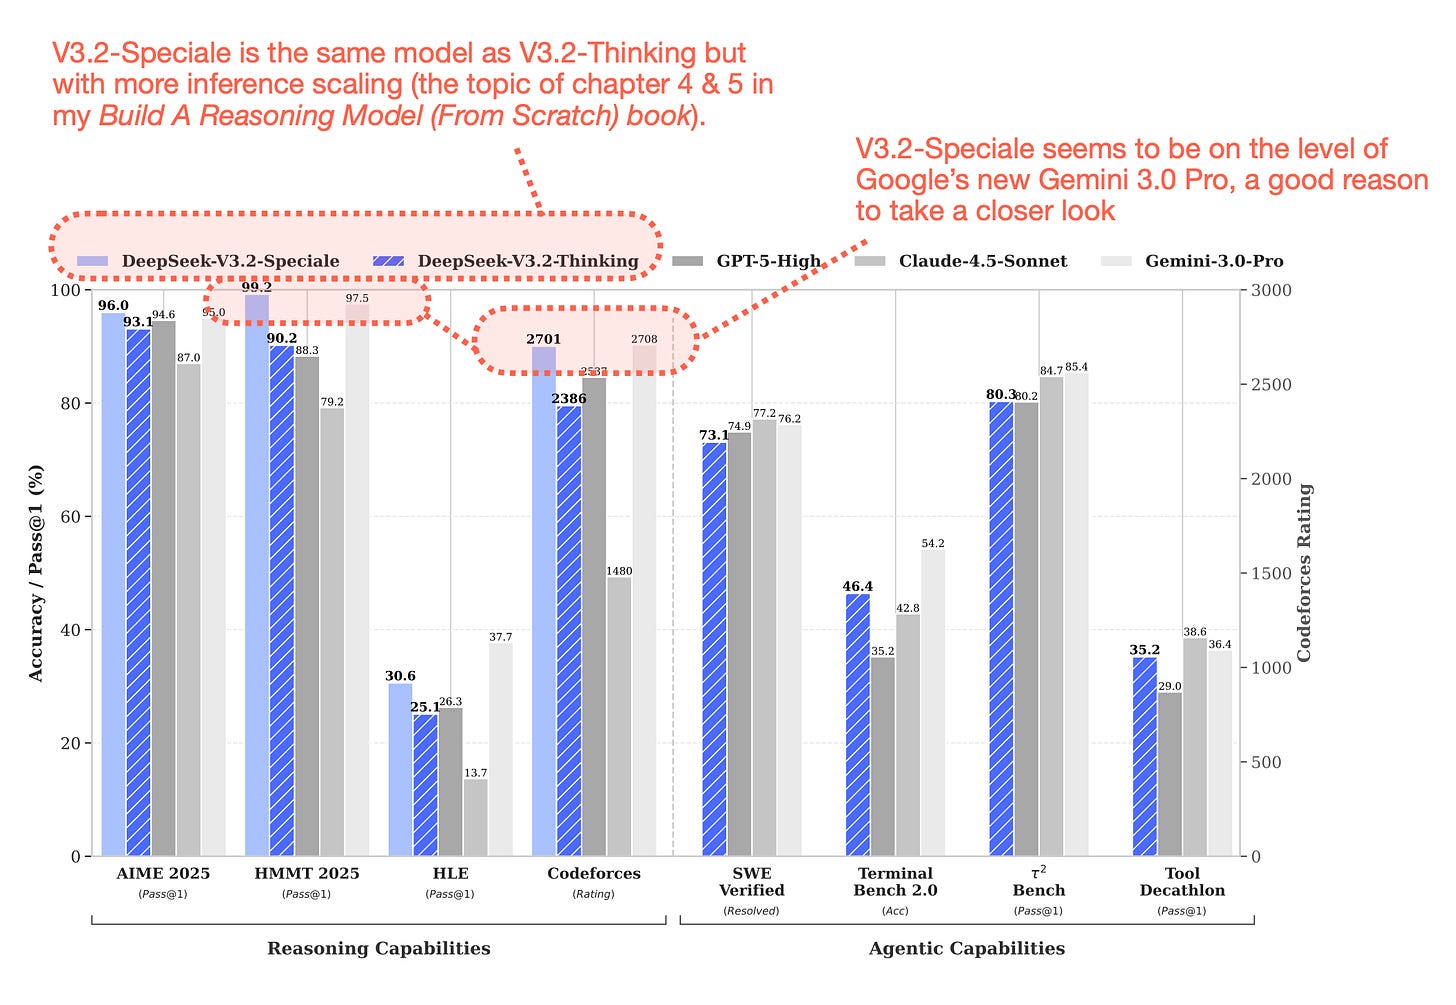
DeepSeek V3.2 的发布方式与 V3 如出一辙——选在美国重大节假日周末上线,低调却实力不俗。根据技术报告,V3.2 的性能已可对标 GPT-5 和 Gemini 3.0 Pro 级别,同时保持开放权重(open-weight)策略,对开发者和研究者来说极具吸引力。
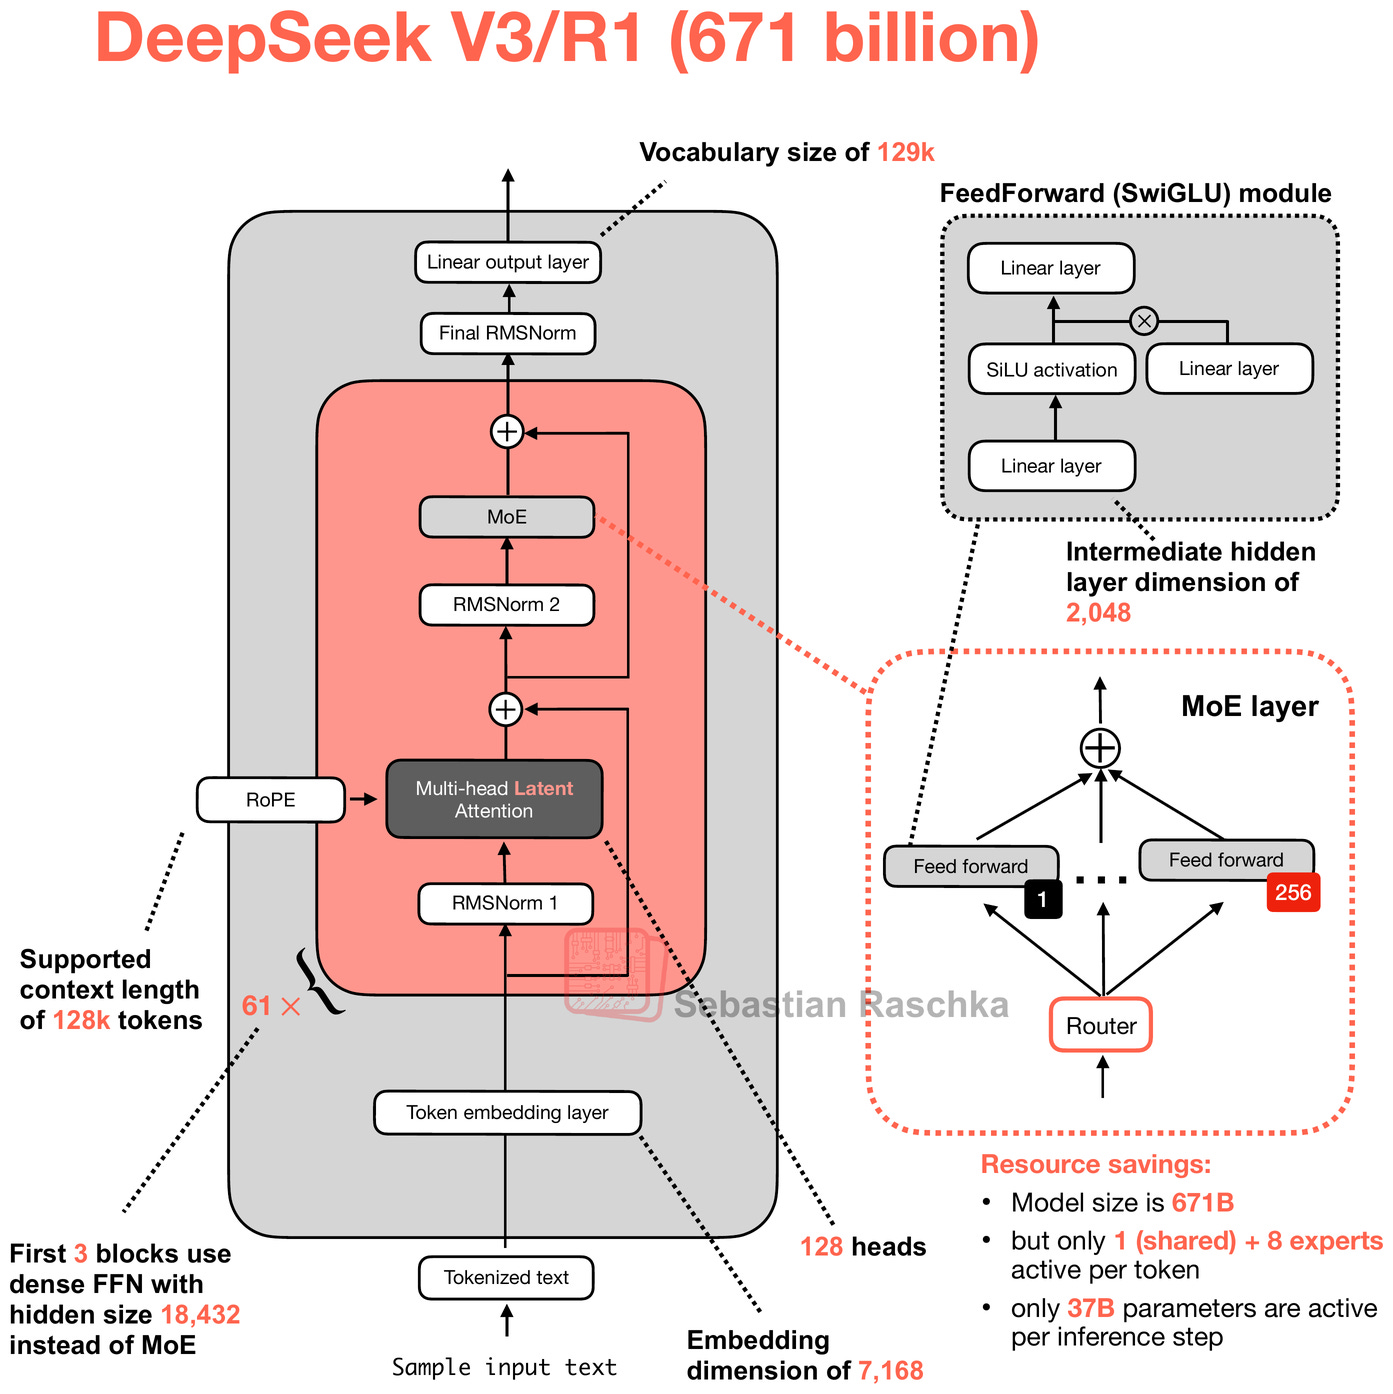
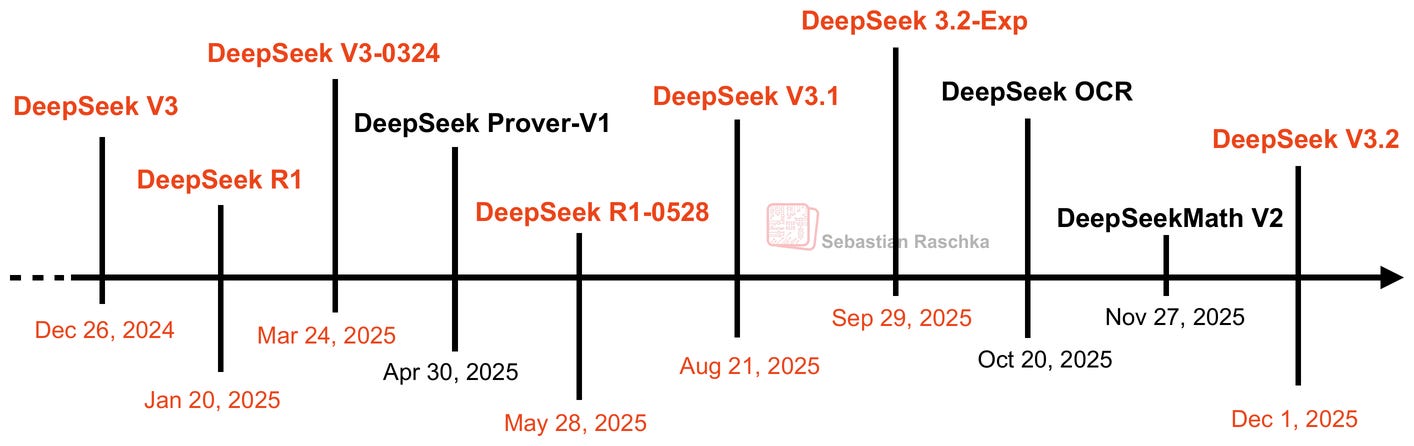
回顾 DeepSeek 的发布节奏:V3 于 2024 年 12 月发布时并未立即引爆热度,真正让它出圈的是随后推出的 DeepSeek R1 推理模型——基于与 V3 完全相同的架构,通过额外后训练发展出专用推理能力,一举成为 OpenAI、Google、Anthropic 等闭源模型的有力替代方案。
此后近 10-11 个月没有重大版本更新,社交媒体上甚至有人断言 DeepSeek 团队已经"凉了"。实际上团队一直在忙碌,期间还经历了 NVIDIA 到华为芯片的切换,目前已回归 NVIDIA 平台。期间也陆续推出了 V3.1 和 V3.2-Exp 等小版本迭代。
V3.2-Exp:为正式版本铺路的"预演"
V3.2-Exp 的发布并非偶然。它的核心目的之一是提前让生态系统和推理基础设施做好准备,以便正式版的 V3.2 发布时能顺利部署。
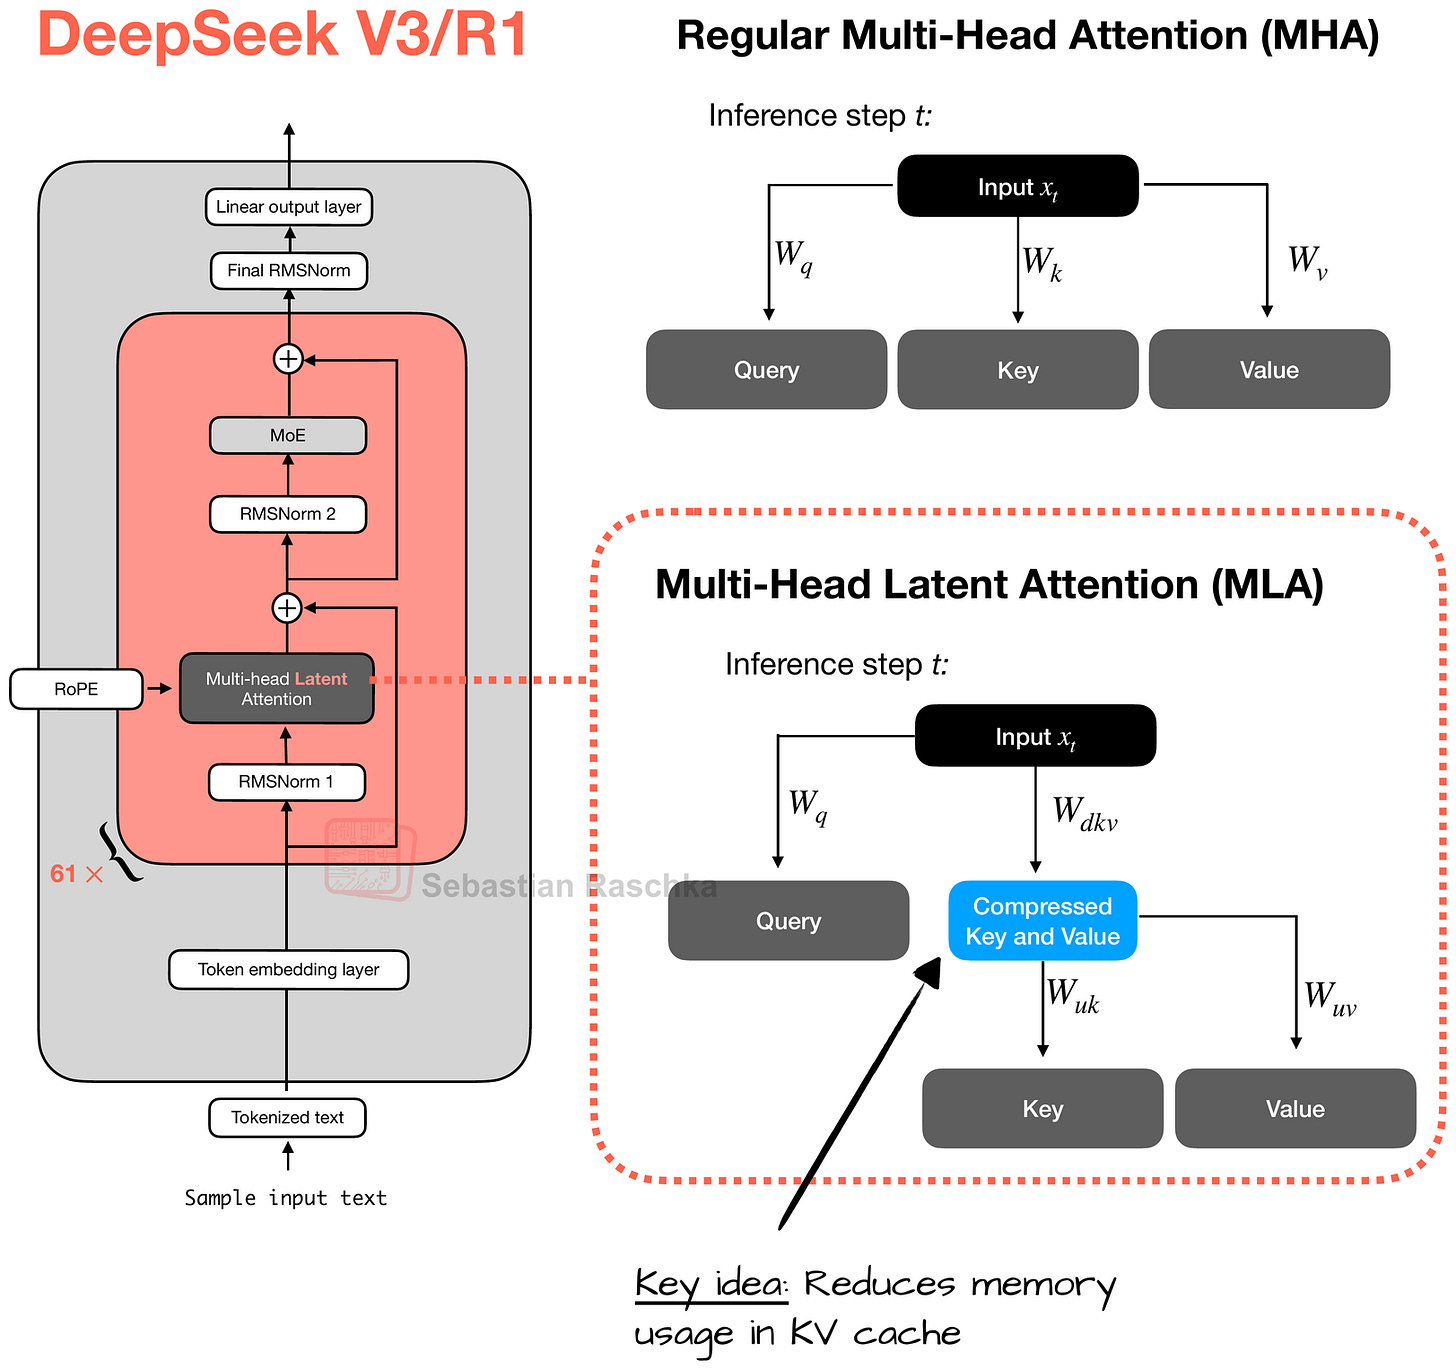
一个关键细节是:V3.2-Exp 和 V3.2 都采用了非标准的稀疏注意力变体,这意味着推理时需要自定义代码支持,而非直接使用现有框架的标准实现。对于计划部署 V3.2 的开发者来说,这是一个需要提前关注的工程门槛。
基座模型 vs 专用推理模型:两条路径的选择
理解 DeepSeek 的产品矩阵,需要区分两个核心概念:
- DeepSeek V3:基座模型(base model),提供通用语言能力
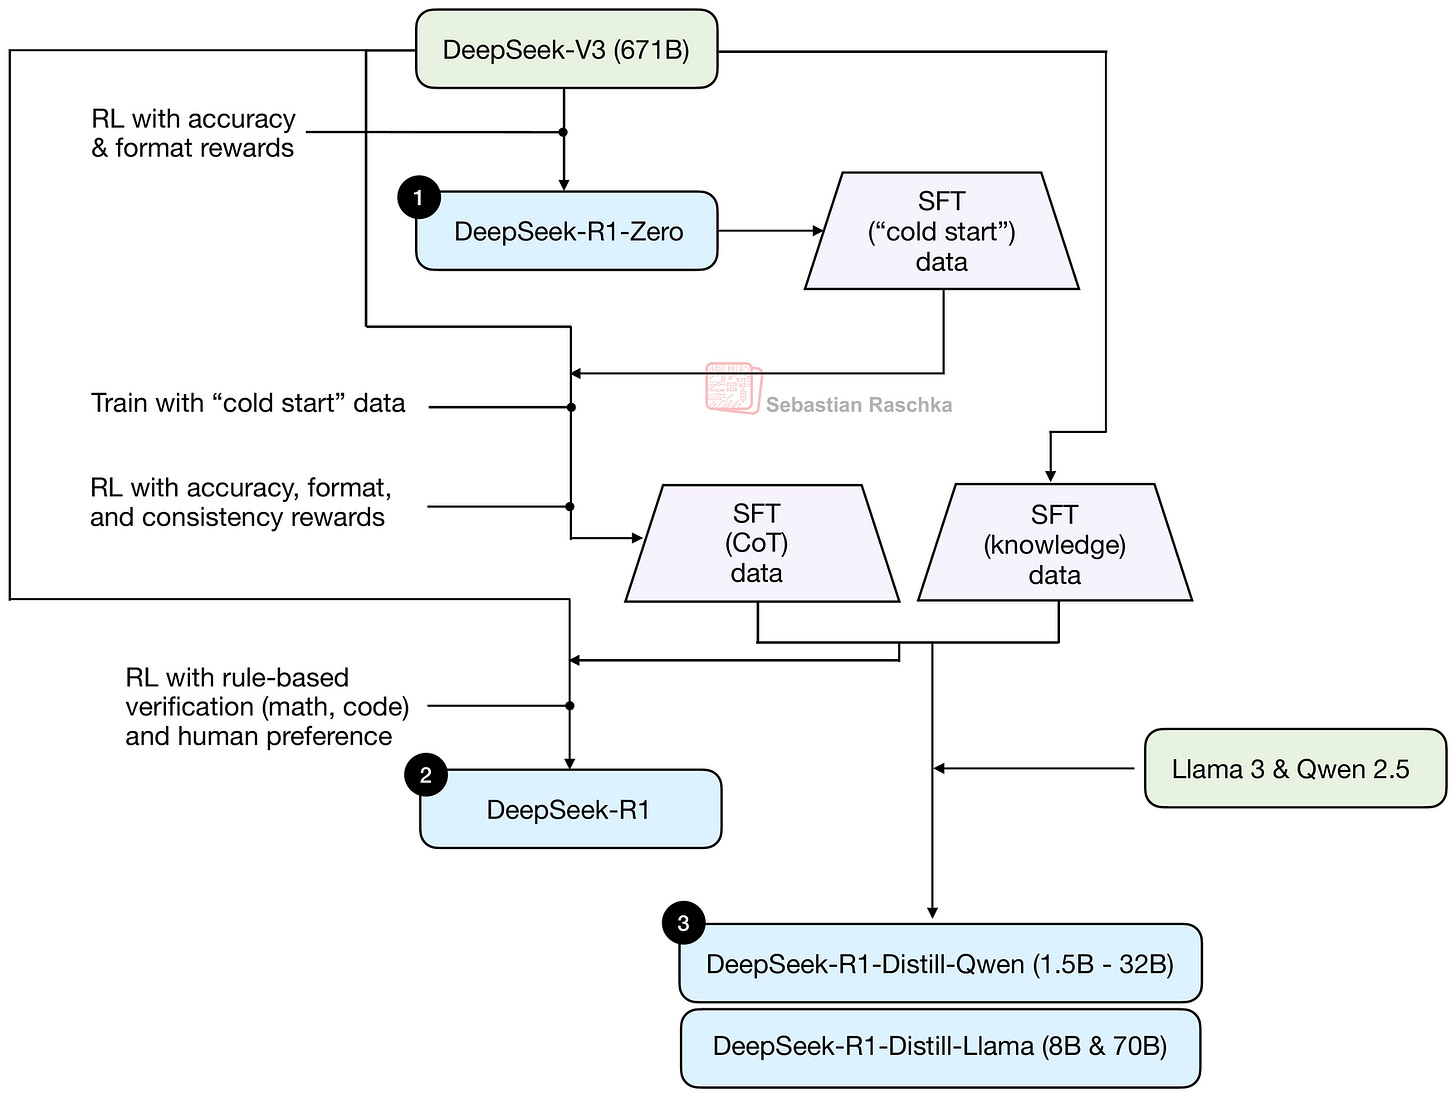
- DeepSeek R1:专用推理模型(dedicated reasoning model),在 V3 基础上通过额外后训练强化推理能力
R1 的训练流程大致分为几个阶段:先对基座模型进行强化学习(RL)训练,再经过监督微调(SFT)和拒绝采样等步骤,最终形成一个擅长复杂推理任务的专用模型。
对开发者的实用建议:如果你的应用场景侧重于数学、代码、逻辑推理等任务,R1 系列是更优选择;如果是通用对话、文本生成等场景,V3 基座模型更合适。选择哪条路径,取决于你的具体需求。
开源推理模型生态的格局
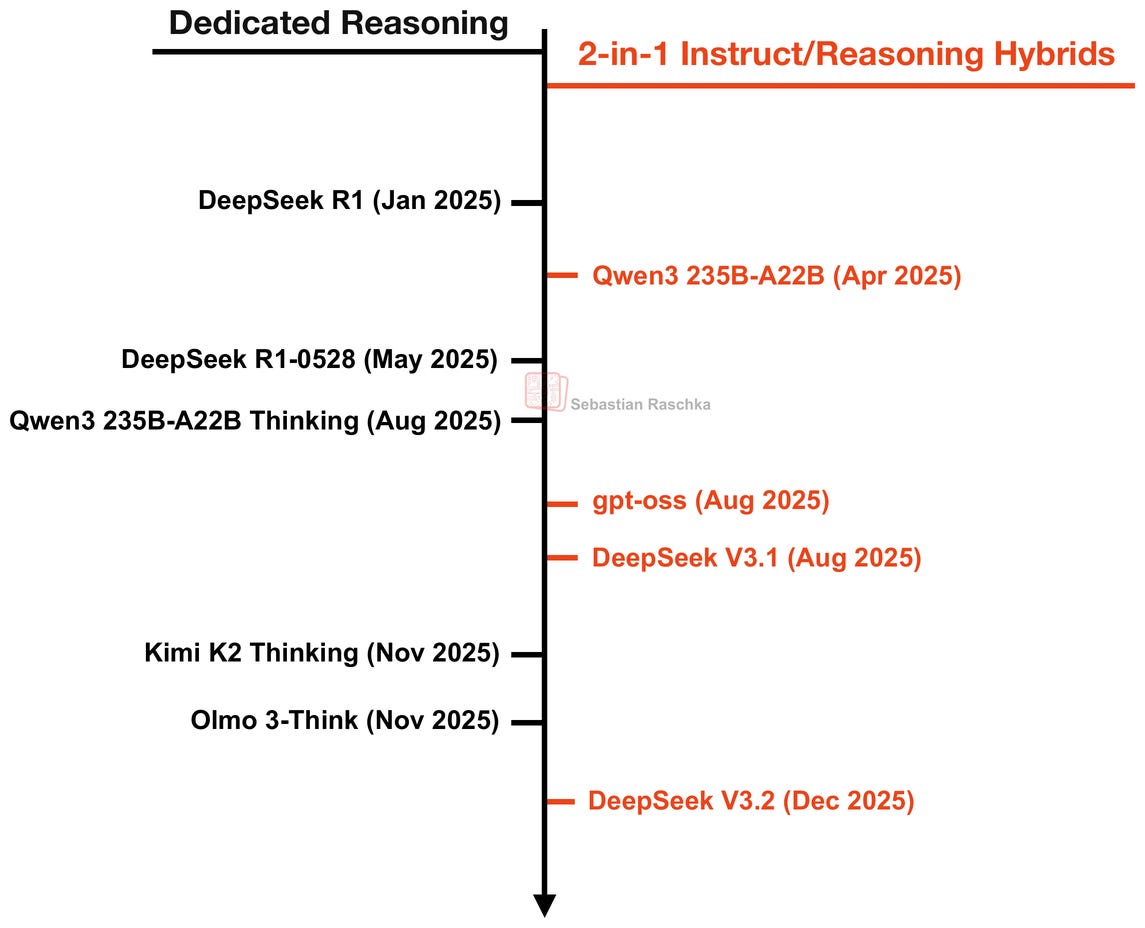
DeepSeek 并非唯一在推理模型领域发力的大厂。同期还有多个团队推出了强有力的开源推理模型,整个开源推理模型生态正在快速成熟。V3.2 的加入进一步加剧了这一赛道的竞争,也为用户提供了更多选择。
对谁有价值? 对于正在评估开源大模型选型、寻找闭源模型替代方案的团队,DeepSeek V3.2 的开放权重策略和接近闭源旗舰的性能表现,使其成为一个值得纳入技术评估清单的重要选项。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:From DeepSeek V3 to V3.2: Architecture, Sparse Attention, and RL Updates
阅读原文