2026 年初开放权重 LLM 架构全景梳理
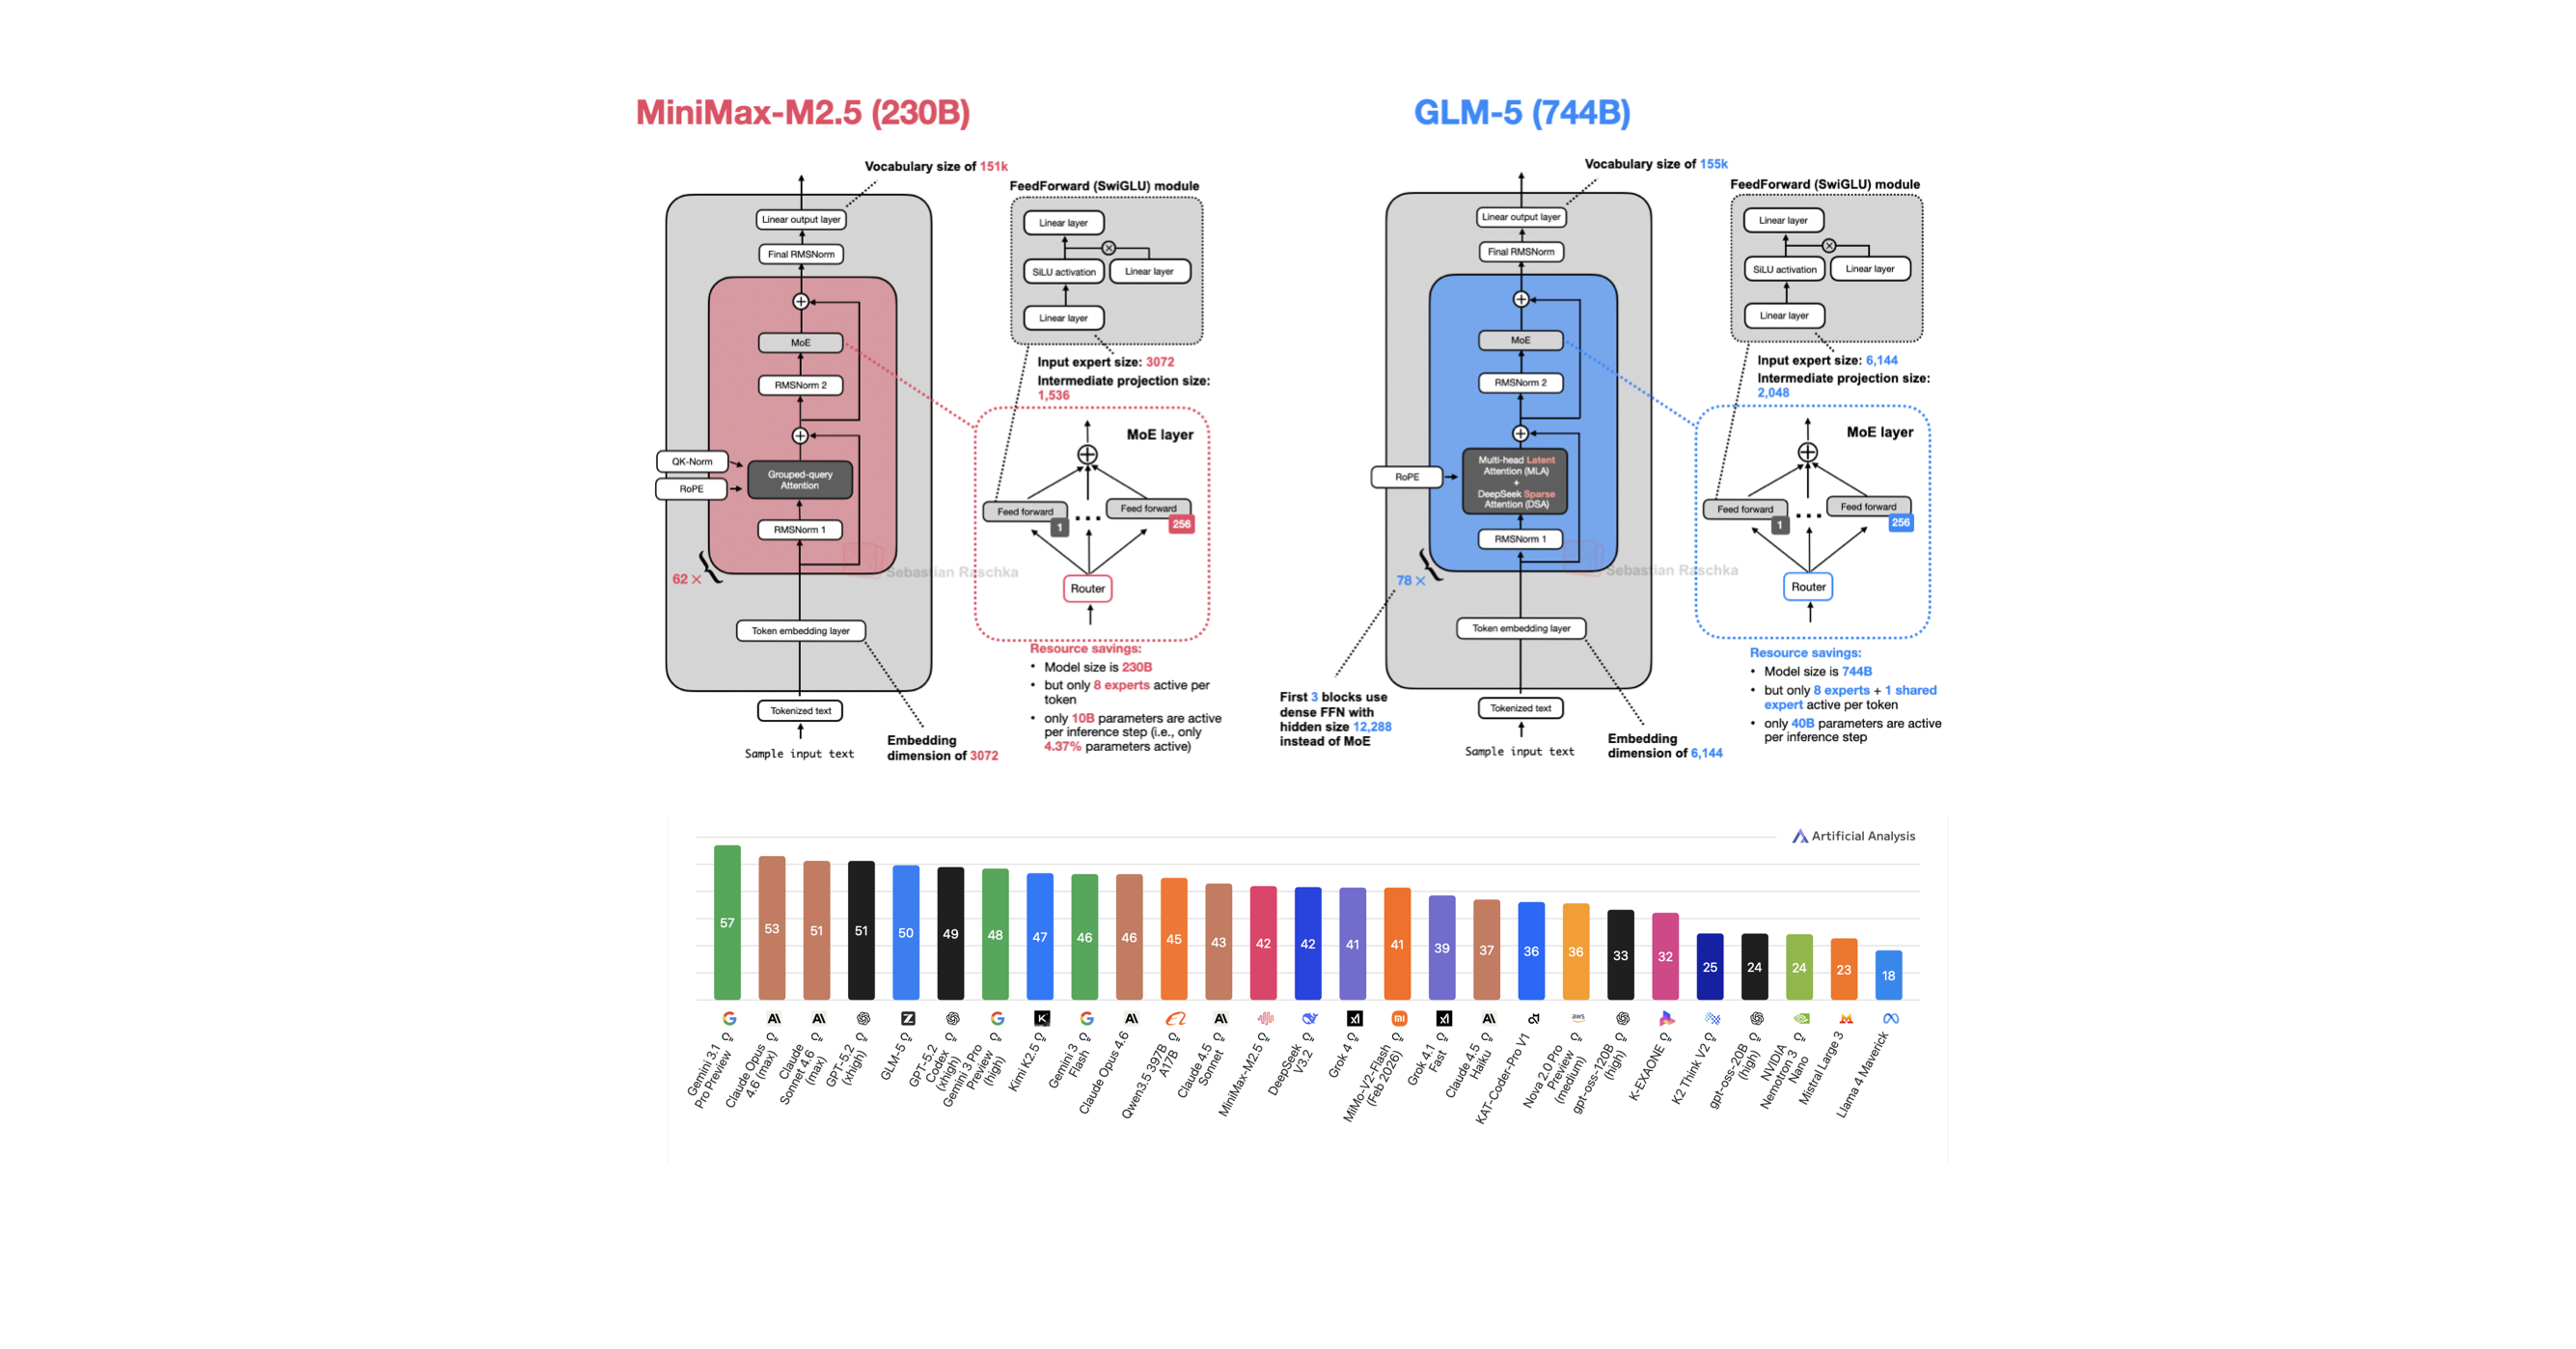
2026 年 1-2 月密集发布了十余款开放权重大模型,本文梳理其架构共性趋势:MoE 成为标配、滑动窗口注意力走向主流、门控机制与 QK-Norm 提升训练稳定性,帮助开发者快速把握选型方向。
开放权重模型的"春季井喷"
2026 年 1 月至 2 月,开放权重 LLM 的发布节奏明显加快。从 Arcee AI 的 Trinity Large 到 Cohere 的 Tiny Aya,短短不到两个月内涌现了十余款值得关注的模型。对于开发者和 AI 从业者而言,快速理解这些模型之间的架构差异,是做出正确选型的前提。
以下是本期覆盖的主要模型(按发布时间排列):
- Arcee AI Trinity Large(1 月 27 日)
- Moonshot AI Kimi K2.5(1 月 27 日)
- StepFun Step 3.5 Flash(2 月 1 日)
- Qwen3-Coder-Next(2 月 3 日)
- z.AI GLM-5(2 月 12 日)
- MiniMax M2.5(2 月 12 日)
- Nanbeige 4.1 3B(2 月 13 日)
- Qwen 3.5(2 月 15 日)
- 蚂蚁集团 Ling 2.5 1T & Ring 2.5 1T(2 月 16 日)
- Cohere Tiny Aya(2 月 17 日)
此外,Sarvam 30B 和 105B 也在 3 月 6 日加入,DeepSeek V4 发布后也将纳入对比。
架构趋势一:MoE 全面普及
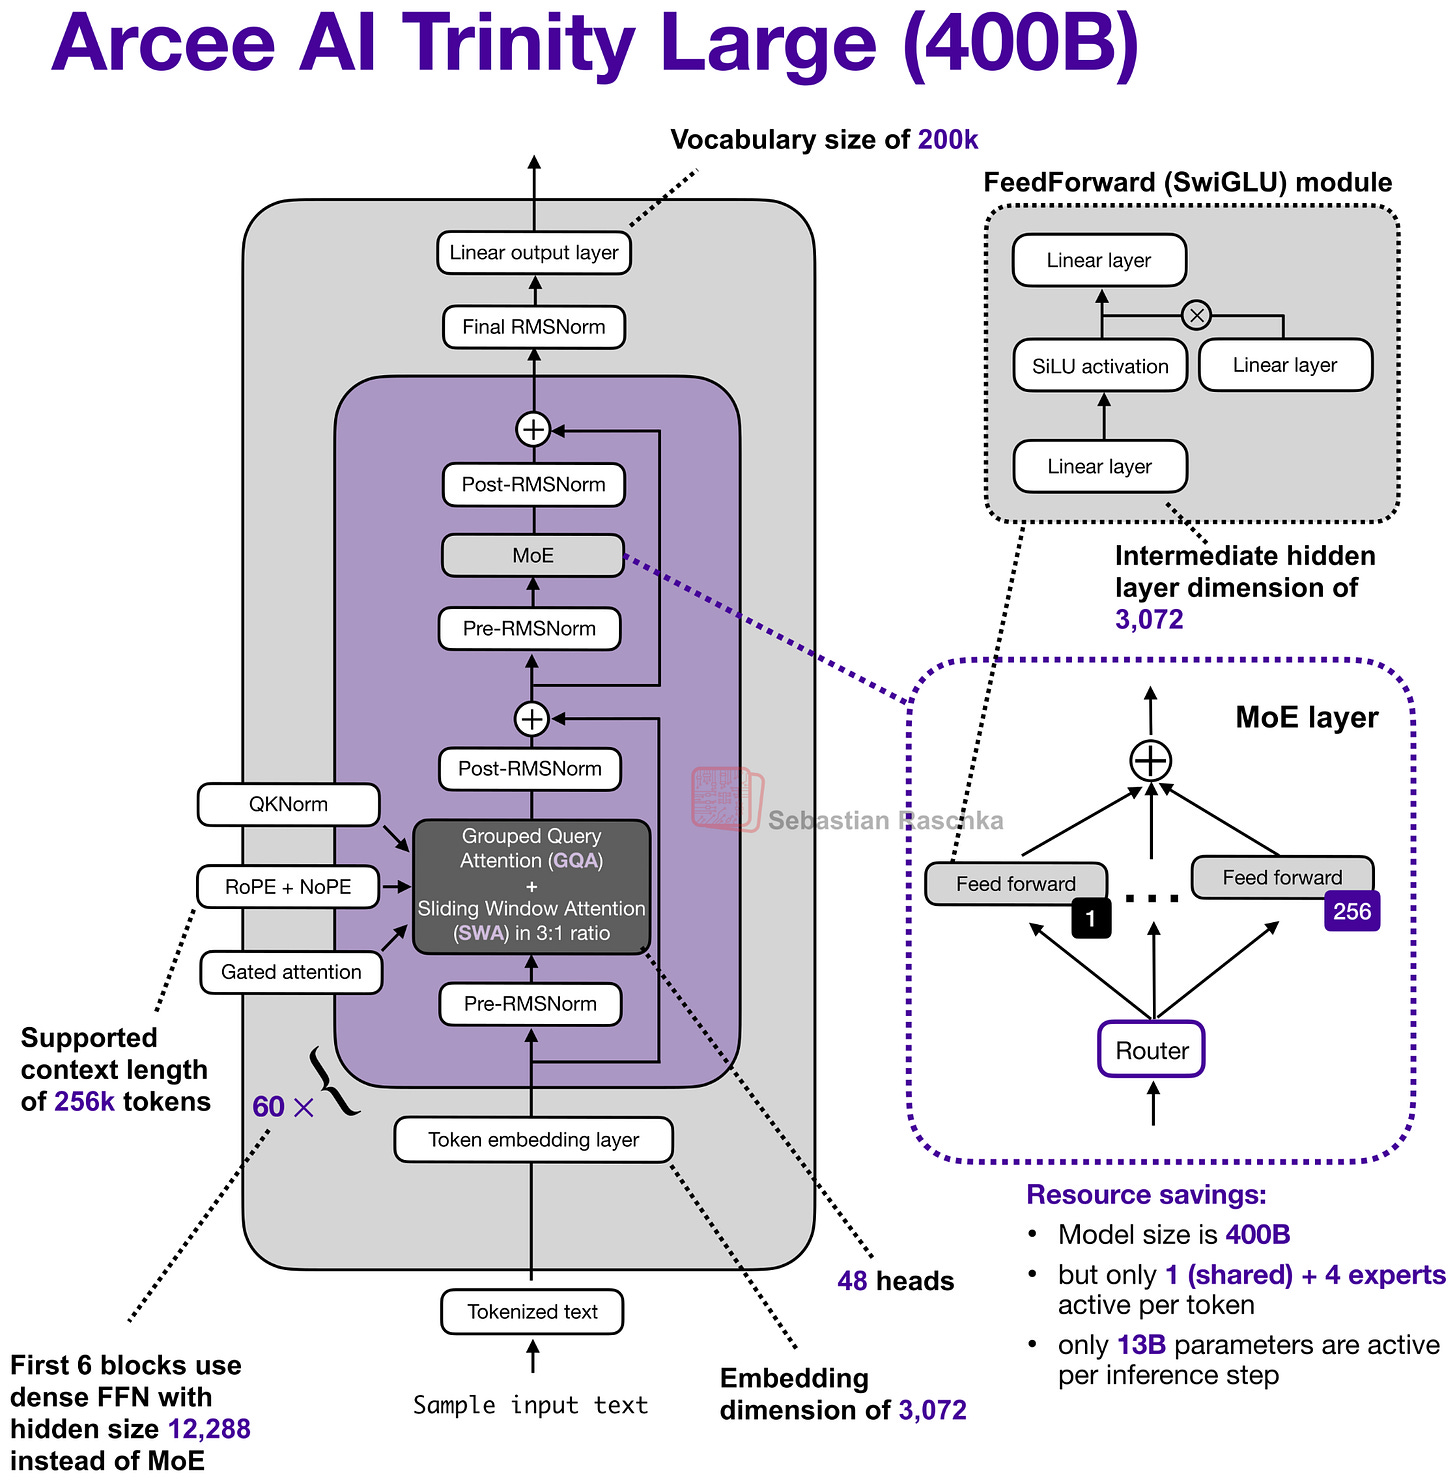
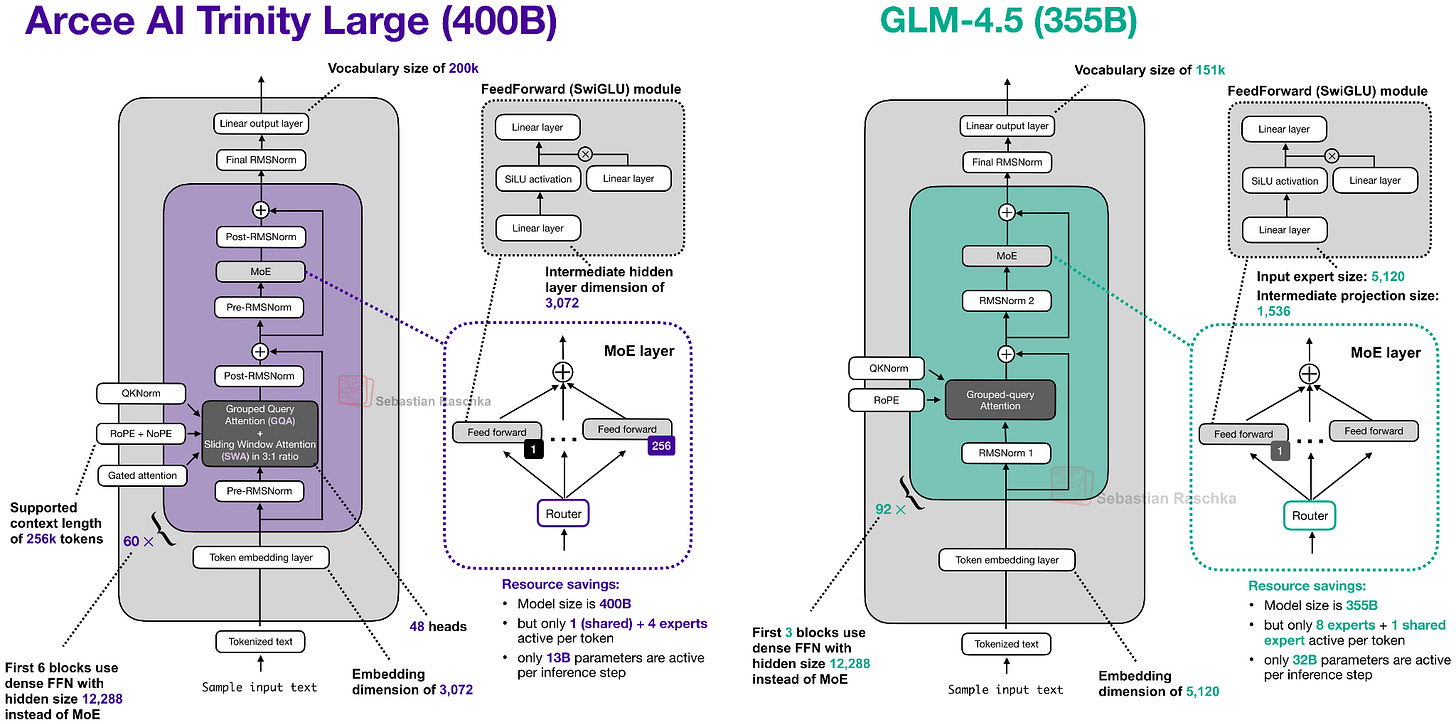
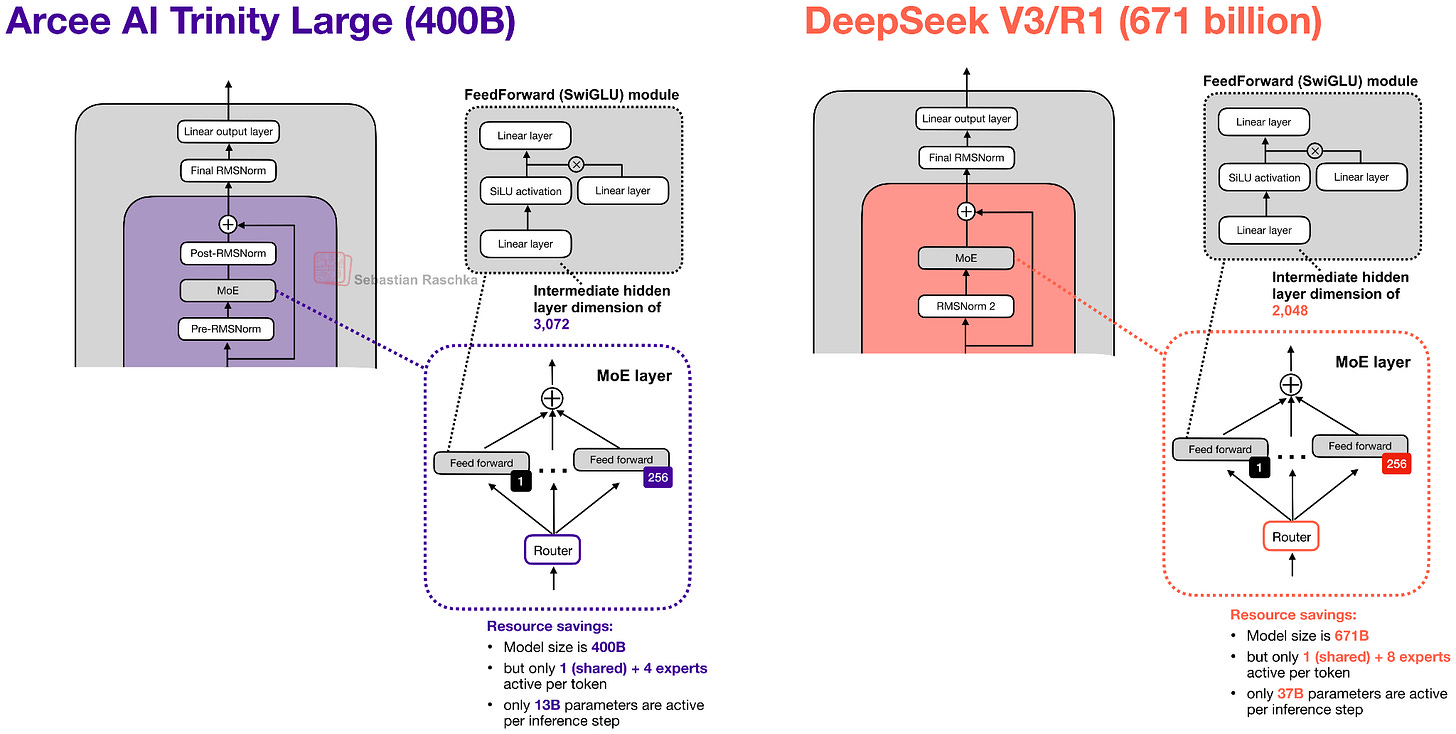
混合专家(Mixture-of-Experts)架构已成为开放权重大模型的标配。以 Trinity Large 为例,其旗舰版本拥有 400B 总参数,但每次推理仅激活 13B 参数,兼顾了模型容量与推理效率。同时发布的 Trinity Mini(26B 总参/3B 激活)和 Trinity Nano(6B 总参/1B 激活)进一步降低了使用门槛。
实用建议:如果你需要部署大参数模型但算力有限,优先关注 MoE 架构——激活参数少意味着推理显存占用更低,更适合生产环境。
架构趋势二:滑动窗口注意力(SWA)走向主流
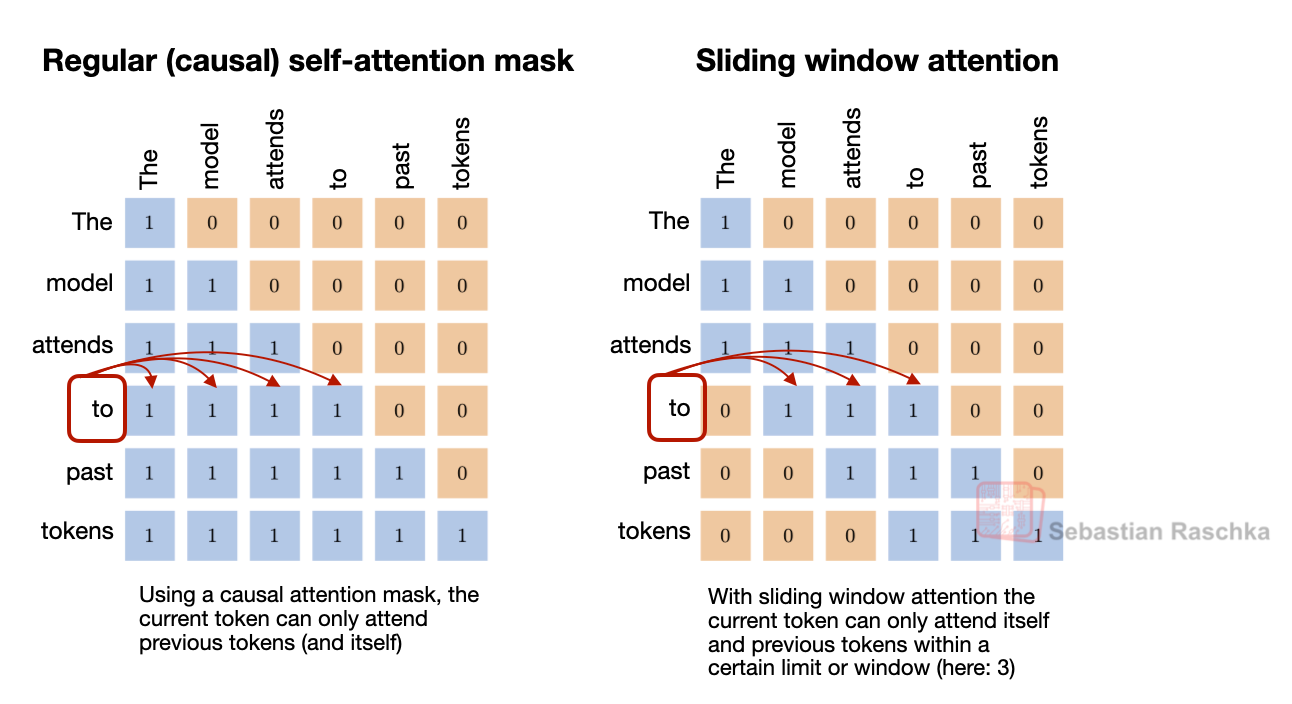
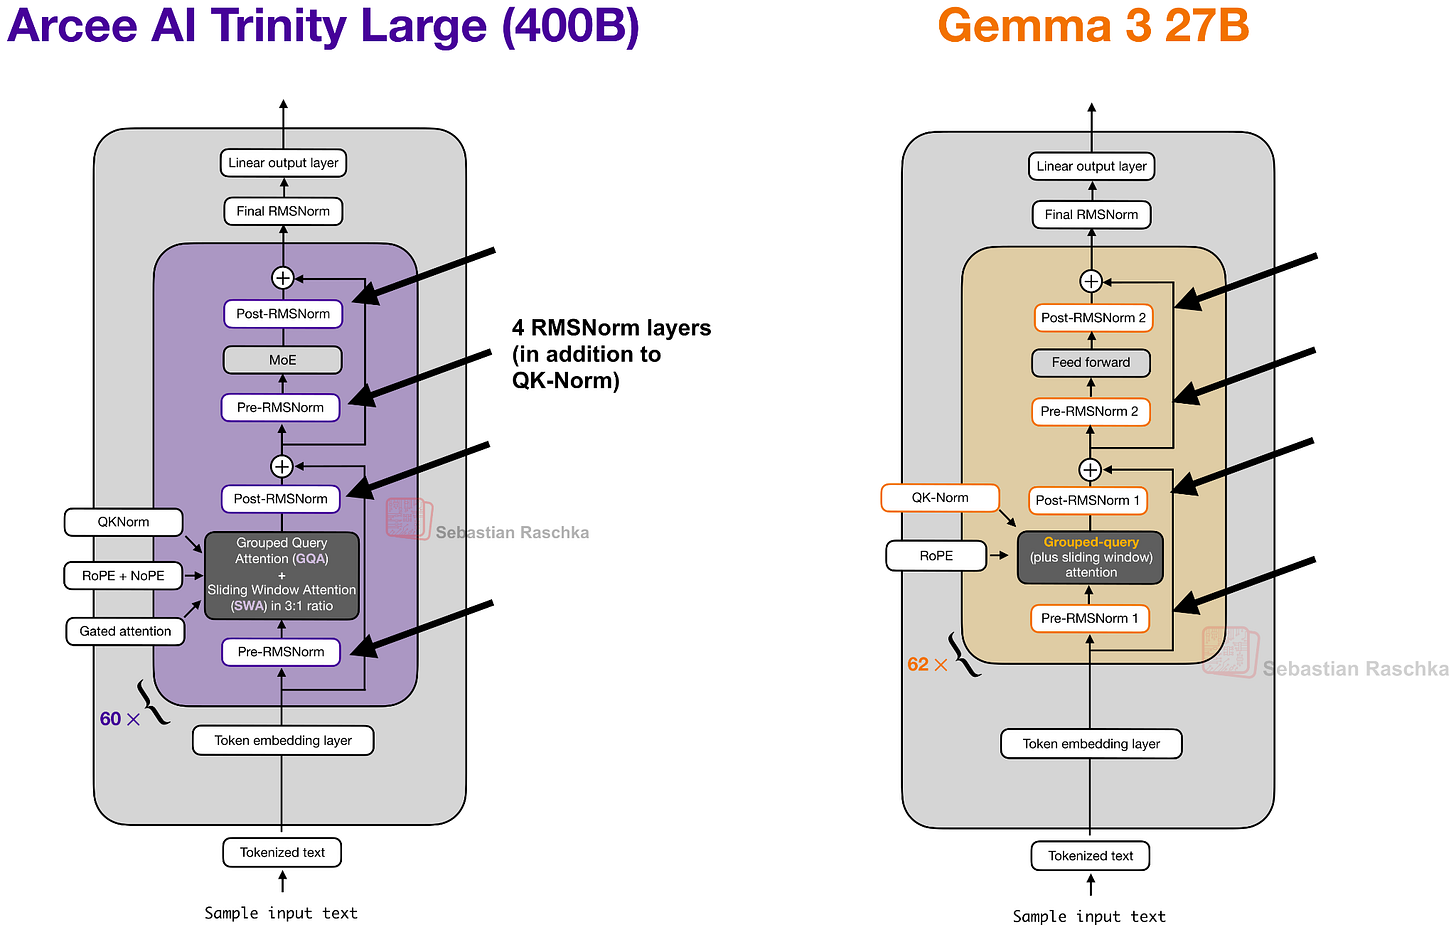
Trinity Large 采用了交替式的局部-全局注意力层(Sliding Window Attention),这是继 Gemma 3、OLMo 3、小米 MiMo 之后又一例采用该方案的模型。
SWA 的核心思想是:每个 token 仅关注固定大小的最近窗口(如 4096 个 token),而非全序列。这将单层注意力的计算复杂度从 O(n²) 降至 O(n·t)(n 为序列长度,t 为窗口大小),对长上下文场景意义重大。
值得注意的是,Trinity 选择了 3:1 的局部与全局注意力比例(而非 Gemma 3 和小米常用的 5:1),窗口大小设定为 4096,与 OLMo 3 的设计思路相近。
对开发者的价值:如果你正在构建长文本处理管线(如文档问答、代码审查),采用 SWA 的模型在长序列推理时速度更快、显存消耗更少,是实际部署中的重要考量因素。
架构趋势三:训练稳定性技术集中落地
本期多个模型引入了提升训练稳定性的技术组合:
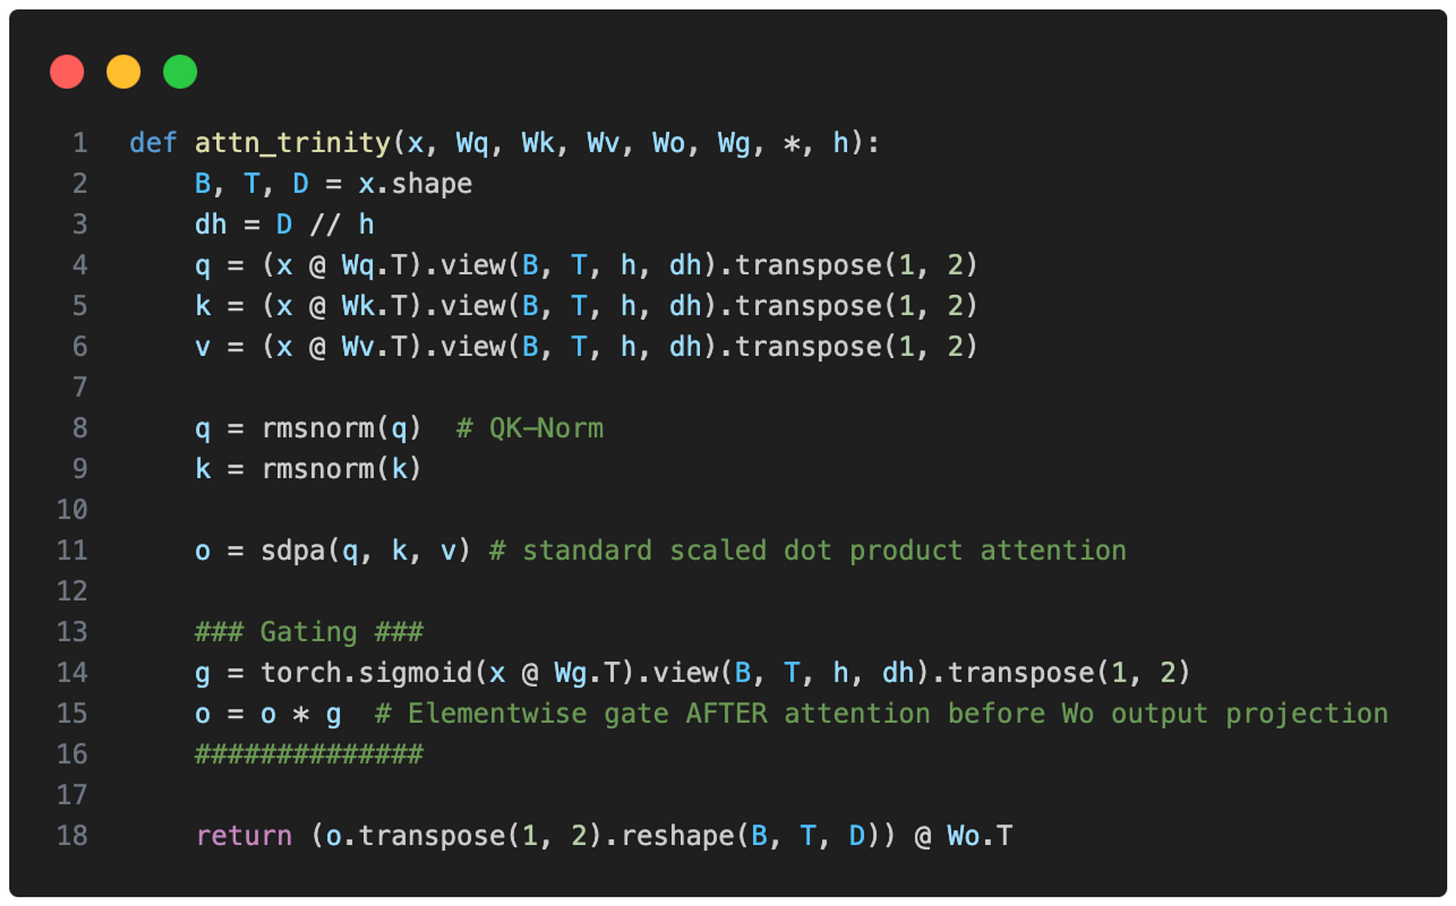
- QK-Norm:对 Key 和 Query 应用 RMSNorm,防止注意力分数爆炸,Trinity Large 和 GLM-4.5 均采用了此方案
- 门控注意力机制:Trinity 在缩放点积之后、输出线性投影之前加入了逐元素门控,类似 Qwen3-Next 的做法,有效减少注意力汇聚点(attention sink),改善长序列泛化能力
- 全局注意力层无位置编码(NoPE):Trinity 在全局注意力层中省略了位置嵌入,与 SmolLM3 的设计一致
实用解读:这些技术虽然对普通用户不可见,但它们直接影响模型的长文本表现和训练可靠性。如果你在对比模型时看到这些架构特征,可以预期该模型在长上下文任务中更具竞争力。
选型速查
| 场景 | 推荐关注 | 原因 |
|---|---|---|
| 代码生成 | Qwen3-Coder-Next、Trinity Large | 代码能力专项优化 |
| 长文档处理 | 采用 SWA 的模型(Trinity、GLM-5) | 长序列推理效率更高 |
| 边缘/端侧部署 | Trinity Nano、Nanbeige 4.1 3B | 参数量小,资源占用低 |
| 多语言任务 | Cohere Tiny Aya、Ling/Ring 2.5 | 多语言覆盖广泛 |
总结
2026 年初的开放权重模型发布潮呈现出清晰的架构演进方向:MoE 降低推理成本、SWA 提升长序列效率、门控与归一化技术增强训练稳定性。对于开发者而言,理解这些架构差异不仅能帮助你做出更明智的模型选型,也能为后续的微调和部署提供有价值的参考。
建议持续关注 Sebastian Raschka 的后续更新,尤其是 DeepSeek V4 发布后的架构对比,这将进一步完善开放权重生态的全景图。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:A Dream of Spring for Open-Weight LLMs: 10 Architectures from Jan-Feb 2026
阅读原文