2025年LLM格局:推理模型、RLVR与DeepSeek时刻
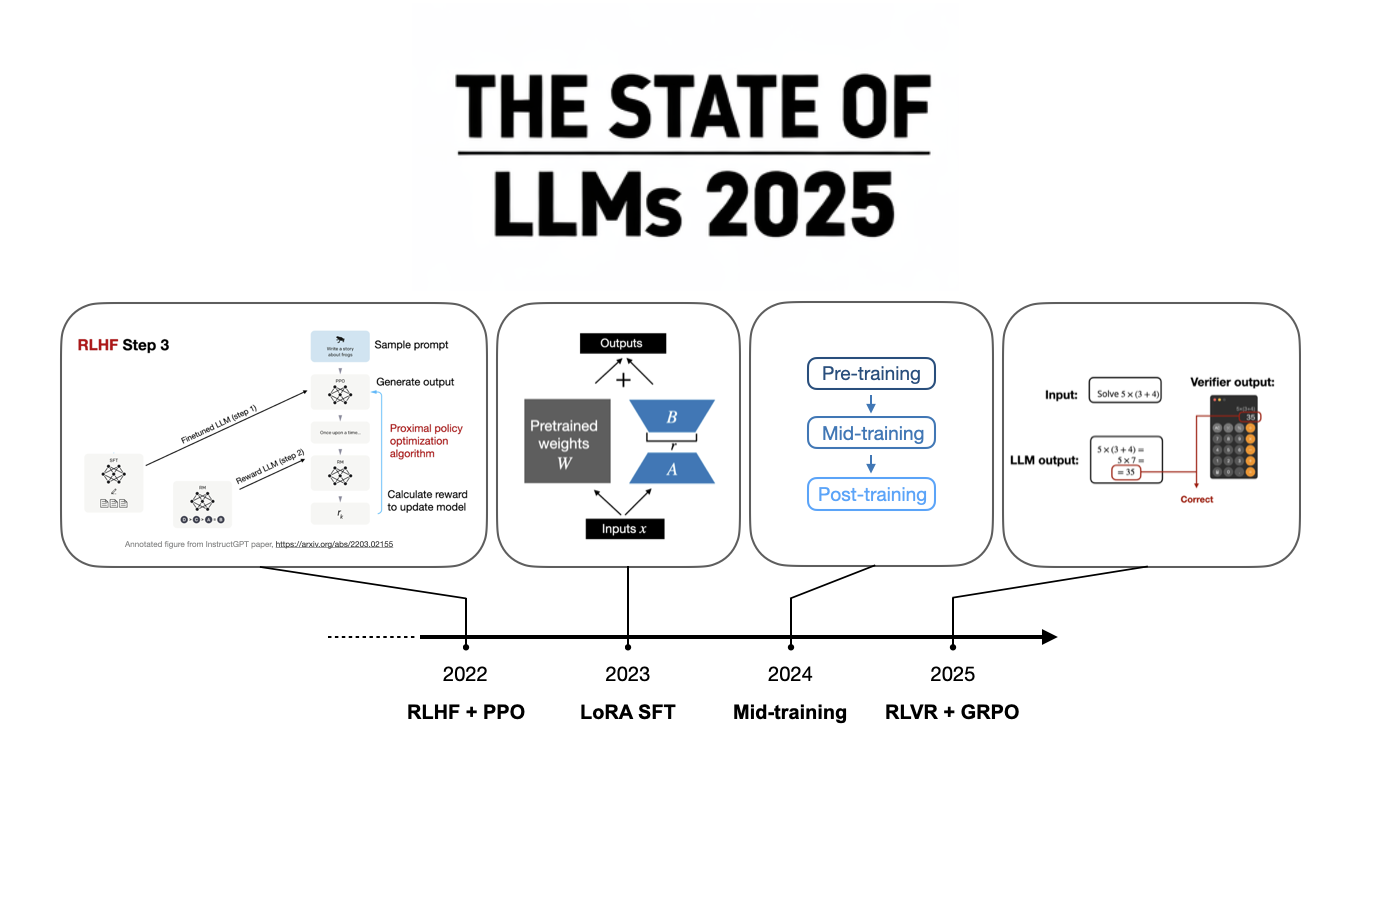
2025年大语言模型迎来推理能力爆发,DeepSeek R1开源模型刷新成本认知,RLVR与GRPO算法为后训练开辟新路径。本文梳理关键进展并解读开发者实用价值。
2025:推理模型元年
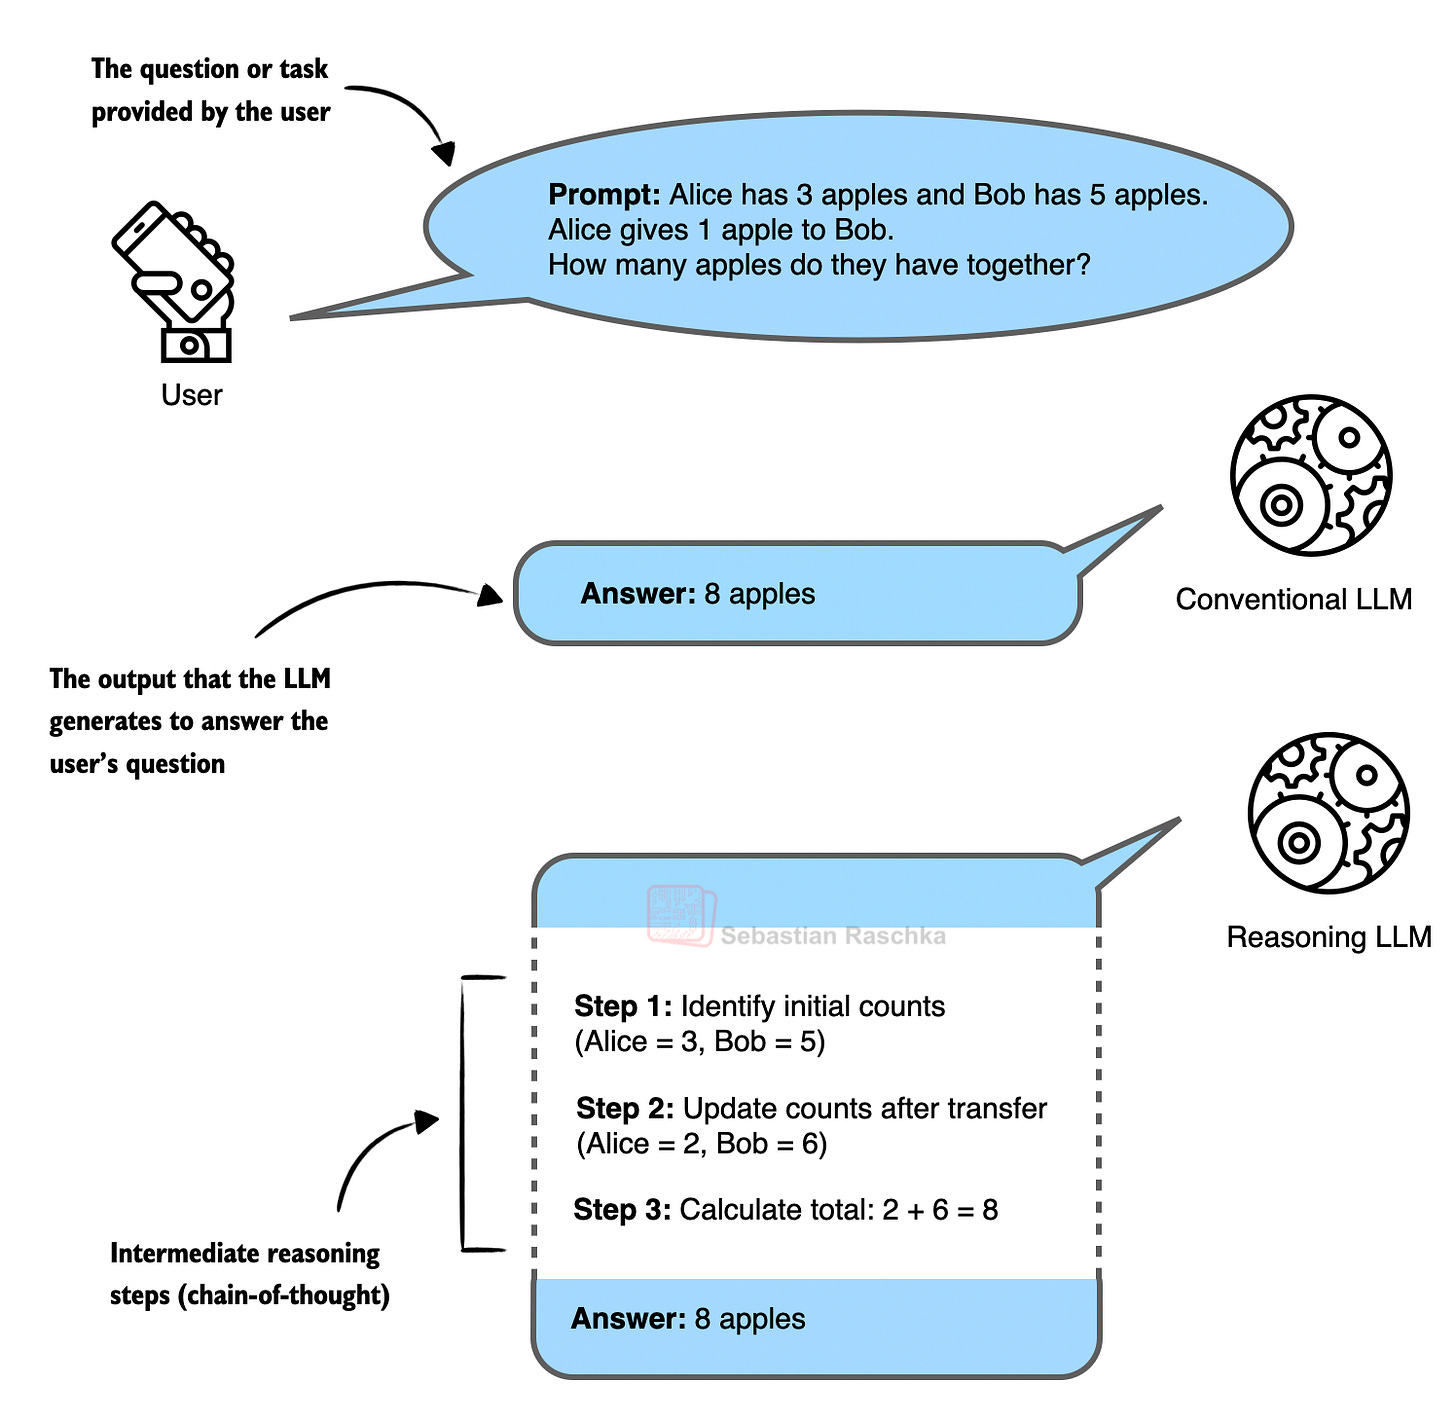
如果说2024年是大模型规模竞赛的收官之年,那2025年无疑属于推理模型(Reasoning Model)。所谓"推理",指的是模型在给出答案前先展示中间思考过程,这种"先想后答"的模式往往能显著提升复杂问题的准确率。
年初,OpenAI发布o1模型,首次将推理链(reasoning traces)引入主流产品,但真正引爆行业的是DeepSeek R1——一款开源权重模型,性能直逼当时的顶级闭源模型(ChatGPT、Gemini等),却在成本上给出了完全颠覆市场的数字。
DeepSeek时刻:成本认知被彻底改写
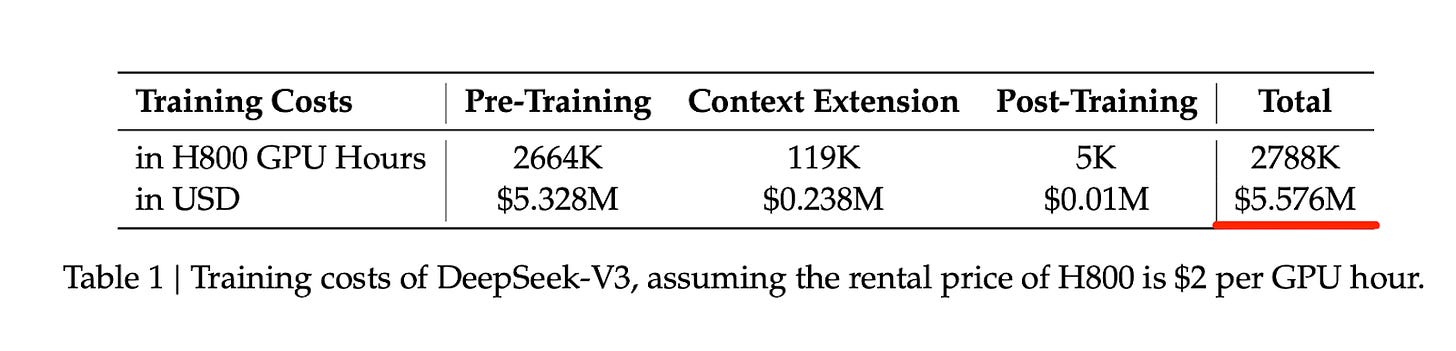
DeepSeek R1的论文及其补充材料引发了连锁反应,让投资者和媒体重新审视2024年12月发布的DeepSeek V3论文。此前业界普遍认为训练一个顶级模型需要数亿美元,而修正后的估算显示,671B参数的DeepSeek V3训练成本可能仅约500万美元——比此前猜测低了一个数量级。
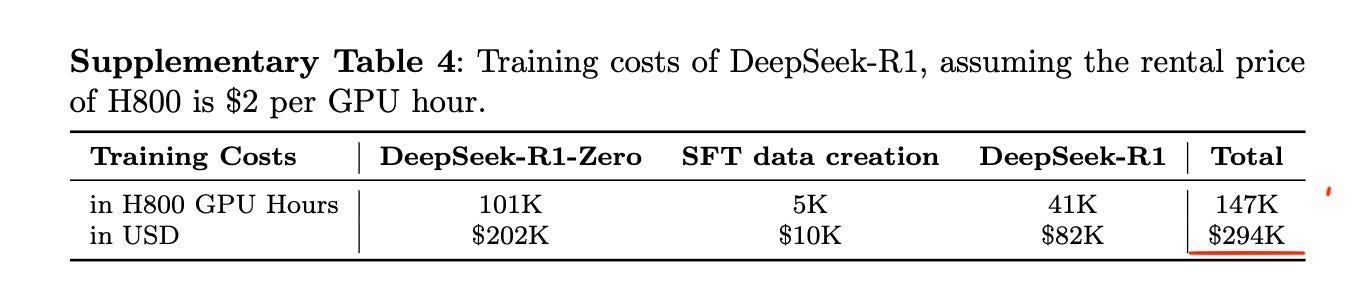
更关键的是,在V3基础上训练R1的额外成本估计仅为约29.4万美元。当然,这个数字有重要前提:它只覆盖了最终模型运行的算力费用,并未计入研究人员薪资、超参数调优和实验探索等隐性成本。
对开发者的启示:开源模型的成本门槛正在快速下降,中小团队基于开源底座进行后训练(post-training)的可行性大幅提高。
RLVR与GRPO:后训练的新范式
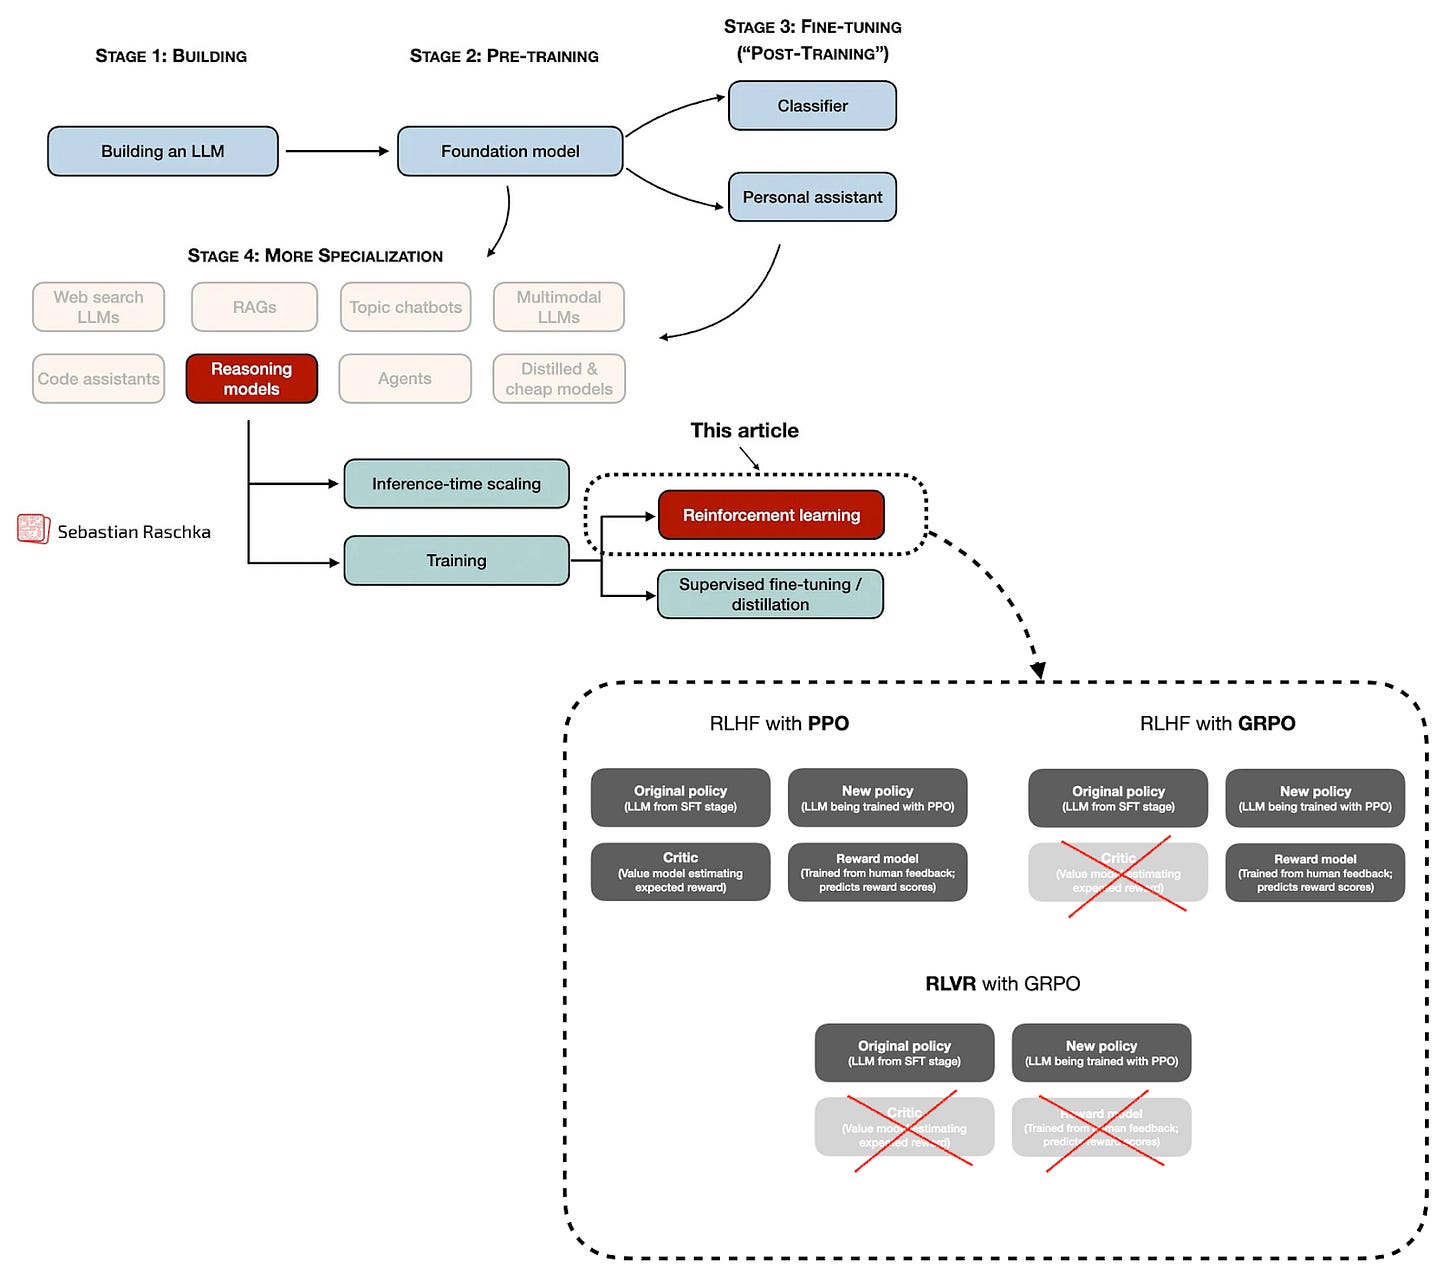
RLVR(Reinforcement Learning with Verifiable Rewards)是DeepSeek R1论文中最具技术含量的贡献,其核心算法为GRPO。
传统后训练的瓶颈
在此之前,主流后训练方法包括:
- SFT(监督指令微调):需要大量人工撰写的指令-回答对
- RLHF(基于人类反馈的强化学习):需要人类标注偏好数据
这两种方法的共同痛点是依赖昂贵的人工标注,数据规模受限,难以通过增加计算预算来进一步扩展能力。
RLVR如何破局
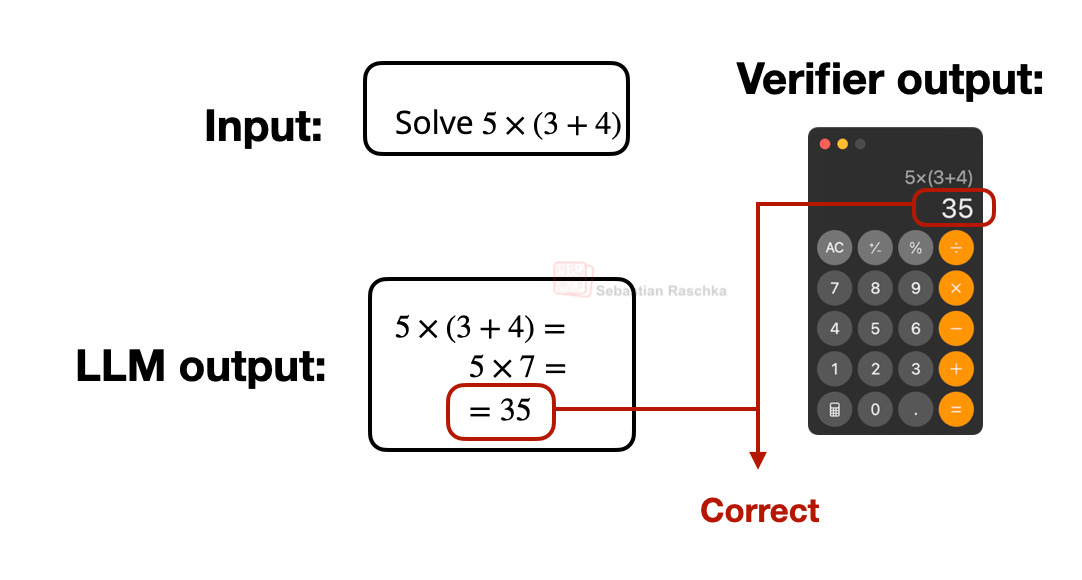
RLVR的关键在于"可验证奖励"——用确定性方法(而非人类判断)来判定答案是否正确。典型的可验证场景包括:
- 数学计算题
- 代码执行结果
- 逻辑推理题
这意味着可以用大规模自动化生成的数据进行后训练,不再受限于人工标注产能。对于有计算预算的团队来说,RLVR打开了一条通过扩展后训练算力来提升模型能力的清晰路径。
对开发者与AI使用者的实用建议
- 关注开源推理模型:DeepSeek R1等开源模型已具备接近顶级闭源模型的能力,适合自建推理服务或二次开发。
- 评估RLVR适用场景:如果你的业务涉及数学、代码、逻辑推理等可验证任务,RLVR类方法值得纳入技术选型。
- 重新计算成本预算:开源模型训练成本的下降意味着"自研模型"的门槛正在降低,值得重新评估自研与API调用的成本效益比。
- 警惕成本估算的局限性:500万美元的估算仅覆盖算力,实际项目还需考虑人力、实验迭代等隐性投入。
展望
2025年的核心叙事是:规模扩展仍然有效,但推理能力的突破比单纯扩大参数更有价值。RLVR+GRPO组合为后训练提供了可扩展的新范式,预计2026年会有更多团队在此基础上探索推理能力的进一步扩展。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:The State Of LLMs 2025: Progress, Problems, and Predictions
阅读原文