现代LLM注意力机制演进:从MHA到新型架构
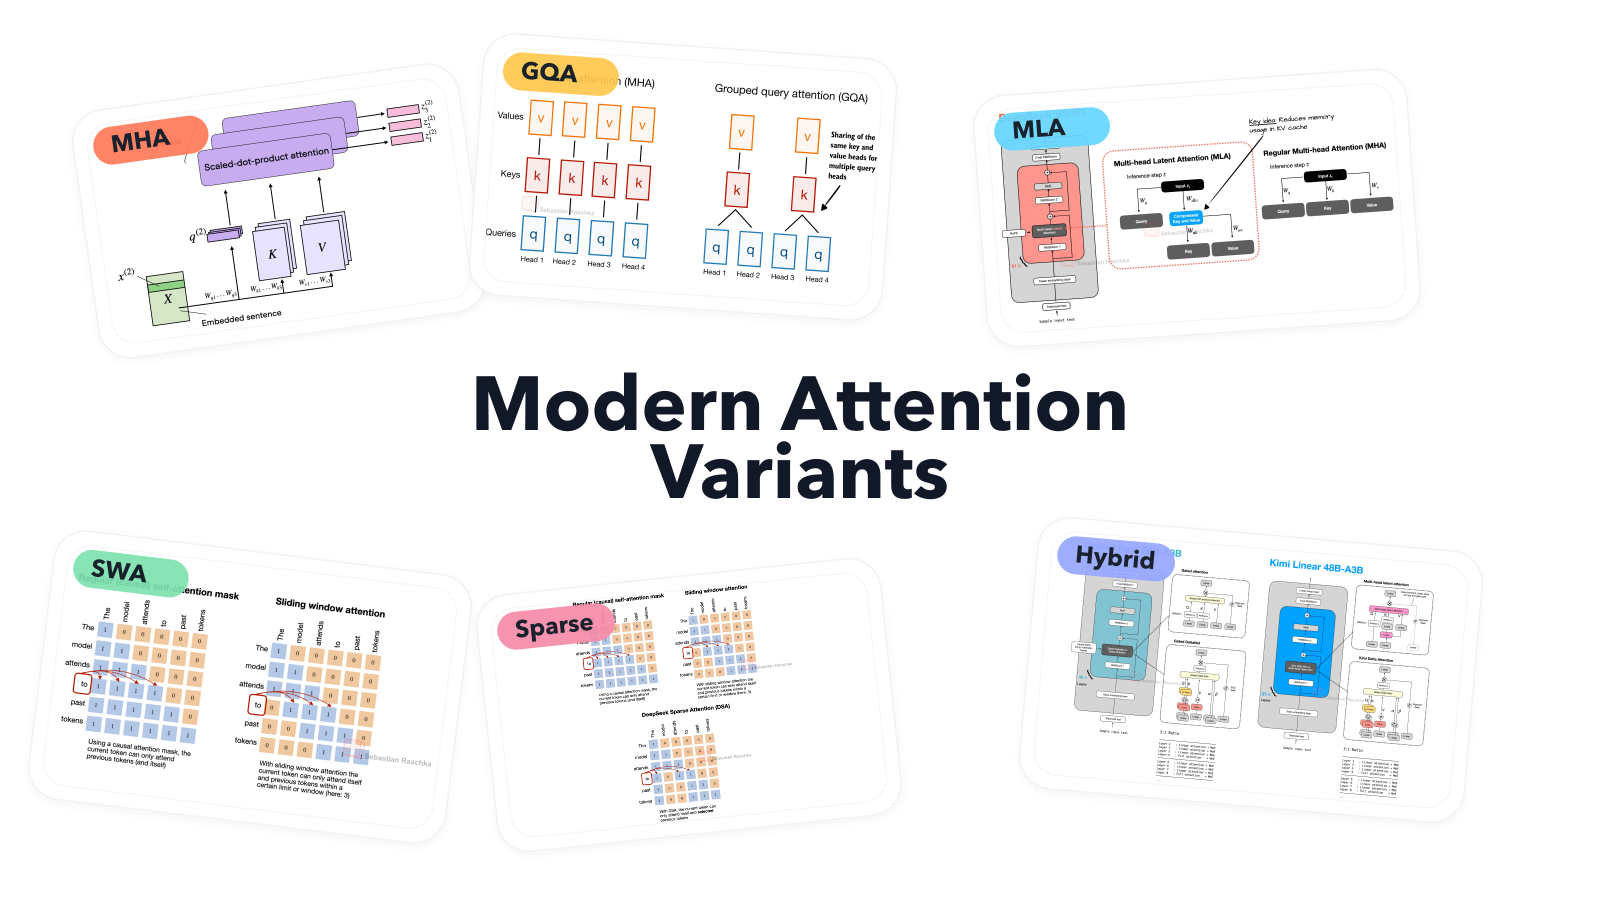
作者整理了45种LLM架构,发布可视化画廊与海报,并深入解析了包括MHA在内的核心注意力机制演变及其在翻译任务中的历史背景。
现代LLM注意力机制演进:从MHA到新型架构
在深度学习领域,Sebastian Raschka 博士近期发布了一份关于现代大型语言模型(LLM)注意力机制的深度解析。由于备受关注的 DeepSeek V4 尚未发布,他利用这段时间系统性地整理了过去几年涵盖的 45 种不同 LLM 架构,制作了一个可视化的架构画廊。本文将带你了解这份资源的实用价值,并深入回顾多头注意力(MHA)的原理及其历史演进。
1. 实用资源:LLM 架构画廊与海报
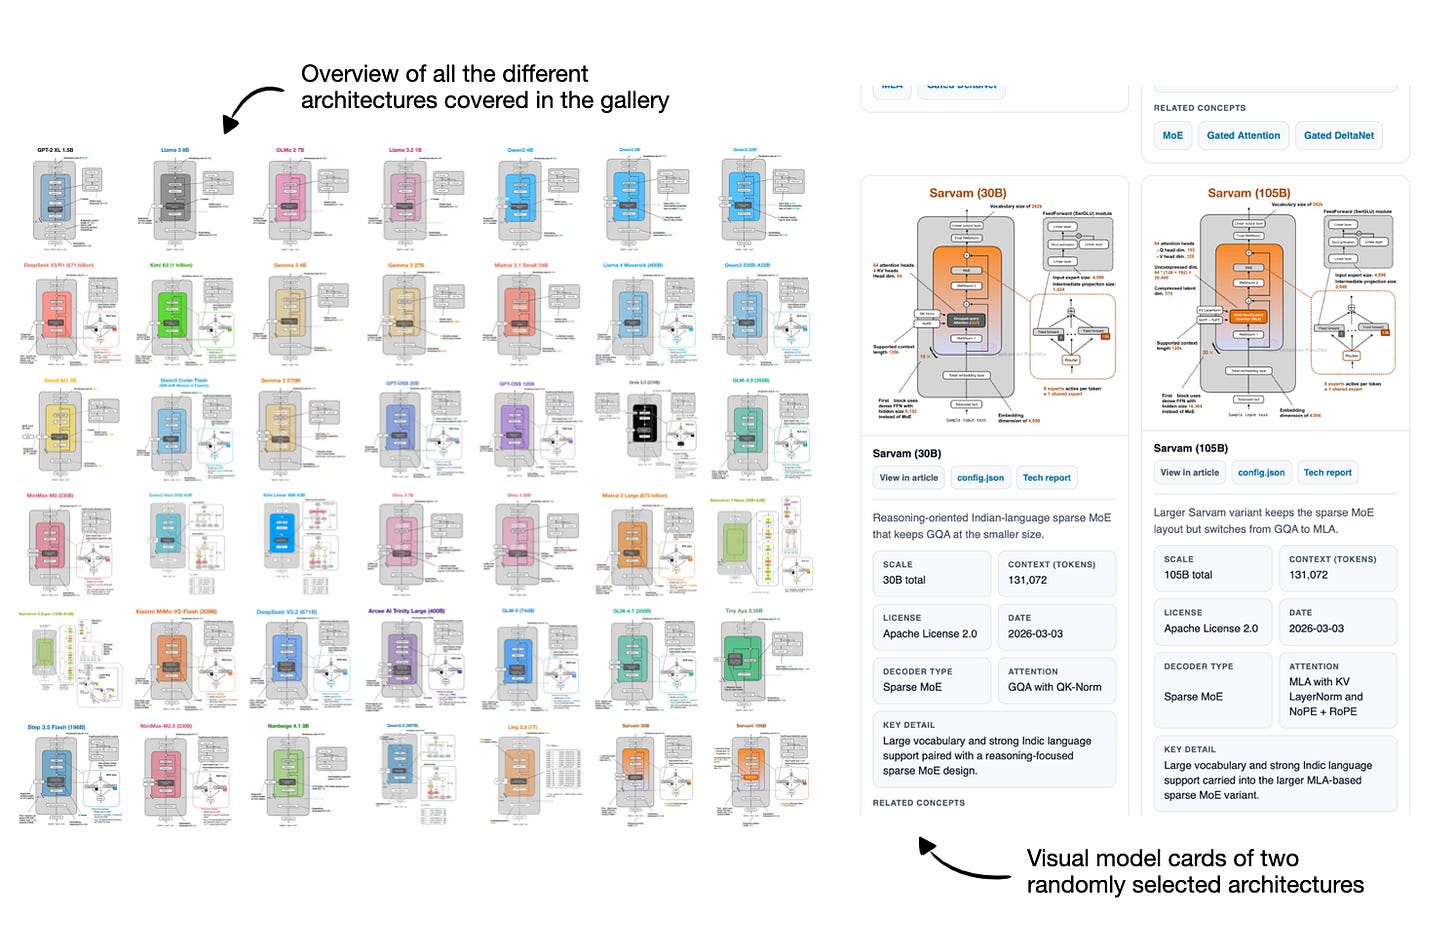
为了帮助开发者和研究人员更直观地理解复杂的模型结构,作者构建了一个包含 45 个条目的 LLM 架构画廊。
- 可视化模型卡片:每个条目都配备了视觉化的模型卡片,能够清晰展示模型的内部运作方式,是极佳的参考和教学素材。
- 持续更新:该画廊计划保持定期更新,确保收录最新的架构设计。
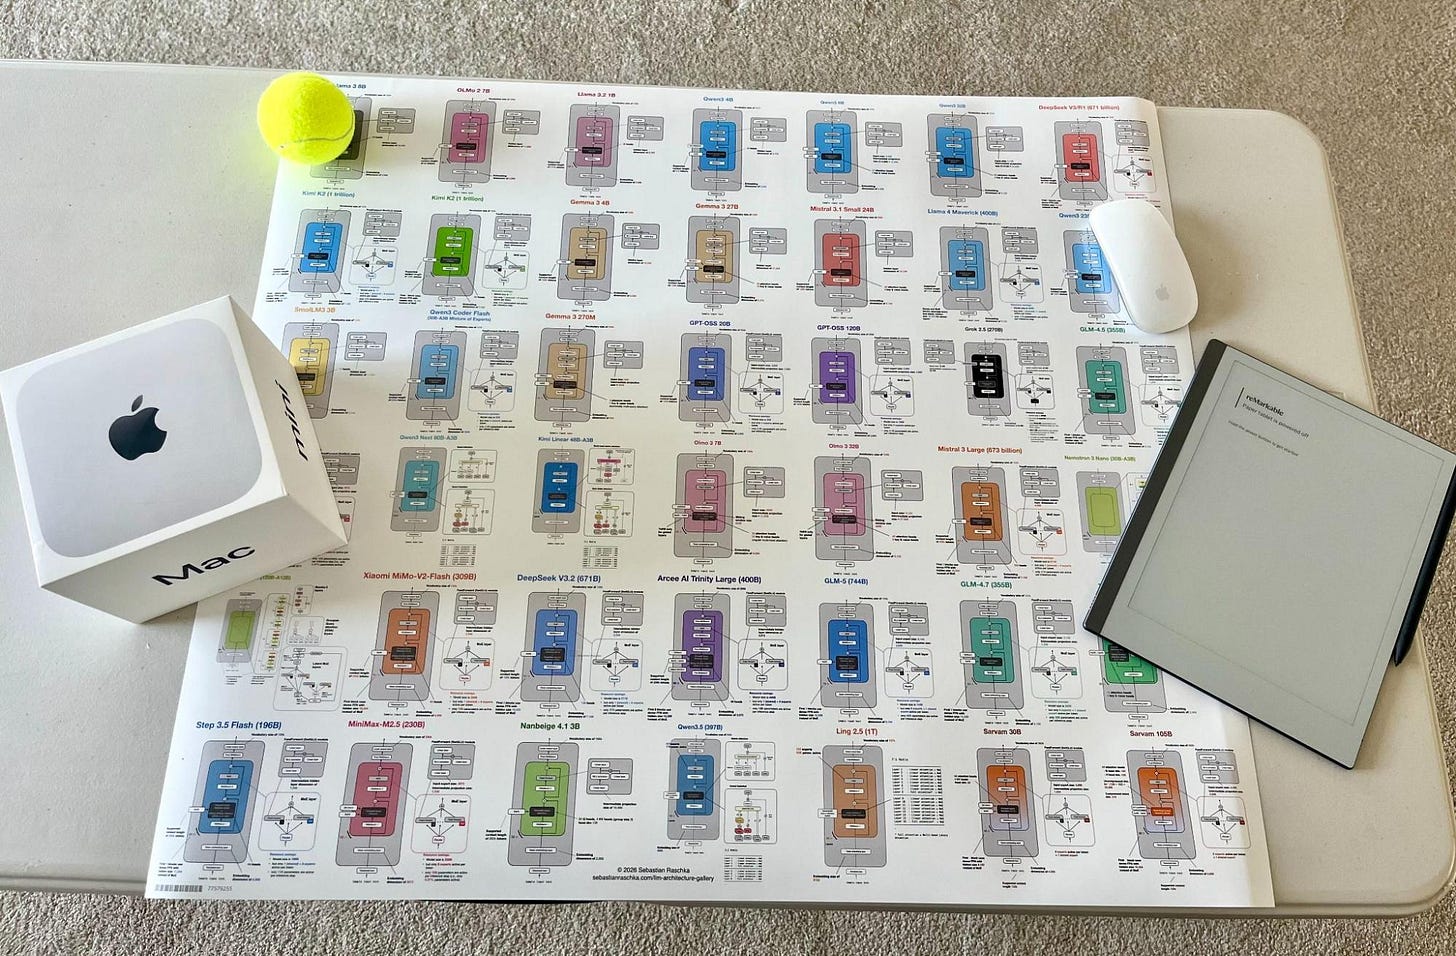
- 实物海报:画廊还提供了实体海报版本(通过 Redbubble 销售),尺寸为 26.9 x 23.4 英寸。作者测试后反馈,印刷效果清晰锐利。
💡 开发者提示:如果你打算购买海报用于学习或展示,建议选择中号尺寸。作者提醒,过小的版本可能会导致文字细节难以辨认。
2. 核心技术回顾:多头注意力 (MHA)
注意力机制是现代 LLM 的基石,而 多头注意力 是 Transformer 架构的标准实现。
什么是自注意力?
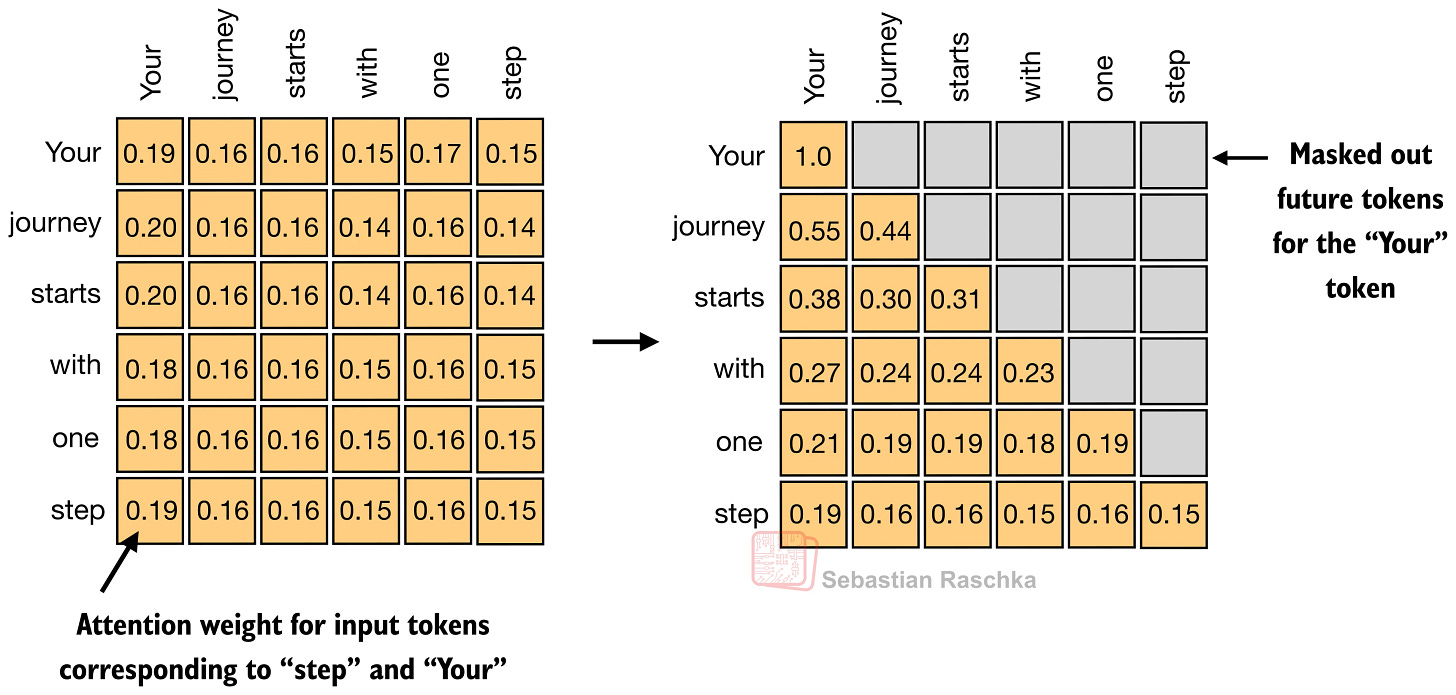
在序列处理中,自注意力机制允许模型中的每个“标记”同时关注序列中的其他标记。具体流程如下:
- 观察:每个 token 查看序列中的其他可见 token。
- 加权:模型根据相关性为这些 token 分配权重。
- 重构:利用这些权重,为每个 token 构建一个新的、具备上下文感知能力的表示。
多头注意力的优势
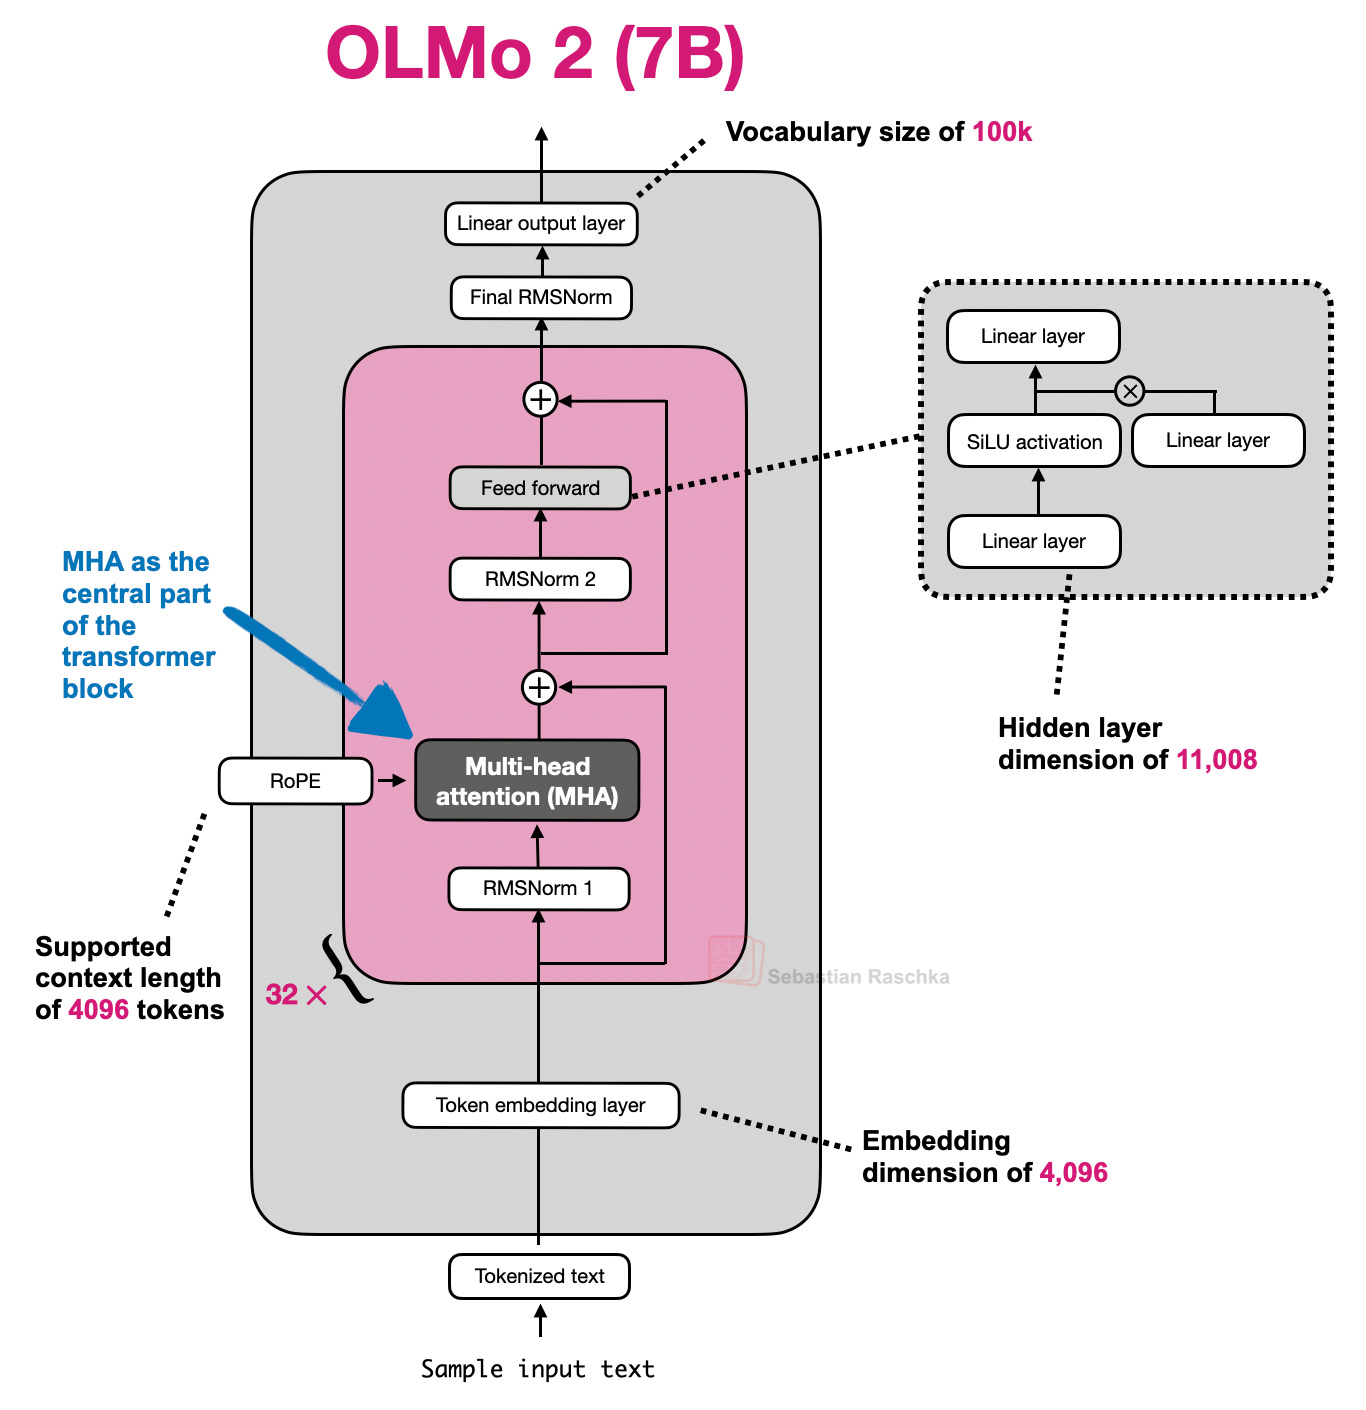
多头注意力 (MHA) 将上述过程并行运行多次,每次使用不同的投影参数。这就像模型从多个不同的角度同时观察数据,然后将这些视角的输出进行融合,从而形成一个更加丰富、全面的特征表示。
典型应用案例:
- GPT-2
- OLMo 2 7B
- OLMo 3 7B
3. 历史回溯:为什么需要“注意力”机制?
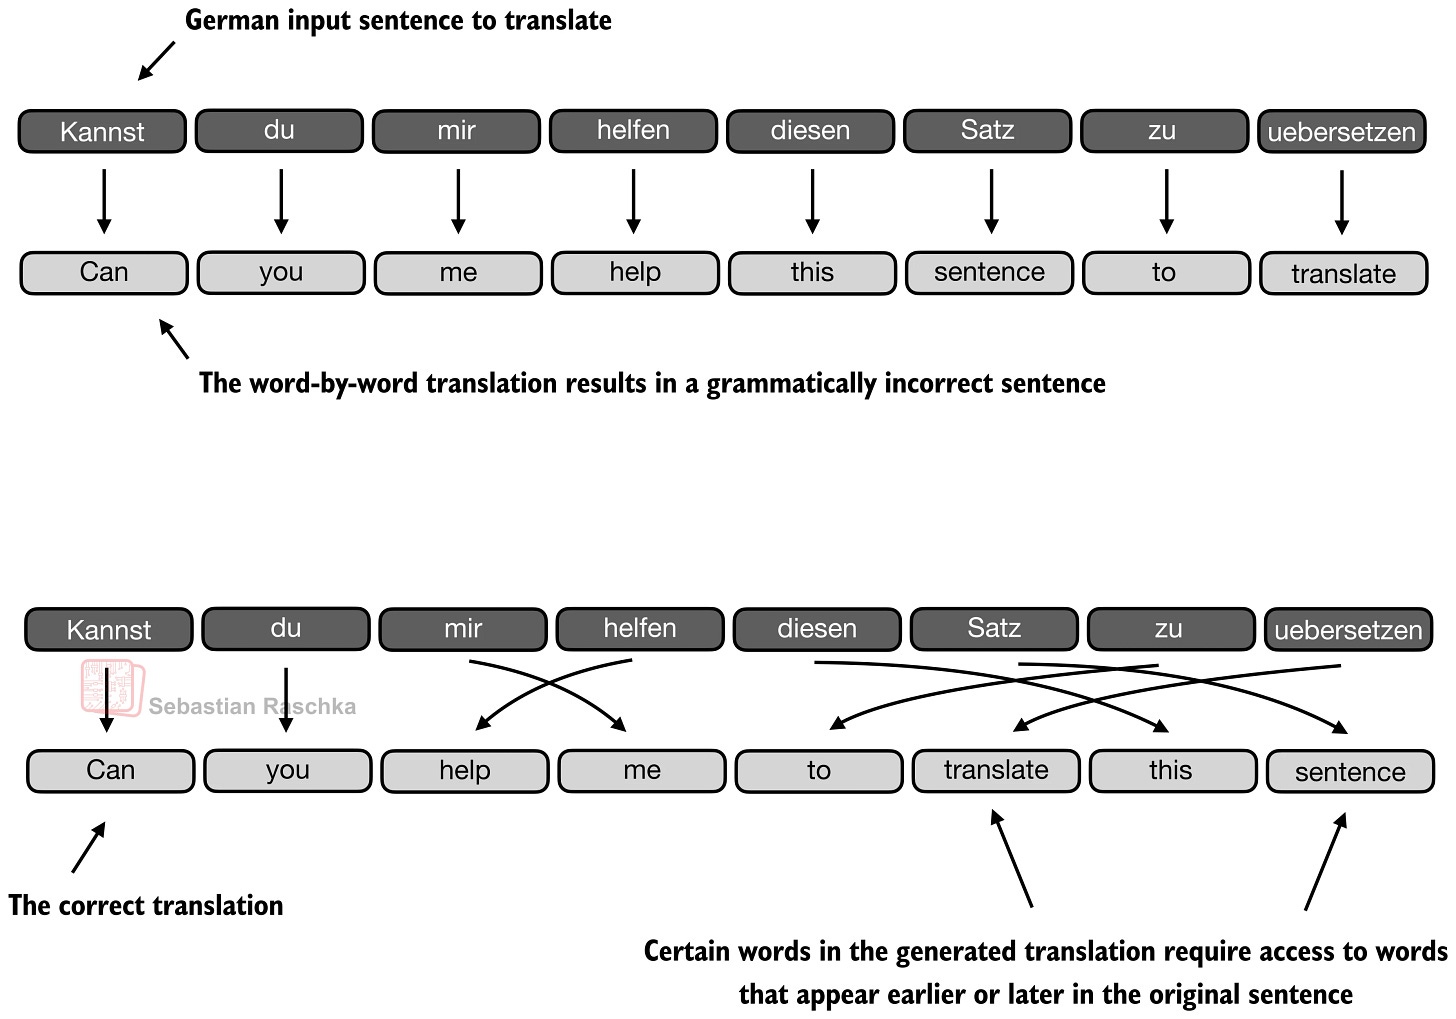
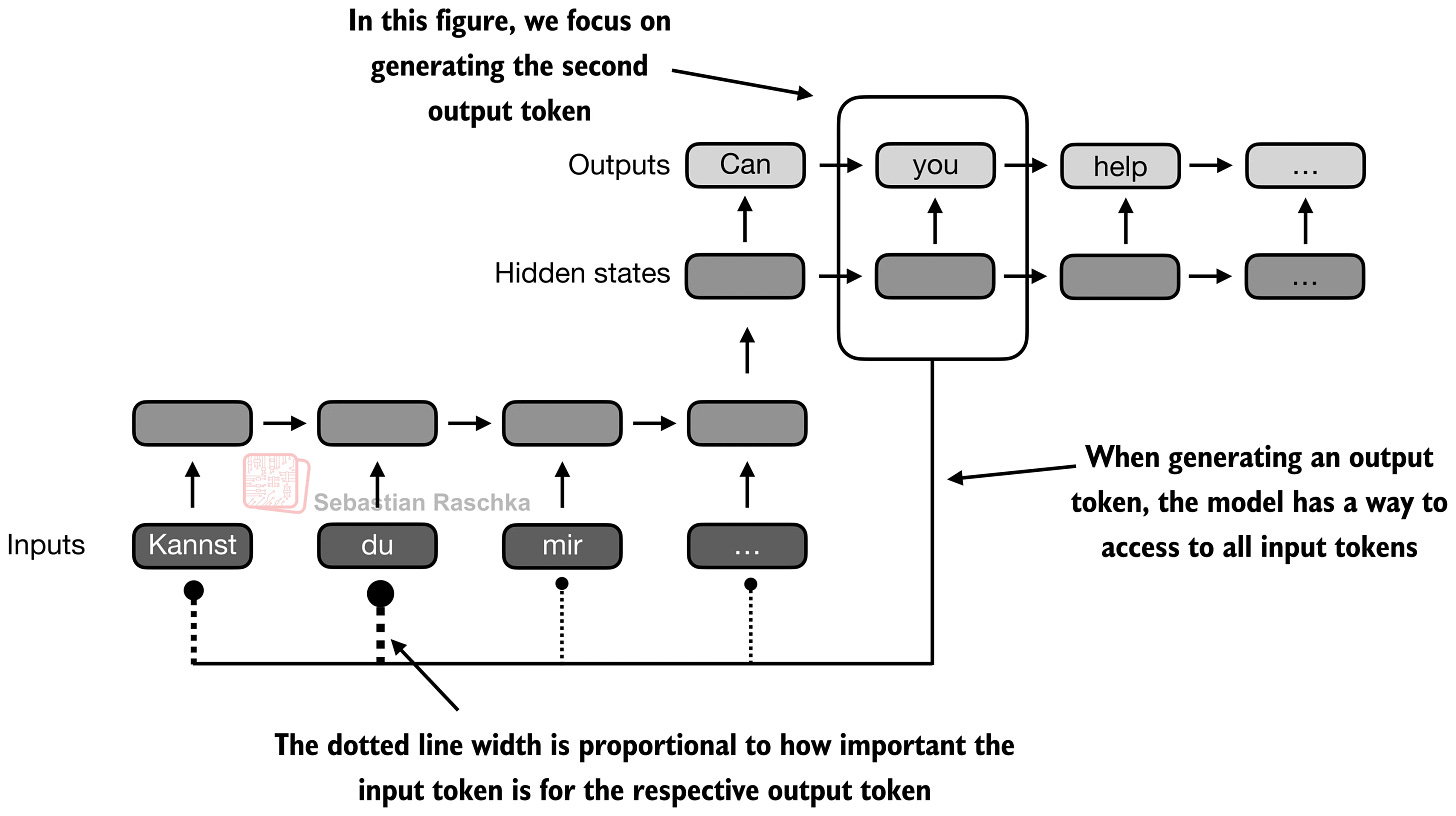
注意力机制并非 Transformer 独有,它最早源于编码器-解码器 RNN(循环神经网络)的翻译任务。
RNN 的瓶颈
在早期的 RNN 翻译模型中,编码器逐个读取源句子的 token,并将其压缩为一个有限的隐藏状态。随后,解码器必须仅基于这个单一的隐藏状态来生成目标句子。
问题在于:
- 信息丢失:隐藏状态无法存储无限量的信息。
- 上下文断层:当生成下一个目标词所需的关键信息位于源句子的远端时,RNN 很难有效地回溯或引用这些信息。
注意力的解决方案
注意力机制的出现解决了这一瓶颈。它允许模型在生成输出时,不再局限于那个有限的隐藏状态,而是可以直接“参考”整个输入序列的相关部分。这使得模型能够更准确地捕捉长距离依赖关系,显著提升了翻译等任务的性能。
总结
通过 Sebastian Raschka 的整理,我们不仅获得了一个宝贵的 LLM 架构参考库,还重新梳理了注意力机制从 RNN 时代到现代 Transformer 的演进逻辑。对于开发者而言,理解 MHA 及其变体(如分组查询注意力 GQA 等)对于优化模型推理和训练至关重要。