查询分解无法根治上下文饥饿
深入分析为何将复杂查询拆解为子问题,并不能从根本上解决大模型上下文窗口受限的问题,反而可能引发新的信息丢失,并给出应对策略。
查询分解无法根治上下文饥饿
在当今的软件开发和 AI 应用落地中,大语言模型(LLM)的上下文窗口限制已成为一个显著的瓶颈。当面对海量数据或长文档时,模型往往会因为“记不住”前面的内容而出现性能下降,这种现象被称为上下文饥饿。为了应对这一挑战,许多开发者会采用查询分解技术,试图通过将一个大问题拆解为多个小问题来解决。然而,最新的技术分析表明,这种方法往往治标不治本,甚至可能将问题转移到了新的层面。
什么是查询分解?
查询分解是一种常见的 Prompt 工程策略。其核心思想是将一个复杂、冗长且难以直接回答的查询,拆解为一系列逻辑上相关、更易于模型处理的小型子查询。例如,将“请分析2020年至2023年全球科技行业的发展趋势及其对就业市场的影响”拆解为“全球科技行业发展趋势”、“2020-2023年就业市场数据”等子问题,模型在处理每个子问题时所需的上下文窗口更小,理论上能获得更准确的局部答案。
为什么它只是转移了问题?
尽管查询分解在理论上听起来很完美,但它并没有解决上下文窗口的物理限制,本质上只是将“一次性处理所有信息”的负担转移到了“多次处理部分信息”的过程中。
上下文窗口的物理限制
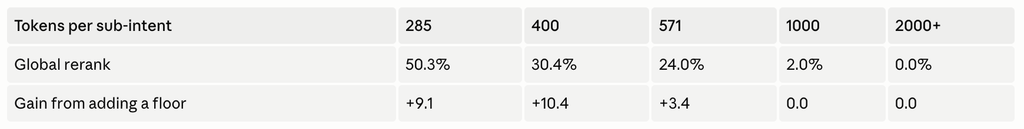
无论模型多么先进,其输入 Token 的数量始终是有限的。当你将一个长查询分解后,虽然单个子查询的长度变短了,但整个任务链条的总 Token 消耗并没有减少。如果原始的长查询本身就超过了上下文窗口,分解后的子查询依然面临同样的限制。
信息在拆解中的流失
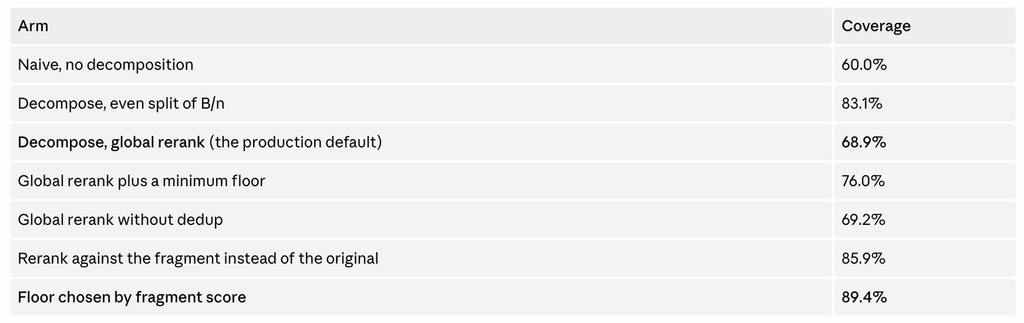
更严重的是,分解过程可能导致关键信息的丢失。在处理第一个子查询时,模型可能已经截断了原始长文本的上下文。当模型试图回答后续的子查询时,它可能缺乏足够的上下文背景来准确理解问题,或者无法将前序步骤的信息有效传递给后续步骤。这种上下文断裂会导致回答的连贯性下降,甚至产生幻觉。
实战建议:如何正确应对长上下文
既然简单的查询分解不是万能药,开发者应如何优化长上下文处理?以下是一些实用的策略建议:
结合检索增强生成(RAG)
不要仅仅依赖模型内部的上下文。对于超长文档,应采用**检索增强生成(RAG)**技术。先使用向量数据库检索出与当前查询最相关的片段,再将这些片段作为上下文喂给模型。这比盲目拆分整个文档更有效。
生成摘要而非长文本
在输入长文档前,可以先让模型生成一份摘要。将摘要作为上下文输入,既保留了核心信息,又极大地压缩了 Token 数量,缓解了上下文饥饿问题。
结构化输出与工具调用
利用现代大模型强大的工具调用能力。让模型在回答问题时,主动决定是否需要调用外部工具(如搜索引擎、数据库)来获取信息,而不是试图一次性在 Prompt 中塞入所有信息。
总结
查询分解是一种有用的技巧,但它绝非解决上下文窗口限制的银弹。开发者需要深刻理解其局限性,即它只是改变了问题的呈现形式,而非解决了根本的容量限制。通过结合 RAG、摘要生成以及工具调用等更综合的策略,我们才能更有效地应对大模型应用中的长上下文挑战。
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Query decomposition doesn’t fix context starvation — it just moves it
阅读原文