文本分类的演进:从词袋模型到 Jev API
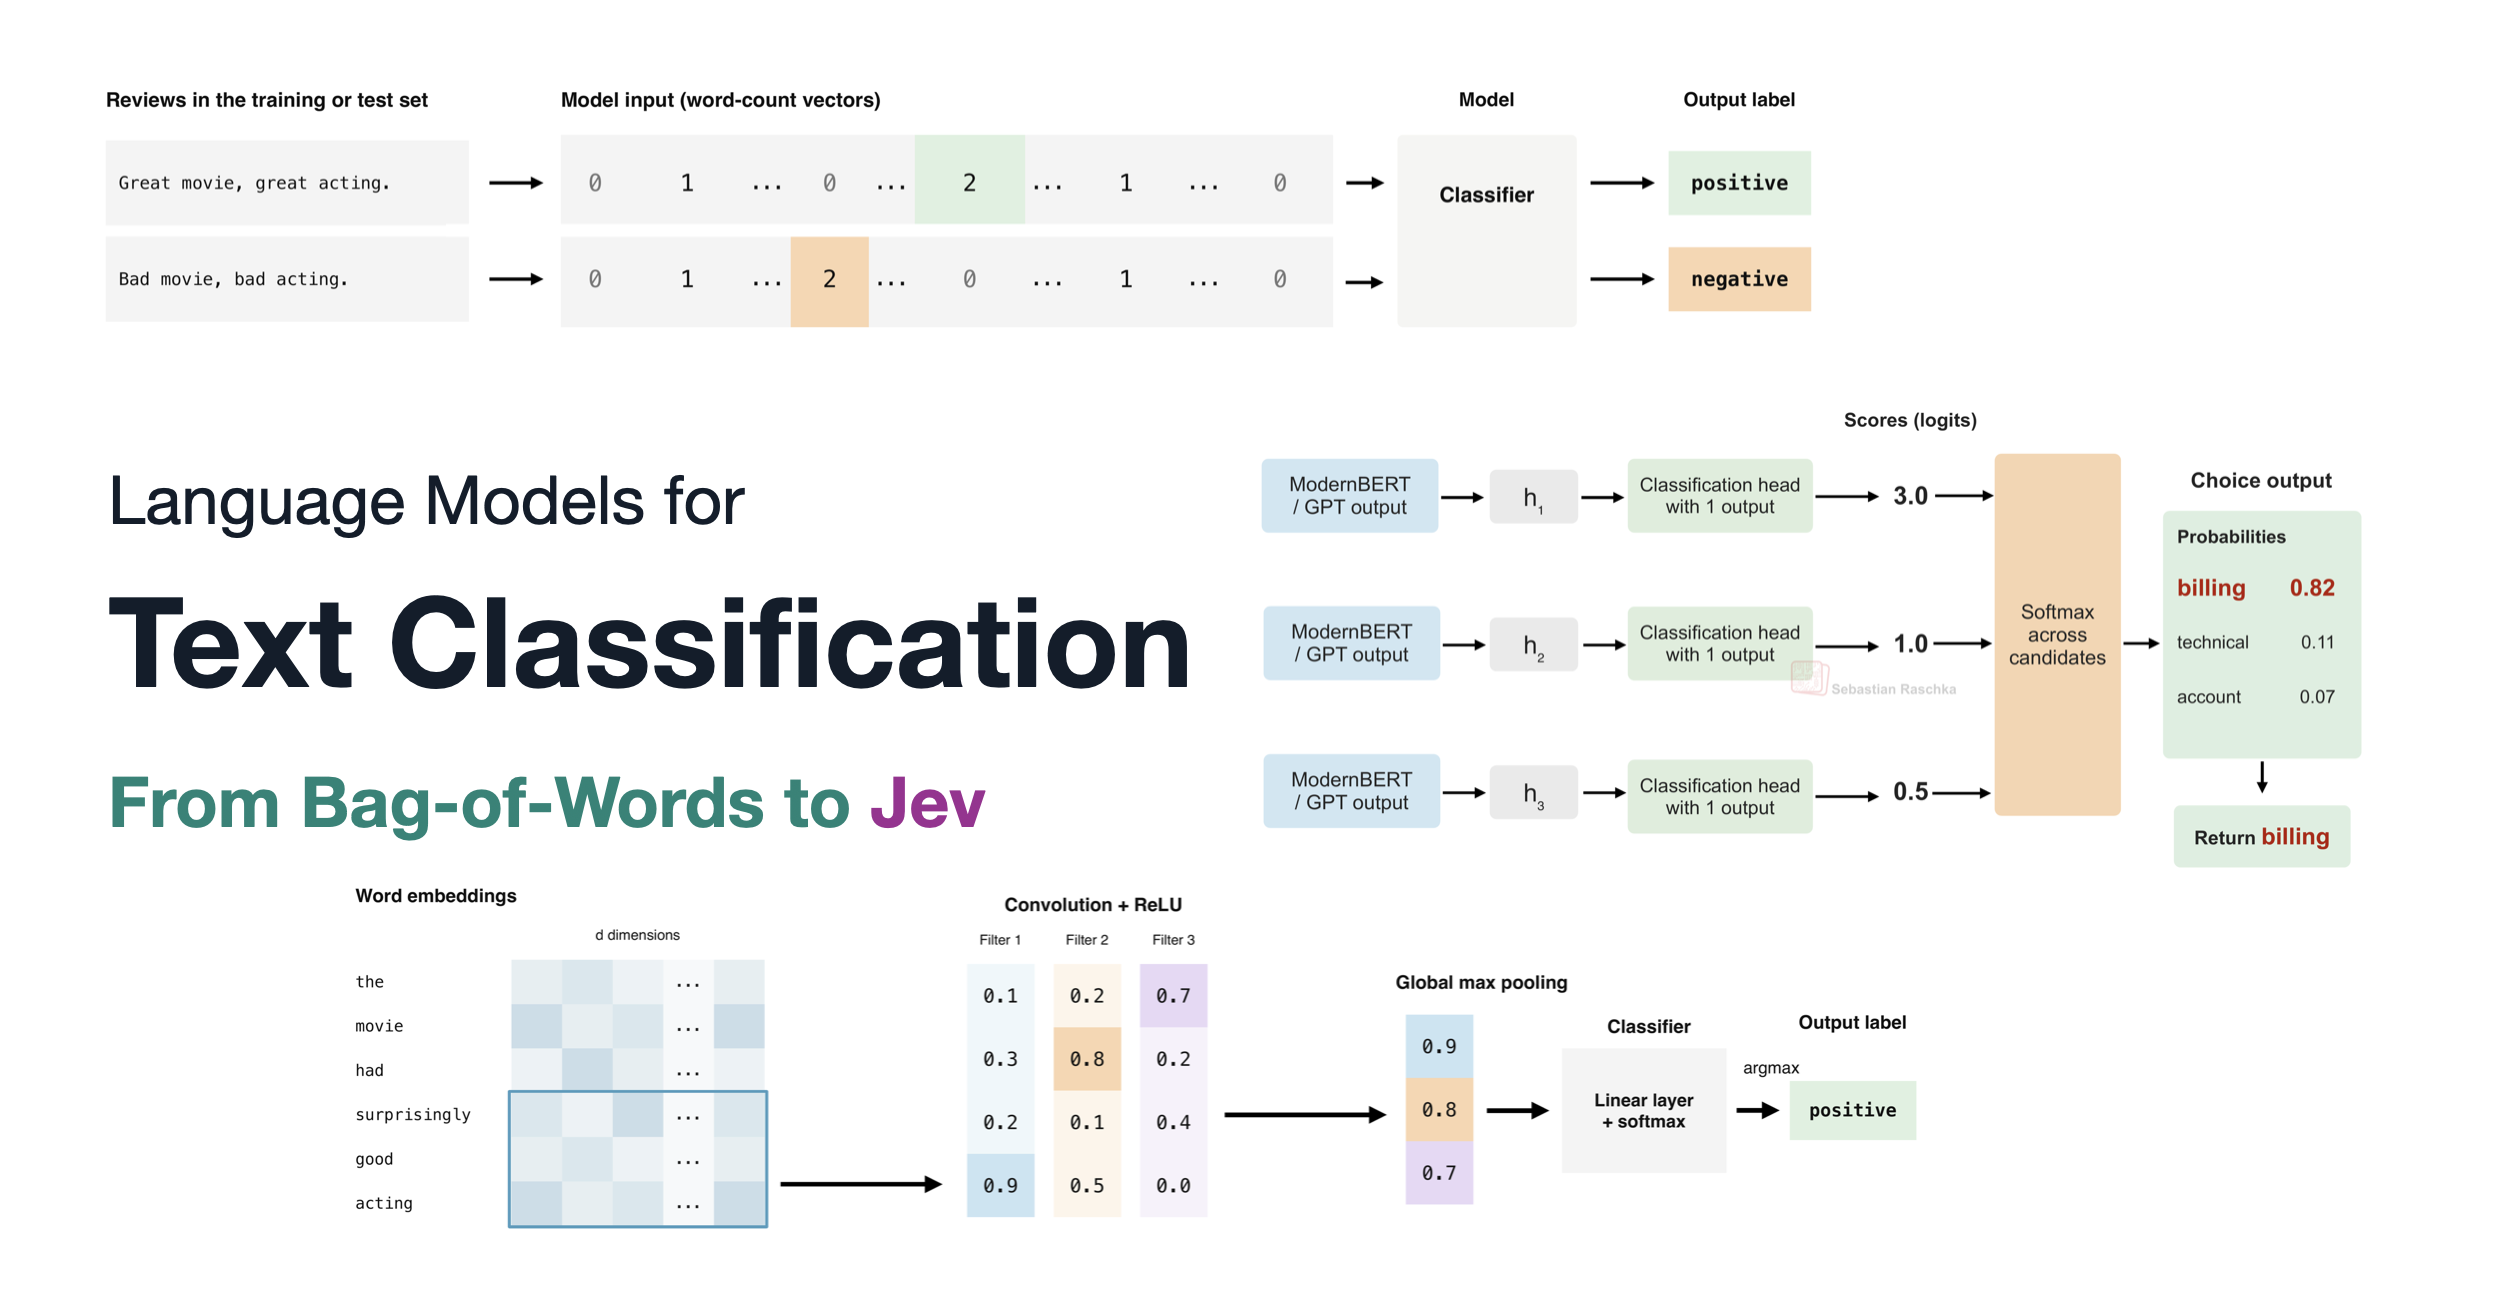
本文回顾了文本分类技术的发展历程,从早期的词袋模型到现代的 Jev API。探讨 Jev 模型为何能在分类任务上表现出色,以及它与传统机器学习和大语言模型(LLM)的区别与优势。
近期,名为 Jev 的 AI 模型在技术社区引发了广泛关注。作为一款专注于分类任务的工具,它起初被许多人视为“仅仅是一个分类器”。然而,随着深入了解,开发者们发现它实际上具有超越传统方法的潜力。本文将带你回顾文本分类技术的演进,从经典的词袋模型到如今的 Jev API,并解析其中的技术逻辑与实用价值。
1. 词袋模型:文本分类的基石
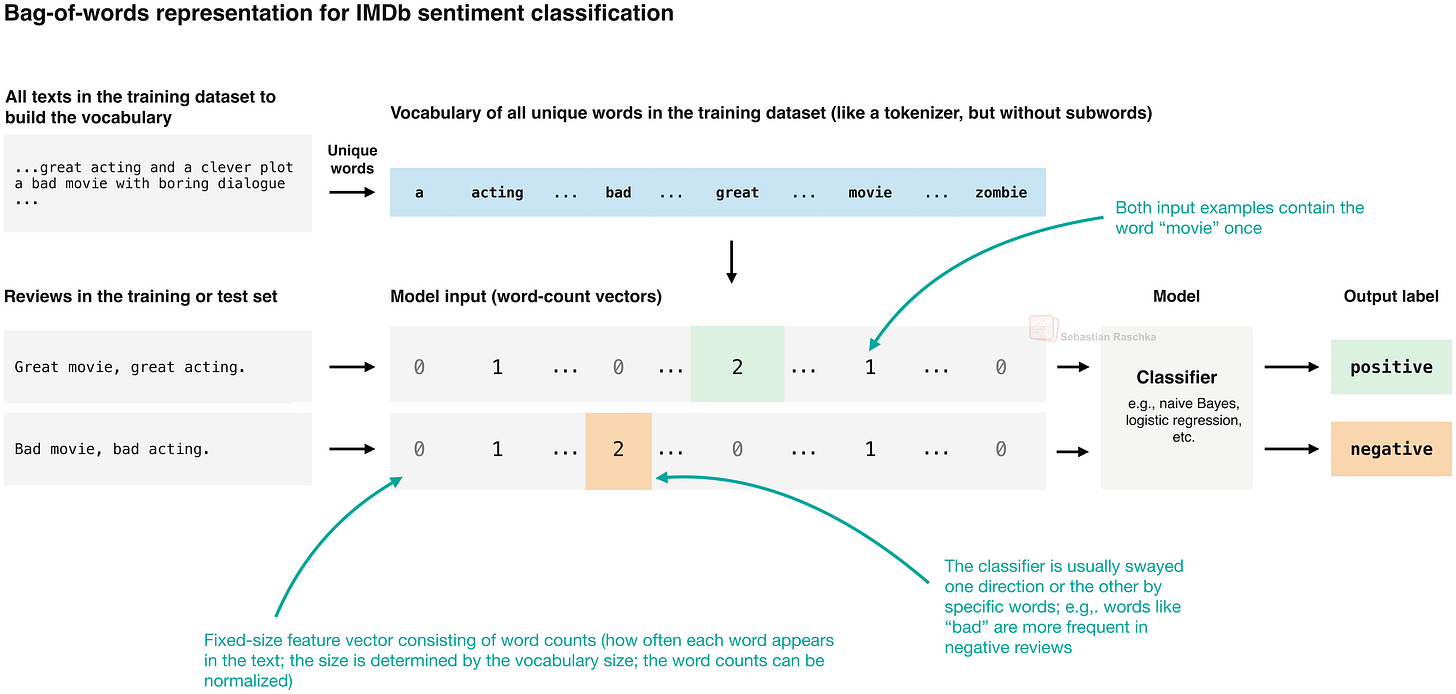
在深度学习统治之前,文本分类主要依赖于词袋模型。这种方法的核心理念非常直观:它将不同长度的自由文本转换为计算机可以处理的固定大小向量。
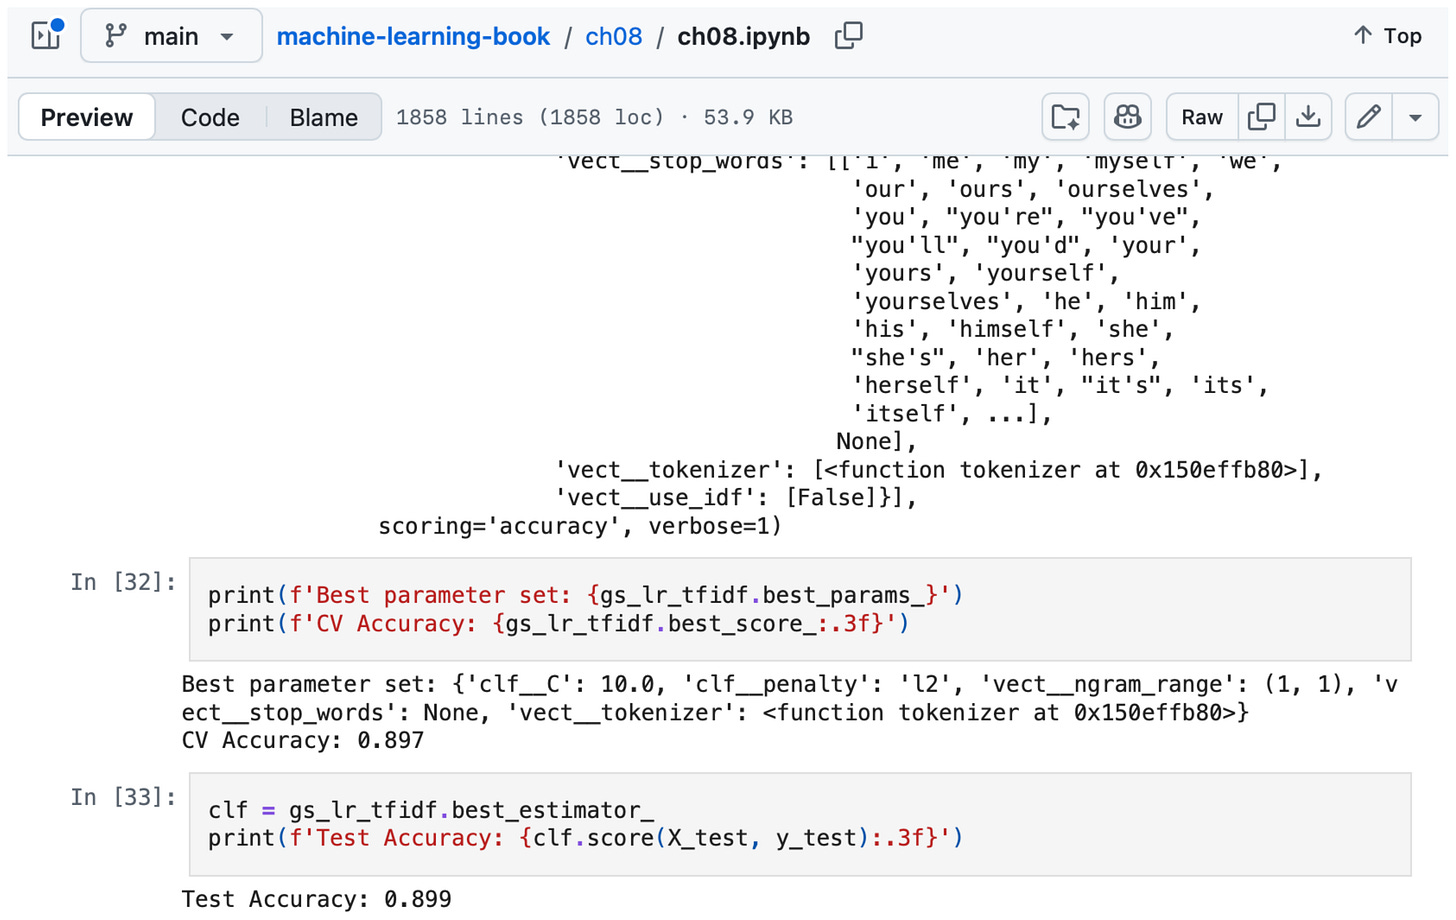
它是如何工作的? 词袋模型通过统计文本中单词出现的频率,忽略语法结构和词序,仅关注词汇的集合。这使得它能够与经典的机器学习算法(如朴素贝叶斯、逻辑回归、支持向量机 SVM 和随机森林)无缝兼容。
实际应用价值: 这种简单的方法在处理中等规模数据集时往往能取得不错的效果。一个经典的案例是早期的 Gmail 邮件垃圾过滤器,它正是基于朴素贝叶斯算法配合词袋模型实现的。对于开发者而言,如果你面临的是一个结构清晰、数据量适中的分类任务,词袋模型或其变种(如 TF-IDF)依然是一个高效、低成本的起点。
2. 深度学习与大模型时代的到来
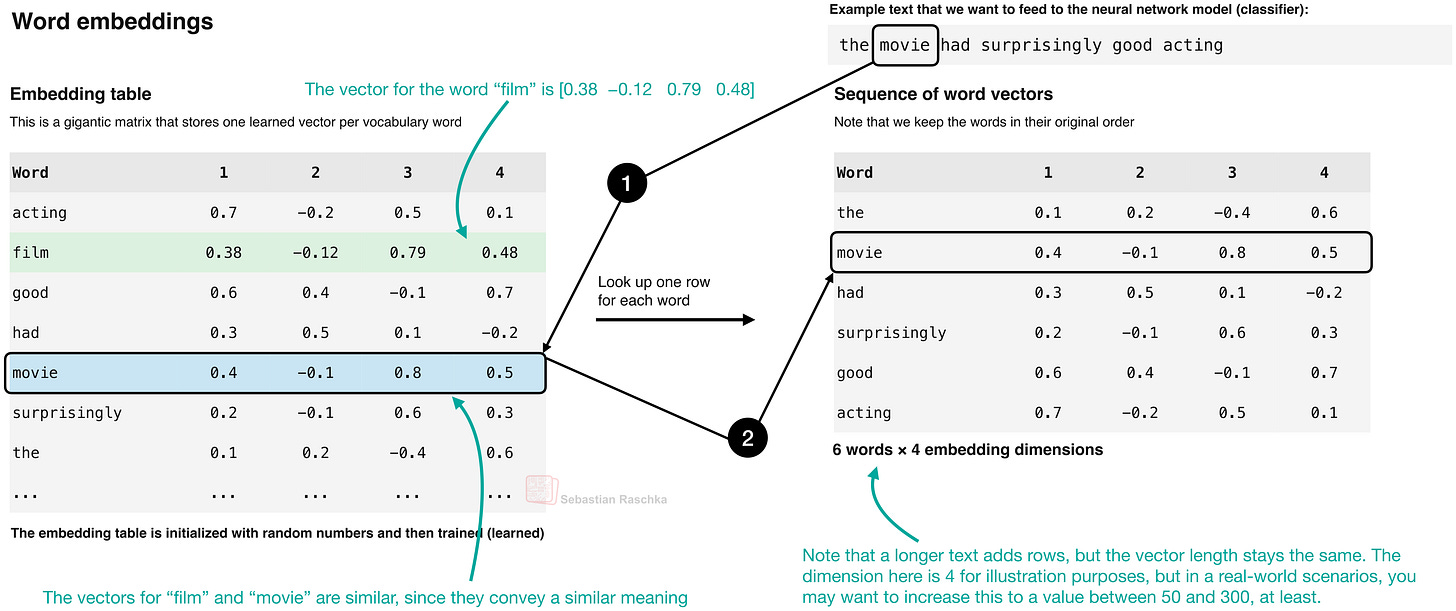
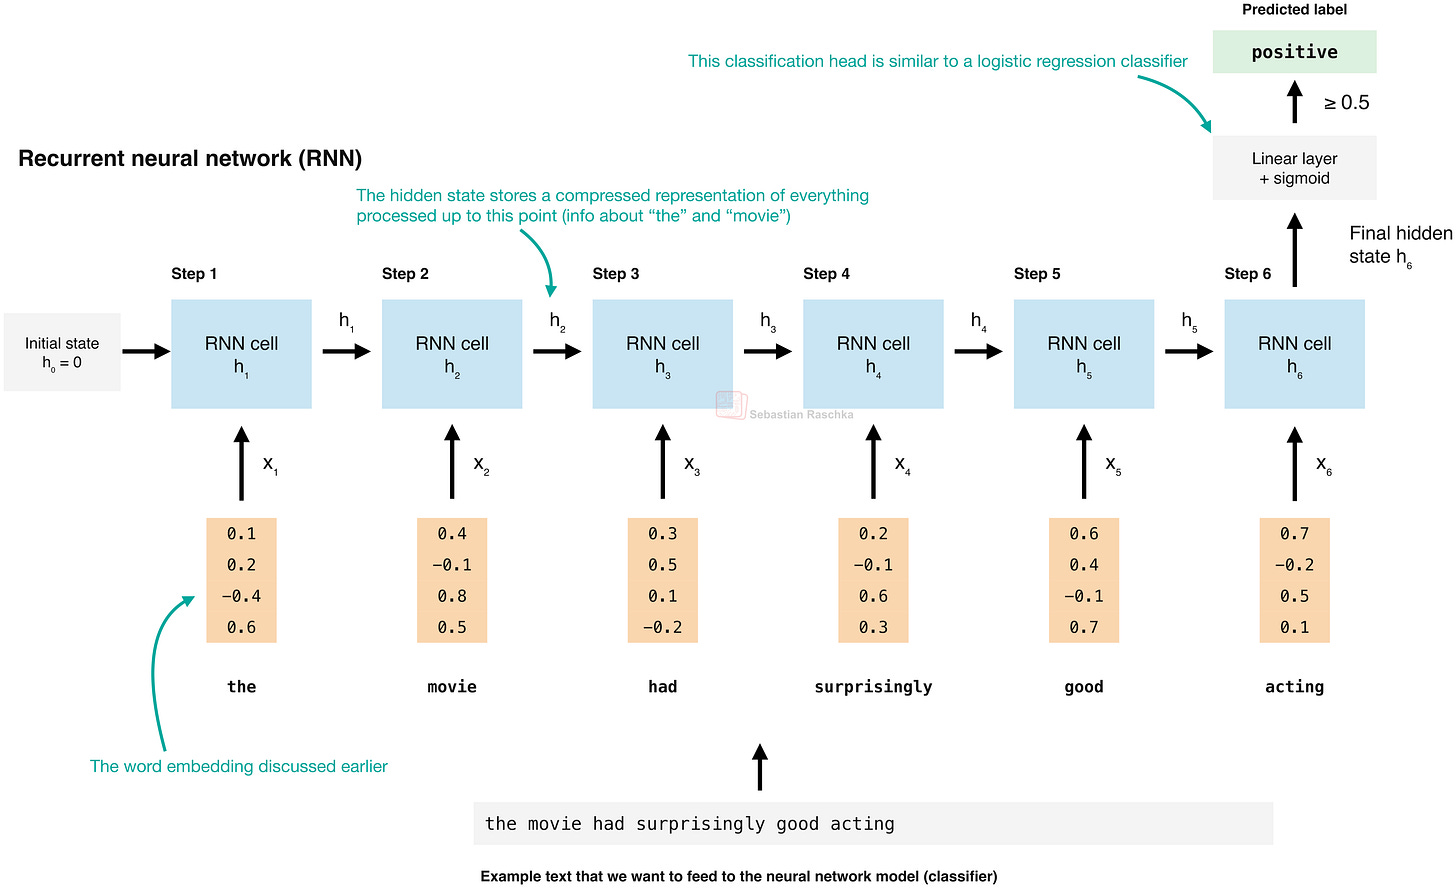
随着技术的发展,循环神经网络(RNN)和卷积神经网络(CNN)开始介入,它们能够捕捉文本中的上下文信息。随后,Transformer 架构的出现彻底改变了自然语言处理(NLP)的格局,大语言模型(LLM)如 GPT 系列横空出世,具备了强大的通用决策能力。
3. Jev 模型:通用分类的新选择
Jev 模型的出现,为开发者提供了一个新的平衡点。虽然 GPT 等大模型也能完成分类任务,但它们通常需要昂贵的算力支持。相比之下,Jev 专注于分类这一细分领域,具有以下显著优势:
- 效率与成本: 在处理分类任务时,Jev 比通用的大模型更快、更便宜。
- 通用性: 虽然针对特定窄问题的专业模型可能更精准,但 Jev 作为“通用分类器”,在处理多样化任务时展现了极高的适应性。
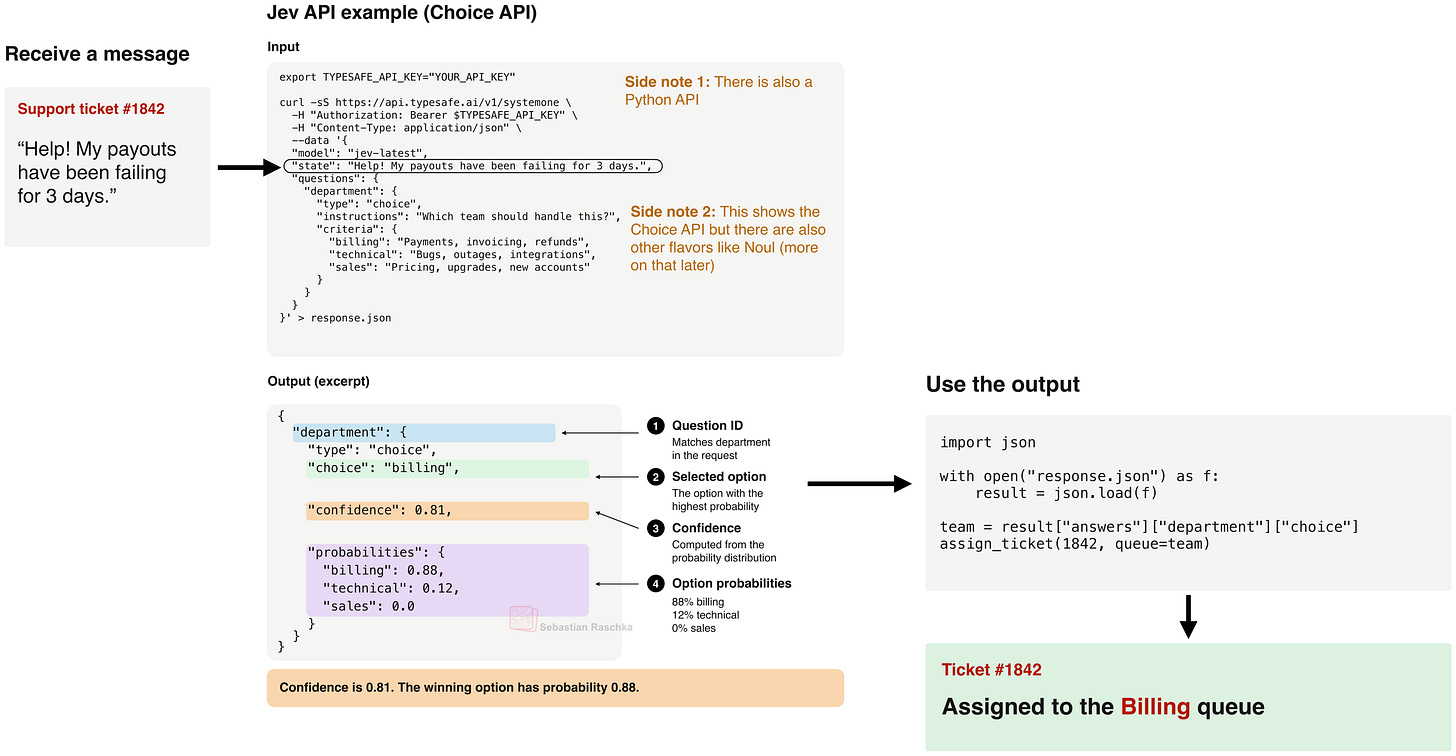
开发者的实用建议: 在构建应用时,不要盲目使用最庞大的模型。如果你的需求仅仅是文本分类(如情感分析、意图识别),Jev 这样的专用 API 往往比直接调用 GPT 更具性价比。只有在需要处理复杂的逻辑推理或多模态任务时,才需要考虑更通用的大模型。
总结
从早期的词袋模型到如今的 Jev API,文本分类技术经历了从简单统计到深度学习的演变。Jev 模型的流行并非偶然,它证明了在垂直领域内,专注的模型往往能带来比通用模型更好的性能与体验。对于开发者来说,理解这些历史脉络,有助于我们在面对具体业务时,做出更明智的技术选型。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:Language Models for Text Classification: From Bag-of-Words to Jev
阅读原文