推理时扩展:提升大模型推理能力的五大策略
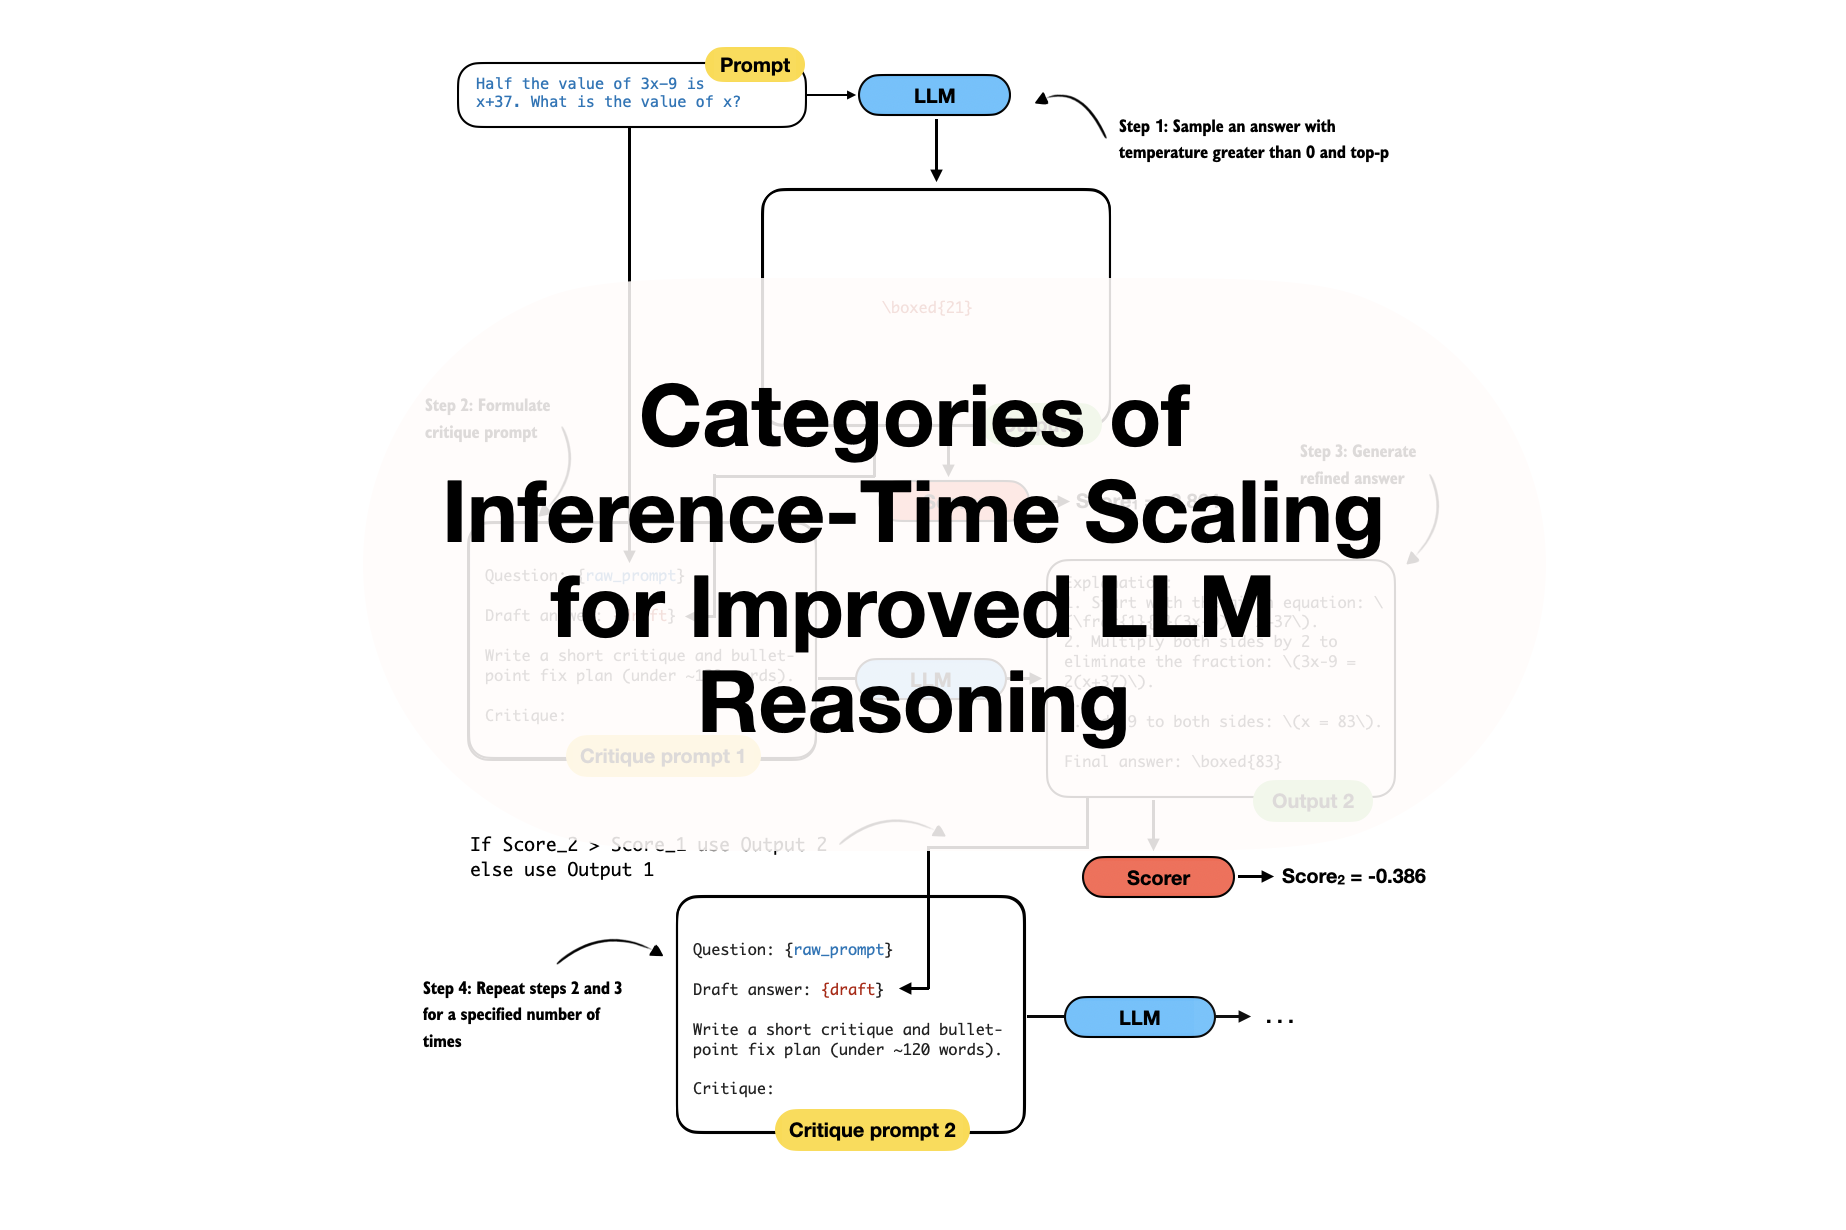
探索推理时扩展技术,通过增加推理阶段的计算资源来提升大模型准确率,无需重新训练模型。
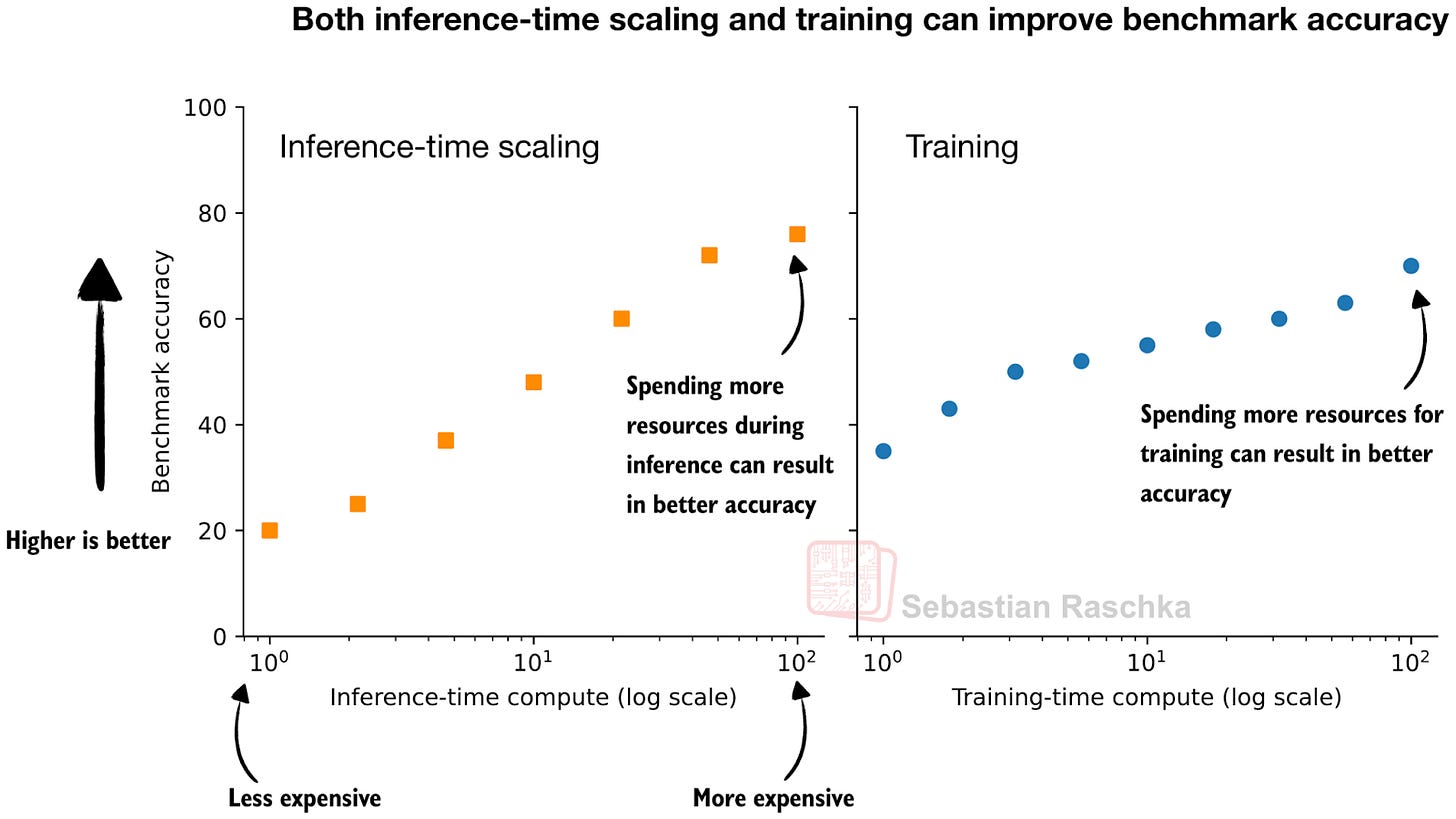
在大语言模型(LLM)的开发与应用中,我们通常认为要提升模型性能,必须增加训练数据或扩大模型规模。然而,近年来出现了一种名为推理时扩展的新范式,它通过在模型生成答案(推理)阶段投入更多的计算资源,在不改变模型权重的前提下,显著提升了答案的准确率。
这种技术的核心理念简单而有效:如果我们愿意在模型“思考”时多花一点时间,就能得到更精准的结果。正如 OpenAI 在其 o1 模型发布时所展示的,通过在推理时增加算力投入,模型在复杂推理任务上的表现有了质的飞跃。
什么是推理时扩展?
推理时扩展也被称为测试时扩展,它是一类无需重新训练模型的方法。简单来说,就是将更多的计算开销从训练阶段转移到了推理阶段。这与传统的集成学习方法异曲同工——虽然运行多个模型更耗资源,但往往能获得更可靠的预测结果。
对于开发者而言,这意味着我们可以直接利用现有的强大模型,通过特定的策略来挖掘其潜力,从而降低获取高性能模型的边际成本。
提升推理能力的五大核心策略
目前学术界和工业界已经总结出多种推理时扩展的具体技术,以下是目前最主流的几种方法及其应用场景:
思维链提示 这是最基础也是最常用的策略。开发者在提问时引导模型“一步步思考”,而不是直接给出答案。这种分步推理的方式能有效帮助模型理清逻辑,解决复杂的数学或逻辑推理问题。
自洽性 为了减少单一输出的随机性,我们可以让同一个模型针对同一个问题生成多次答案,然后通过投票机制选择出现频率最高的答案。这类似于众包决策,能有效过滤掉模型产生的随机幻觉。
最佳 N 排名 这种方法允许模型生成多个候选答案,然后使用一个轻量级的评判器(如另一个模型或规则)对这些答案进行打分,最后挑选出得分最高的那一个。这牺牲了一定的速度,但能确保输出的高质量。
拒绝采样 类似于“试错”。模型生成答案后,由评判器检查其质量。如果答案不达标,则丢弃并重新生成。只有当生成出高质量答案时,才停止该流程。这种方法能保证最终输出的可靠性。
自我精炼与搜索 更高级的策略包括让模型先生成初步答案,然后自我评估或搜索可能的错误,最后对答案进行修正。这模拟了人类解题时的复查过程。
实战价值与总结
对于开发者来说,这些策略的价值在于灵活性。你可以根据应用场景的实时需求,动态调整计算资源的投入。例如,在处理高价值、低容错的任务(如医疗诊断辅助)时,可以启用“最佳 N 排名”或“拒绝采样”;而在追求响应速度的通用场景下,则可使用简单的“思维链”提示。
正如作者在撰写《从零开始构建推理模型》一书章节时所验证的,通过合理组合上述推理时扩展策略,仅仅是在推理阶段增加投入,就能将一个基础模型的准确率从 15% 提升至 52%。这一显著的提升证明了推理时扩展是当前提升 LLM 推理能力最具性价比的途径之一。
结语
推理时扩展技术正在重塑我们对大模型性能的认知。它告诉我们,模型的能力不仅仅取决于训练阶段,更取决于如何被使用。掌握这些策略,将帮助开发者在不增加训练成本的前提下,让现有的模型“更聪明”。
本文基于 Ahead of AI 的公开内容,由 AI 辅助整理改写后发布。
原标题:Categories of Inference-Time Scaling for Improved LLM Reasoning
阅读原文