开源模型处理多数Token,Anthropic仍占六成支出
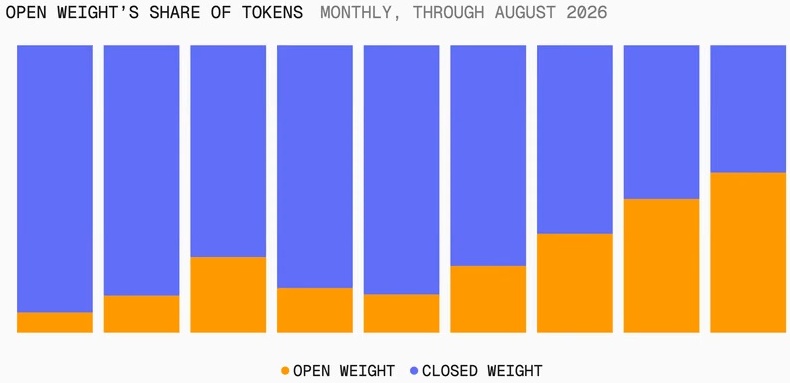
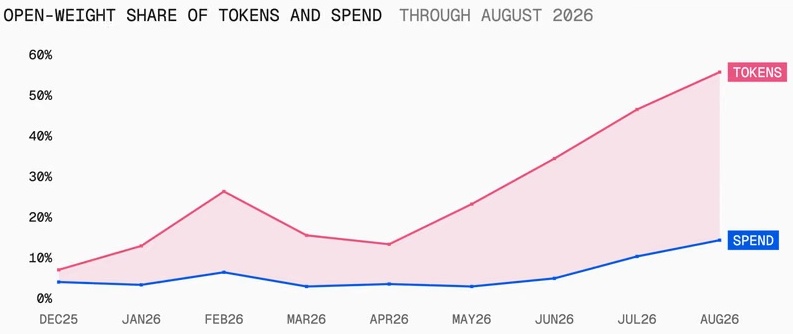
Vercel AI Gateway数据显示,开源模型已处理过半Token量,但Anthropic仍占据64%的支出份额,揭示AI市场用量与花费之间的巨大鸿沟。
开源模型的Token量已过半,但钱花在了哪里?
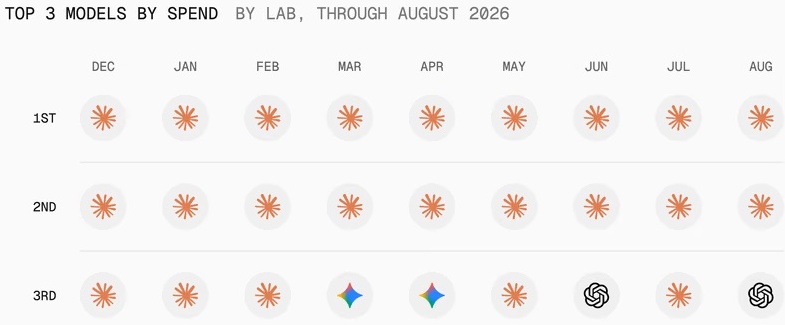
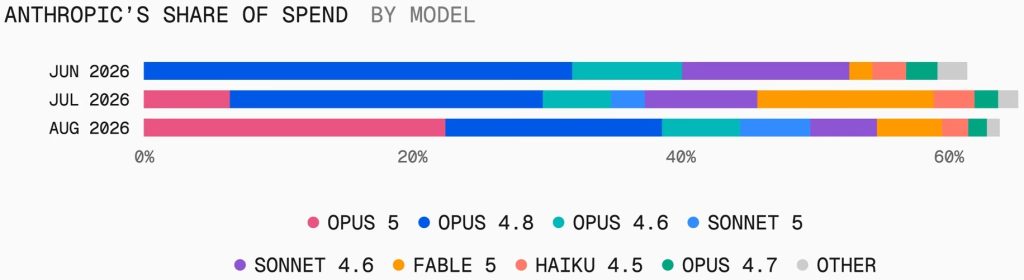
Vercel AI Gateway 的最新数据揭示了一个耐人寻味的现象:开源权重模型已经处理了平台上大多数 Token,但在实际支出方面,Anthropic 一家独占了 64% 的花费。用量与花费之间的巨大落差,值得每一位 AI 开发者认真思考。
Token 量与花费为何脱节?
这个现象的核心在于单价差异。开源权重模型(如 Llama、Mistral、Qwen 等)的推理成本极低,甚至可以在本地部署,每百万 Token 的成本可能只有几美元甚至更低。而 Anthropic 的 Claude 系列模型,尤其是高级版本,定价远高于开源替代品。
这意味着:
- 开源模型胜在"跑量大"——开发者用它们处理大量简单任务,Token 消耗巨大但总花费不高
- 闭源模型胜在"单价高"——虽然调用量可能不如开源模型多,但每次调用的费用远高于前者
这对开发者意味着什么?
1. 成本优化的关键在于任务分级
不是所有任务都需要最贵的模型。一个实用的策略是:
- 简单任务(摘要、分类、格式化)→ 用开源模型,成本几乎可以忽略
- 复杂任务(代码生成、深度推理、长文档分析)→ 用 Anthropic 等闭源模型,质量值得溢价
2. 混合部署已成主流架构
越来越多的团队采用混合推理策略:通过 AI Gateway 统一管理多个模型,根据任务类型自动路由到最合适的模型。Vercel AI Gateway 本身就是这种架构的典型代表。
3. 开源模型正在快速追赶
开源模型处理多数 Token 这一事实说明,它们在大多数日常场景中已经足够好。随着开源模型质量的持续提升,这个 Token 占比还会继续扩大。
Anthropic 为何能守住 64% 的支出?
Anthropic 的高支出占比反映了几个现实:
- Claude 模型在复杂推理和代码生成上仍有优势,企业级用户愿意为质量付费
- 企业级合规和安全需求让很多组织选择闭源模型,即使成本更高
- API 的便利性和稳定性也是付费的隐性成本,本地部署开源模型需要额外的工程投入
给开发者的实操建议
| 场景 | 推荐策略 | 预期成本影响 |
|---|---|---|
| 高吞吐简单任务 | 开源模型(Llama 3、Qwen 等) | 降低 80%+ |
| 代码生成与调试 | Claude 或开源模型对比测试 | 视质量需求而定 |
| 长文档分析 | 根据文档复杂度选择 | 中等任务用开源即可 |
| 生产环境关键路径 | 闭源模型 + 开源模型降级方案 | 平衡成本与可靠性 |
总结
开源模型在 Token 量上的主导地位证明它们已经具备了处理绝大多数 AI 工作负载的能力。但 Anthropic 占据 64% 支出则说明,在质量敏感型场景中,闭源模型仍有不可替代的价值。对于开发者而言,理解这个分化,合理分配模型使用策略,是控制 AI 成本、同时保证质量的关键。
本文基于 The New Stack 的公开内容,由 AI 辅助整理改写后发布。
原标题:Open-weight models now handle a majority of tokens on Vercel’s AI Gateway. But Anthropic still takes 64% of the spend.
阅读原文