开源大模型架构分析实战指南
面对日益简略的技术报告,开发者如何通过 Hugging Face 和 Transformers 库深入理解开源 LLM 的内部结构?本文分享了一套实用的手动分析工作流。
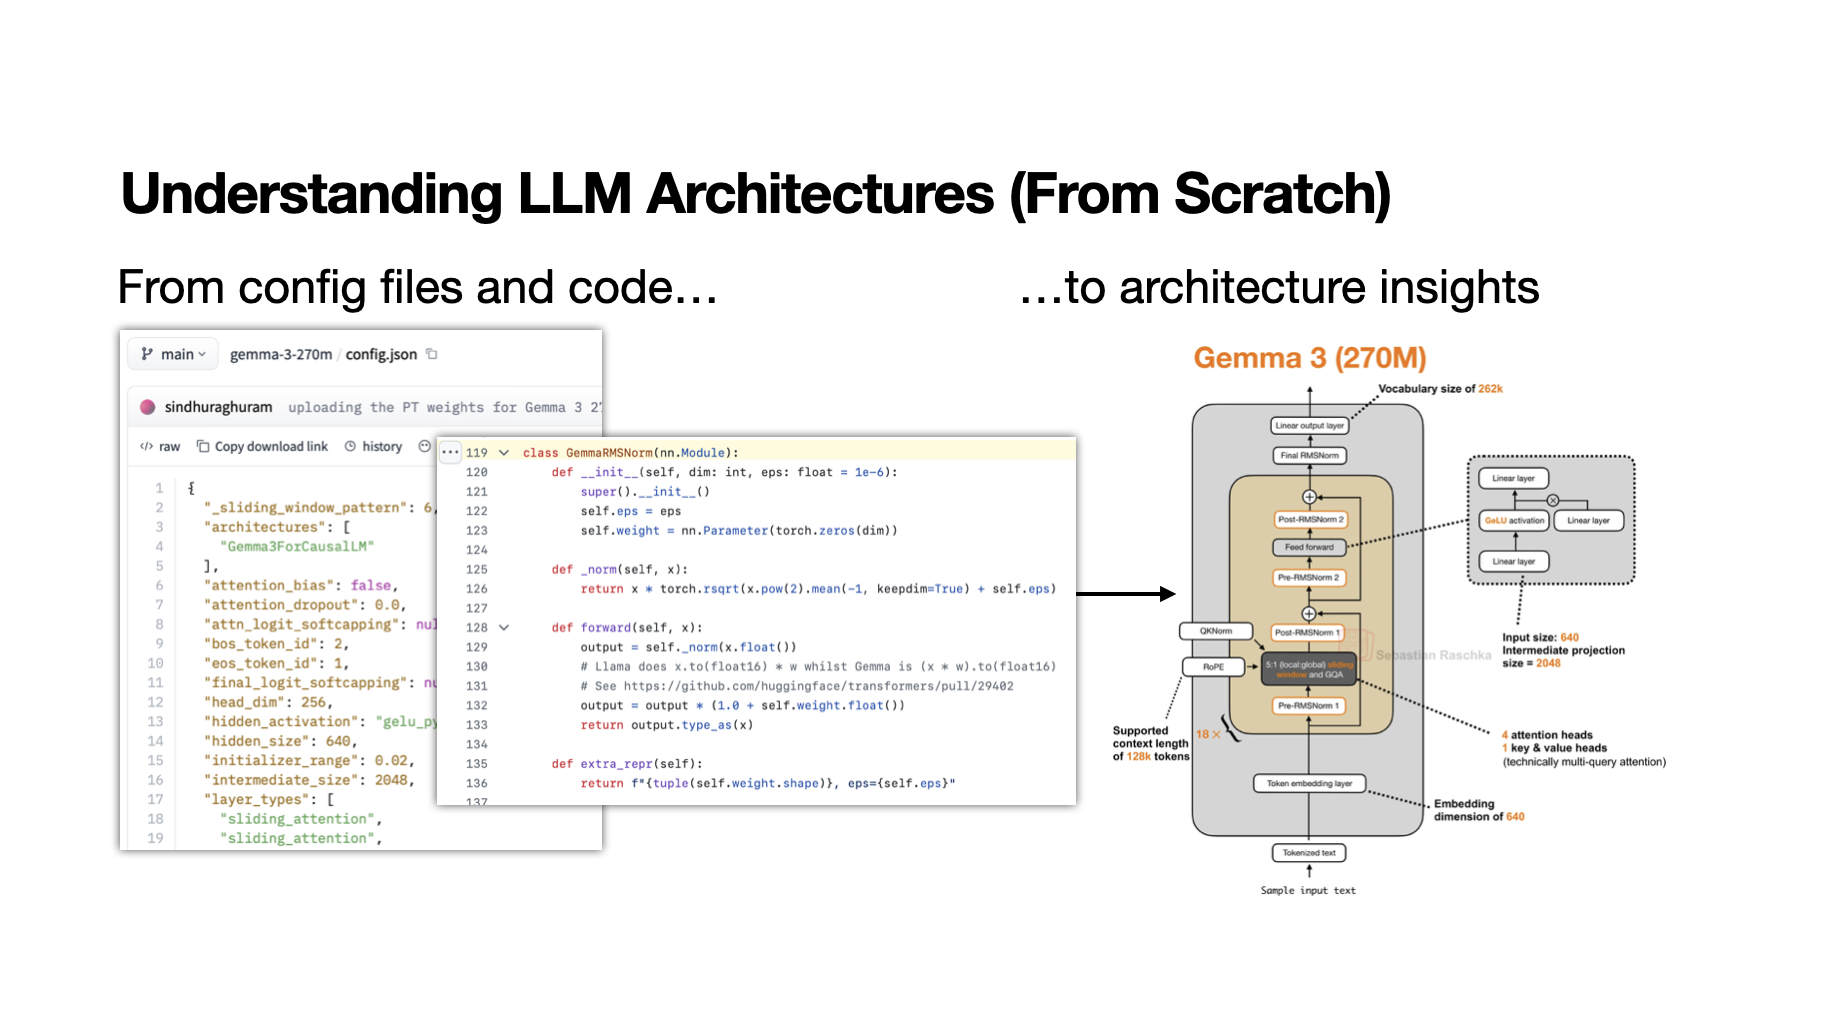
随着开源大模型(LLM)的爆发式增长,开发者们面临着一个普遍痛点:官方发布的技术报告往往不如以前详细,尤其是工业界实验室发布的开源模型,往往只给出高层摘要而缺乏底层实现细节。作为一名科技编辑,我深受 Sebastian Raschka 博文的启发,总结了一套从代码入手、反向推导架构的高效工作流。这套方法不仅能帮你理清模型结构,更是理解 AI 内部运作机制的最佳实践。
核心工作流:从“纸上谈兵”到“代码实战”
传统的架构分析通常从阅读论文开始,但在当前环境下,单纯依赖官方文档往往只能得到模糊的概览。我的工作流主要包含以下三个关键步骤:
从官方报告起步,但不迷信报告 官方技术报告是了解模型设计意图的起点,但请记住,现在的许多报告为了简洁,省略了具体的网络拓扑细节。因此,不要把报告当作唯一的真理来源。
利用 Hugging Face Model Hub 查找权重 如果该模型在 Hugging Face 上开源了权重,那么它就是我们可以深入研究的对象。公开的权重意味着我们可以获取模型的所有参数配置。
深入 Transformers 库的参考实现 这是工作流中最关键的一步。Hugging Face 的
transformers库通常会提供官方的 Python 参考实现。“工作”的代码不会撒谎,它展示了模型在计算过程中实际如何处理数据流、层与层之间的连接方式以及具体的算子实现。
实操细节:如何通过配置文件“透视”模型
在掌握了上述框架后,具体的分析过程其实非常“硬核”且有趣。开发者可以通过以下方式获取具体信息:
- 检查配置文件:在 Hugging Face 的模型仓库中,通常包含一个
config.json文件。这是模型的“身份证”,里面详细记录了层数、隐藏维度、注意力头数量等核心超参数。 - 阅读源码:打开
transformers库中对应的模型文件(如modeling_XXX.py),通过阅读源码来追踪数据是如何经过每一层 Transformer Block 的。相比于论文中抽象的数学公式,代码能让你看到更真实的实现细节。
为什么坚持“手动”分析?
在这个自动化工具盛行的时代,为什么我建议你保留这套手动工作流?
- 深度学习:亲手阅读代码、理清数据流向,是理解模型架构最扎实的方式。这种过程能强迫你从数学符号回归到代码逻辑。
- 发现隐含细节:代码中往往包含论文未提及的工程细节和边界条件处理,这些往往是模型性能优化的关键。
适用范围与注意事项
这套工作流主要适用于开源权重模型。对于 ChatGPT、Claude 或 Gemini 这类闭源模型,由于其权重和底层细节属于商业机密,我们只能通过 API 进行黑盒调用,无法进行架构层面的分析。
总结
理解 LLM 架构不再仅仅是阅读论文。通过结合官方报告、Hugging Face 配置文件以及 Transformers 源代码,我们可以构建起一套完整的知识体系。这不仅有助于开发者更好地使用模型,更能培养从工程视角审视算法的能力。
如果你正在研究新的开源模型,不妨尝试这套“代码溯源法”,你会发现一个更清晰的 AI 世界。